文章链接:Embedding_IC
Introduction
本文基于Network Embedding优化了传统的独立级联模型(IC),用以学习一个更具鲁棒性的扩散概率。
对于网络和社交数据,分析用户交互来为扩散现象建模具有以下困难:
- 用户通常是异质的,伴随着不同的行为或兴趣。并且他们通过各种通道同时交互。
- 用户之间的关系很难检测和表征。 例如,在信息传播过程中,不经常交互的用户之间的“弱关系”很重要,而它们很难被捕获。
- 不同应用中的级联长度变化很大,难以学习和预测。
本文的目的是通过从观察中学习来开发扩散模型。为此,本文专注于独立级联模型(IC),该模型定义了网络中的扩散迭代过程。在这种情况下,建模扩散的问题归结为__学习表征用户间隐含的相互影响关系的概率分布__,以便发现网络的主要通信通道。我们在此考虑的模型执行以下假设:
- 影响传播是二元的(被感染或不被感染),
- 扩散网络未知,
- 影响关系不依赖于传播的内容,
- 用户之间的感染概率不会随时间变化(一旦分配了两个节点间的感染概率,那么该概率固定)。
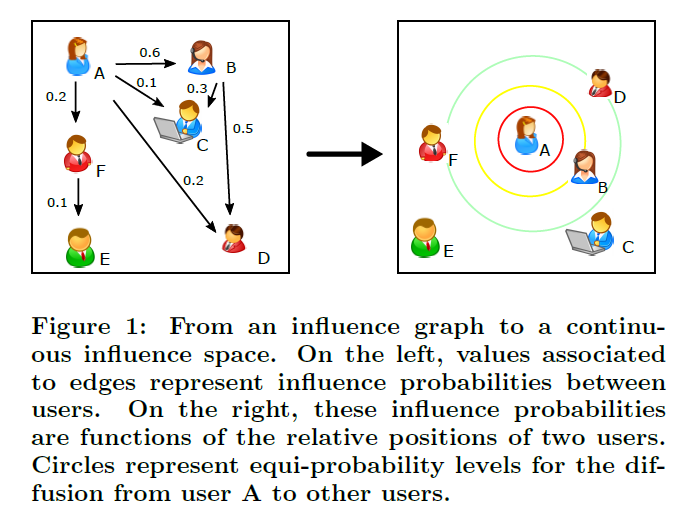
本文基于NE,将扩散空间建模为一个连续的潜在空间,用户间的相对位置用于定义内容传输的可能性。用户靠的越近,传播概率越高。如下图所示:
Model
Notations
传播事件集$\mathcal{D}={D_1,D_2,…,D_n}$ 可以视为一个graph中的$n$个级联(cascade)。其中,一个传播事件$D$是一个带有时间戳的用户集。值得注意的是,级联中的用户并不知道是谁传染它,仅知道它何时被传染。
给定一个社交网络,有$N$个用户:$\mathcal{U}={u_1,u_2,…,u_N}$,一个传播级联$D$可以定义为user和它的timestamp的集合:$D = {(u,t^D(u)) | u \in \mathcal{U} \wedge t^D(u)< \infty}$, 其中,$t^D: \mathcal{U} \to \mathbb{R}^+$ 表示用户被传染的时间戳, $\infty$表示未被传染的用户。每个用户的时间戳$t^D$表示该用户相对于源用户(source user)被传染的时间,$t^D(source \quad user) = 0$。接下来,用$D(t)$表示在时间戳$t$之前被传染的用户:$D(t) = {u \in \mathcal{U} | t^D(u)<t}$。对称地,用$\bar{D}(t)$表示在时间戳$t$之前没有被感染的用户。 $D(\infty)$表示最终所有被感染的用户,$\bar{D}(infty)$表示最终所有没被感染的用户。
Diffusion Model
本文将级联embed到连续空间中,用以捕获扩散关系的规律性。本文只考虑传播的顺序,而不是确切的感染时间戳。
在Embedding_IC中,在一个传播事件(级联)$D$中,一个用户是否被感染的概率取决于先前所有已经被感染的节点。给定一个已经被影响的用户集$I \in \mathcal{U}$, $P(v|I)$表示给定活跃用户集$I$时,节点$v$被传染的概率,其中$v \in \mathcal{U} \backslash I$: $$ P(v|I) = 1-\prod_{u \in I}(1-P_{u,v}) $$ 上式中,$\prod_{u \in I}(1-P_{u,v})$表示$I$中所有节点都不影响$v$的概率。那么$P(v|I)$就可以表示$v$被感染的概率。
接下来就需要给出$P_{u,v}$的定义了,即$v$被$u$传染的概率。$z_u \in \mathbb{R}^d$是传染源用户$u$的表示向量,$\omega_{v} \in \mathbb{R}^d$是传染目标用户$v$的表示向量。那么$P_{u,v}$可以定义如下: $$ P_{u,v} = f(z_u,\omega_{v}) $$ 其中,$f: \mathbb{R}^d \times \mathbb{R}^d \to [0,1]$,是一个映射函数,把两个表示向量映射到概率空间: $$ f\left(z_{u}, \omega_{v}\right)=\frac{1}{1+\exp \left(z_{u}^{(0)}+\omega_{v}^{(0)}+\sum_{i=1}^{d-1}\left(z_{u}^{(i)}-\omega_{v}^{(i)}\right)^{2}\right)} $$ 其中,$z_{u}^{(i)}$和$\omega_{v}^{(i)}$分别表示$z_u$和$\omega_v$的第$i$个分量。表示随距离增加而递减的传输概率,即$\left(z_{u}^{(i)}-\omega_{v}^{(i)}\right)$越大$f$越小。上式使用了sigmoid函数:$\frac{1}{1+e^{-x}}$返回一个$[0,1]$的概率。
值得注意的是,偏置项$z_{u}^{(0)}$和$\omega_{v}^{(0)}$的作用是反映$u$传入$v$的一般趋势,这样做的目的是避免不同的$u$和$v$产生相同的概率。
Learning Algorithm
考虑所有节点对的传播概率$\mathcal{P}={P_{u,v} | (u,v) \in \mathcal{U}^2}$ (涉及所有节点对)。那么对于特定级联$D$的概率为: $$ P(D)=\prod_{v \in D(\infty)} P_{v}^{D} \prod_{v \in \overline{D}(\infty)}\left(1-P_{v}^{D}\right) $$ 上式中,$\prod_{v \in D(\infty)} P_{v}^{D}$表示$D$中所有被影响的用户存在的概率,$\prod_{v \in \overline{D}(\infty)}\left(1-P_{v}^{D}\right)$表示$D$中所有未被影响的用户存在的概率。所以$P(D)$就是级联$D$存在的概率。同时,可以用对数似然来表示训练级联集$\mathcal{D}$: $$ \mathcal{L}(\mathcal{P} ; \mathcal{D})=\sum_{D \in \mathcal{D}}\left(\sum_{v \in D(\infty)} \log \left(P_{v}^{D}\right)+\sum_{v \in \overline{D}(\infty)} \log \left(1-P_{v}^{D}\right)\right) $$ 上式就是模型的目标函数。