图神经网络的预训练任务和下游任务之间可能存在较大gap,直接将预训练模型应用在下游任务上可能会产生负迁移现象(“negative transfer”)。例如,binary edge prediction经常用于pretrain graph model。这样的预训练模型使得有边连接的节点在representation space中接近。但是下游任务可能是node-level 或graph-level tasks,下游的任务如果是节点分类任务,那么预训练模型需要针对额外的节点类别标签搜索更高维度的参数空间。如果图中相连节点的类别不同(heterophilic),那么基于edge prediction pretrained的模型会对下游任务参数负面效果。
为了解决上述问题,一个潜在的方向是将“pretraining and fine-tuning”拓展为“pretraining, prompting, and fine-tuning”。例如在自然语言处理中,如果要赋予预训练语言模型预测句子情感的能力(sentiment analysis),可以通过prompt来完成,而不需要优化pretrained model。
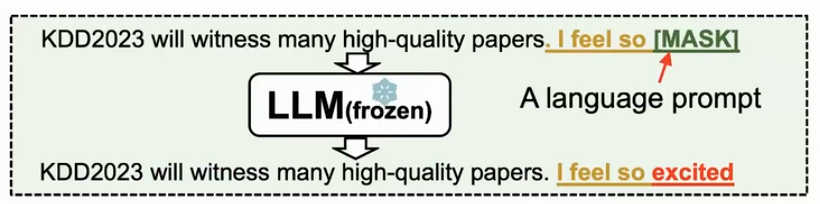
以上图为例,对于一个fronzen LLM(参数固定),如果要为这个模型赋予情感分析的能力,我们可以额外训练一个最佳的prompt,训练数据为prompt parameters,要求这个prompt tokens在tasker $\phi$的优化下,生成的下一个token是正确的情感(label为excited)。即训练得到一个最佳的prompt tokens,比如训练得到的最佳prompt tokens是“I feel so [mask]”,使得frozen LLM应用在“KDD2023 will witness many high-quality papers. I feel so ” 这个句子上时,可以将下一个词预测为情感词,这样LLM在输入包含prompt tokens的情况下,可以具备预测句子情感的能力。也就是说, Prompt Learning的目的是训练得到一堆tokens,使得这些tokens与原来的context拼起来可以使得LLM具备新的能力。
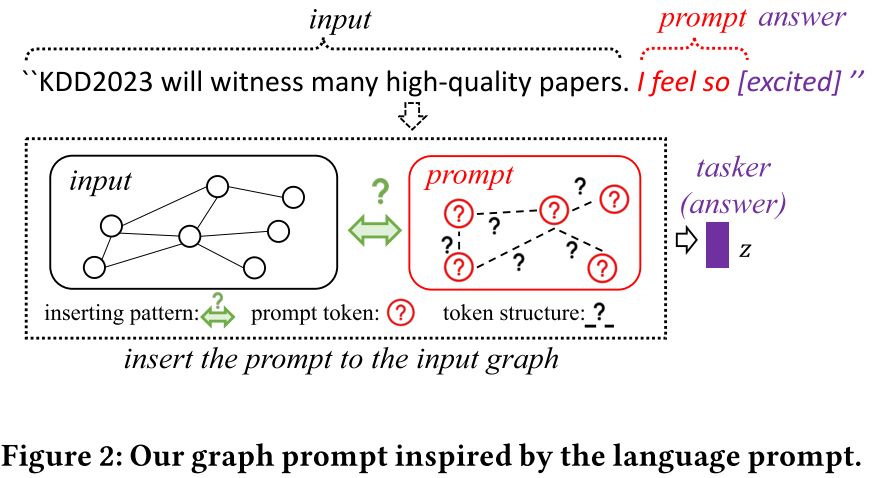
这篇文章的目的是在图上做Prompt Learning,也就是在训练一个prompt graph,使得现有图拼上这个prompt graph后,预训练的GNN可以在新的任务上(预训练阶段没有接触过的任务上)也表现的较好。 但是在graph上做Prompt Learning存在以下挑战:
- 自然语言处理中,prompt tokens是一个一维线性的句子,可以放在content的开头或结尾,但是在graph中,节点是非欧结构,因此如何组织prompt tokens,以及如何将graph prompts与input graph结合是一个挑战。
- 在自然语言处理中,类似于情感分析,和问答任务,这些任务都可以简单的重构为next token prediction(单词预测)的任务,所以只需要使用单词预测来训练prompt就可以。但是在图中,节点级任务、边级任务和图级任务难以统一成一种形式。因此如何将各种prompt任务统一来训练graph prompt也是一个挑战。
训练好prompt token的向量化信息、连接结构、以及插入到原图的方式,然后Frozen Pretrained Model应用在这个combined graph上后,就可以为Pretrained Model赋予处理新任务的能力。
Reformulating Downstream Tasks
将节点级和边级的下游任务统一为induced graph的标签预测问题。
对于节点预测任务,将它重构为图分类任务:
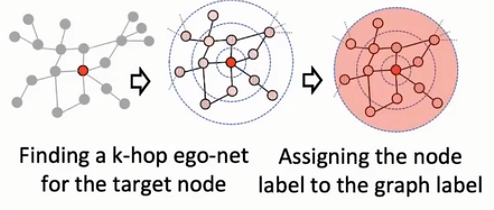
将节点标签设置为它的 $k$-hop诱导子图的标签。
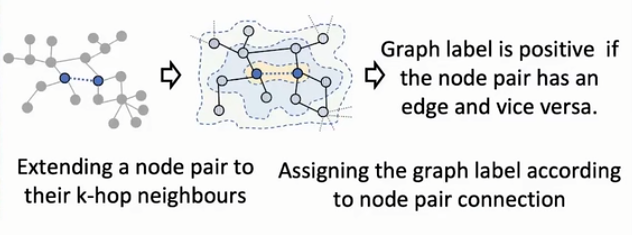
将边预测(存在性预测和类别预测都可以,即二分类和多分类)任务也重构为图分类任务,如下:
Prompt Graph Design
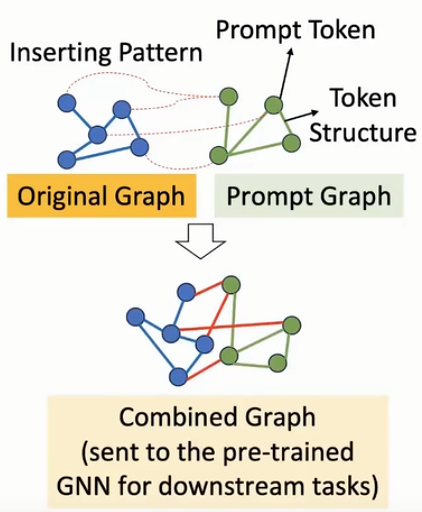
Prompt Tokens 首先Prompt graph 定义为 $\mathcal{G}_p(\mathcal{P},\mathcal{S})$,其中每个token $p_i \in \mathcal{P}$是Prompt graph中的节点,它的特征是 $\mathbf{p}_i$,维度与node features相同。
Token Structures 每个tokens的特征 $\mathbf{p}_i$是随机初始化可学习的,然后可以通过计算相似度并用sigmoid和相应的阈值来控制 $\mathcal{G}_p$的结构。然后可以计算 $\mathbf{p}_k$和节点 $\mathbf{x}_i$之间的相似度来确定该prompt node如何将自身信息与节点 $\mathbf{x}_i$的信息结合,来赋予预训练模型处理节点 $i$相应任务的能力。 $$ w_{i k}= \begin{cases}\sigma\left(\mathrm{p}_k \cdot \mathrm{x}_i^T\right) & \sigma\left(\mathrm{p}_k \cdot \mathrm{x}_i^T\right)>\delta \\ 0 & \text { otherwise }\end{cases} $$
通过 $\hat{\mathbf{x}}_i=\mathbf{x}_i+\sum_{k=1}^{|\mathcal{P}|} w_{i k} \mathbf{p}_k$ 来为节点 $i$添加提示。
如何训练 Prompt Graph,使其可以作为预训练模型的有效提示:Multi-task Prompting via Meta Learning
学习最好的Prompt,使得该Prompt可以帮助Pretrained Model更好的适应下游任务。
Phase 1 有一些 Source Task去训练Prompt 的初始值。
Phase 2 对Target Task做测试。
具体来说,首先对于要训练的prompt graph $\theta$ (即所有token的特征)让它在多个training task上训练,如下图所示,又3个节点分类的tasks,每个tasks里又自己的训练集(support set)和测试集(query set)。每个task都有一个共同的起点,在几个tasks上训练上训练后,每个tasks上有个优化后的task-specific prompt (Prompt 1, Prompt 2, Prompt 3)。
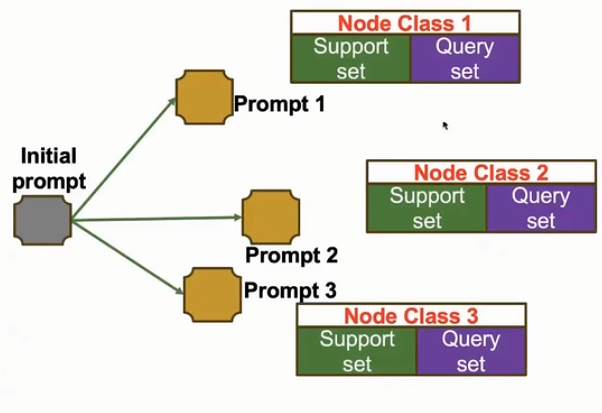
在更新了之后,评估组合起来的Prompt是否会让整体的性能更好,如下图所示,把所有task-specific prompt组合起来,来看组合后的prompt是不是足够好。
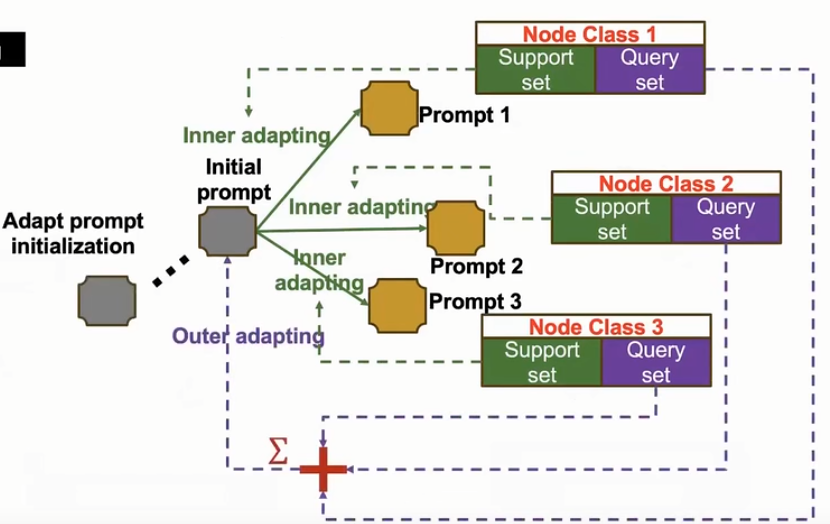
如果当前的Initial prompt训练出来的模型在三个tasks上不够好,那么换一个Initial Prompt,直到某个Initial Prompt在所有training tasks经过训练后都表现的较好时,就说明这是一个 较好的初始prompt (训练起点),它适合做training tasks的初始化prompt。
在Meta Training 结束后,我们可以得到一个较好的prompt初始化值,即上图中的Adapt prompt initialization。
在Meta Testing阶段,将我们通过Training Tasks学到的最佳初始Prompt在Test tasks的support set上做微调,然后在Test Task的query set上验证prompt initialization的效果。
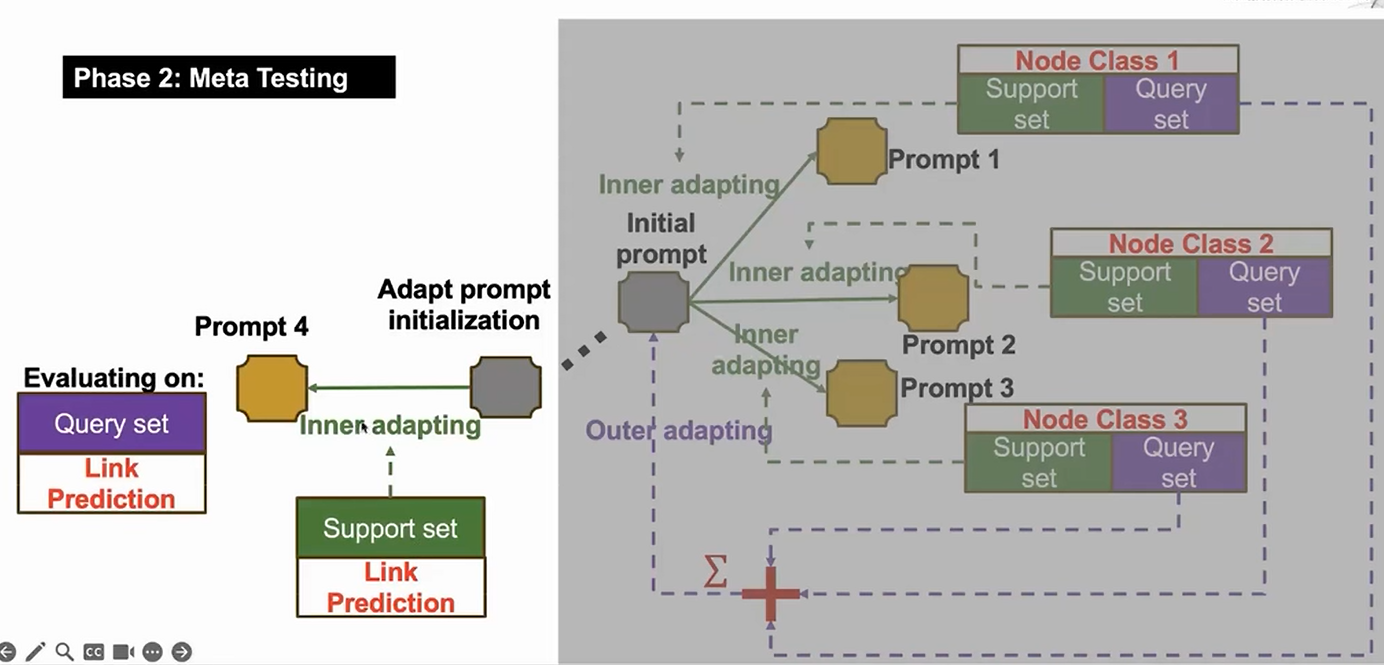
通过上面方式得到的prompt可以作为graph prompt与input graph 结合,使其具备link prediction和node classification的能力。
可以看作时学习一个图增强,使得预训练的图模型在这个增强图上可以适用于更多任务。