Introduction
对于监督对比学习(Supervised Contrastive Learning, SupCon), SupCon loss旨在表示空间中拉近属于同一个class的数据点,分离不同类的数据点。 但是SupCon难以处理高类内方差,类间相似度较大的数据集。为了解决该问题,本文提出了Cluster-aware supervised contrastive learning loss (ClusterSCL)。什么是高类内方差,高跨类相似度问题?如图1(a)所示,节点$u_1$和$u_3$ 是同类节点,$u_2$和$u_4$是同类节点。他们是同类节点但在不同的社区中,所以类内方差较大,即同一个类内的节点跨越了多个community。 另外$u_1$和$u_2$, $u_3$和$u_4$,是不同类的节点对, 但他们处在同一个社区中,导致在MPNN过程中,这些处在同一个community中的不同类节点被拉近,导致跨类相似度较高的问题。
如果对节点$u_2$计算SupCon时,如图1(b)所示,SupCon会使得同类节点被拉近,如$u_2$和$u_4$会被拉近。但是$u_3$和$u_4$处在同一个社区中(structurally similar)那么MPNN会使得$u_3$和$u_4$被拉近,所以SupCon在拉近$u_2$和$u_4$的同时,会间接拉近不同类节点$u_2$和$u_3$。同时,对于构成negative pairs的不同类节点,例如$u_1$和$u_2$,SupCon会推远$u_1$和$u_2$,但是$u_1$和$u_5$ structurally similar, 因此会推远$u_1$和$u_2$会间接导致$u_2$和$u_5$这两个同类节点被推远。因此对于一个cluster内节点不同类,且不同cluster中存在同类节点的情况,会导致复杂的决策边界,即在拉近同类但不同社区的节点时,也会间接拉近不同类不同社区的节点。在推远不同类同社区的节点时,也可能间接推远同类同社区的节点。
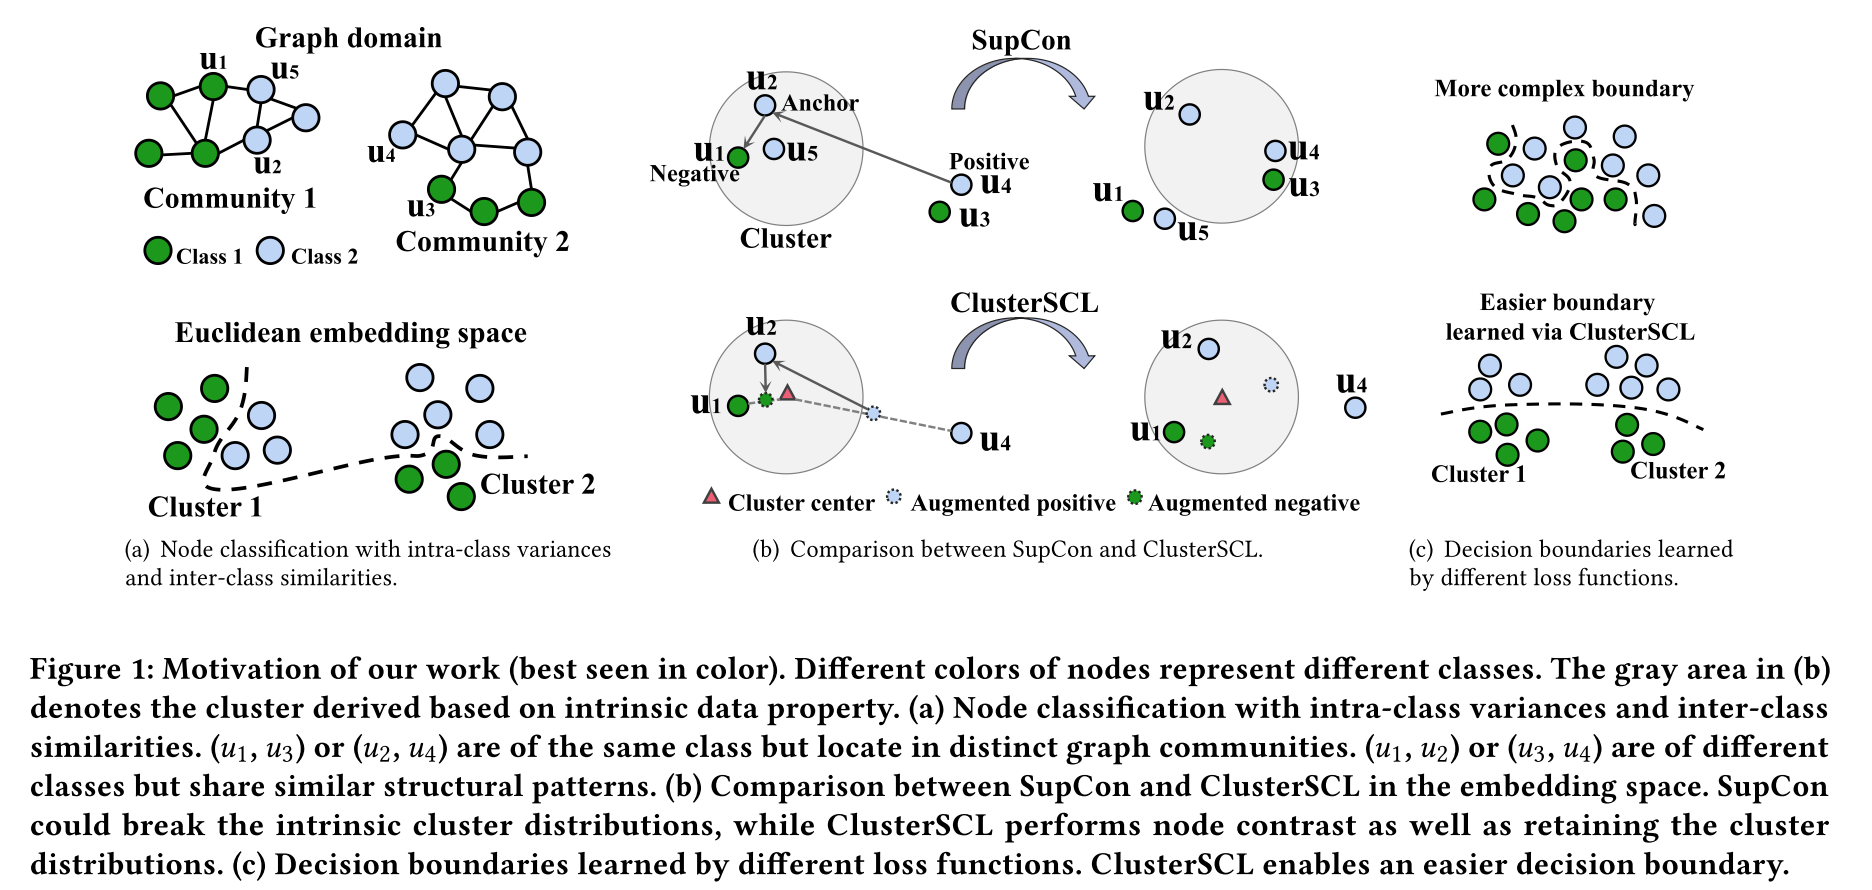
为了解决上述问题,最直接的方法是对于每个cluster,如图1(a)的Community 1,不考虑其他cluster,只对当前cluster内节点做SupCon。但是这么做忽略了跨cluster的同类节点交互,如$u_1$和$u_3$,$u_2$和$u_4$,这些跨cluster的positive pairs可能包含有益的信息。为了解决这个问题,本文提出cluster-aware data augmentation (CDA) 聚类感知的数据增强,来为每个节点生成augmented positives and negatives,如图1(b)中ClusterSCL所示。对于每个节点$u$,为它生成positive 和negative samples, 生成的samples 位于或接近$u$所在的cluster。Recall SupCon存在的问题:
- SupCon会使得$u_2$和$u_4$被拉的太近,从而间接导致$u_2$和$u_3$被拉近,所以对于high intra-class variances,要求不同cluster的同类节点如$u_2$和$u_4$不要被拉太近;
- SupCon会使得$u_1$和$u_2$被推远,从而间接导致$u_2$和$u_5$被推远,所以对于high inter-class similarity,要求同一个cluster内的不同类节点如$u_1$和$u_2$不要被拉的太远。
Method
Two stage training with Supervised Contrastive Loss
SupCon encourages samples of the same class to have similar representations, while pushes apart samples of different classes in the embedding space.
First Stage: 计算node embeddings $H = g_\theta(G)$, 然后用SupCon Loss来训练 $g_\theta$ 。即已经知道训练集中的节点label,基于这些节点label,SupCon在embedding space中把同label的节点拉近,不同label的节点分开。$g_\theta$用于得到node embeddings.
Second Stage:基于学习好的$g_\theta$, 用$\hat{Y}=f_\phi\left(g_\theta(G)\right)$来得到logits/prediction。即用cross-entropy loss来训练$f_\theta$。
SupCon
从同一个类中采样的节点构成positive pairs。batch中随机采样的节点对为negative pairs。给定$N$个随机采样的节点,对于每个节点,从其对应的class中随机采样一个不为它的节点作为positive pairs。所以一个batch有$N$对positive pairs,共$2N$个节点。
用$I \equiv\{1,2, \ldots, 2 N\}$ 表示一个batch中的node indices。$s_i \in I$表示这$2N$个节点中与节点$v_i$属于同一类的节点的indices。如下式所示, 在一个batch中,令$S_i \subset I$表示$2N$个节点中可以与节点$v_i$构成positive pairs的节点集合。相比其他节点,SupCon的objective是拉近positive pairs。 $$ \max \sum_{i \in I} \frac{1}{\left|S_i\right|} \sum_{s_i \in S_i} \log \frac{\exp \left(\mathbf{h}_i^{\top} \mathbf{h}_{s_i} / \tau\right)}{\sum_{j \in I \backslash\{i\}} \exp \left(\mathbf{h}_i^{\top} \mathbf{h}_j / \tau\right)} $$ 但是如果batch中与$v_i$同类的节点$v_j$和它不属于同一个cluster,$v_j$所属的cluster不同类的节点较多,那么拉近他们的距离也会间接拉近$v_i$与不同类节点间的距离。
ClusterSCL
为了解决上述问题,本文提出ClusterSCL。
Cluster-aware Data Augmentation (CDA)
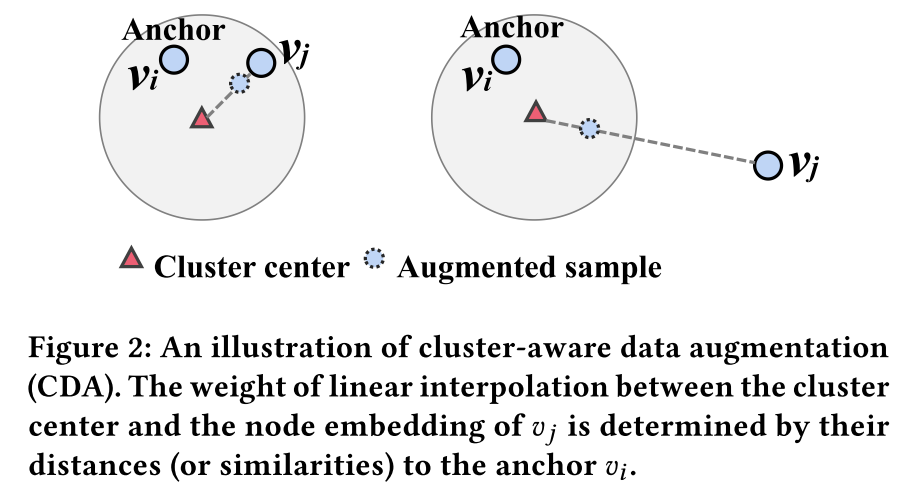
定义隐变量 $c_i$,该隐变量取值范围为$c_i \in \{1,2, \ldots, M\}$ 表示节点$v_i$属于哪一个cluster。给定两个anchor node $v_i$,$v_j$,CDA使用线性插值法为$v_j$生成augmentation: $$ \tilde{\mathbf{h}}_j=\alpha \mathbf{h}_j+(1-\alpha) \mathbf{w}_{c_i} \tag{4} $$ 其中$c_i$指示了节点$v_i$所在的cluster。$\mathbf{w}=\left\{\mathbf{w}_m\right\}_{m=1}^M$ 表示每个cluster的cluster prototypes,即每个cluster的中心,serve to characterize the cluster。$\mathbf{w}_{c_i}$表示节点$v_i$所在cluster的中心表示。$\tilde{\mathbf{h}}_j$包含了节点$v_j$的信息。并且,由于$\mathbf{w}_{c_i}$是$v_i$所在cluster的prtotype,所以通过调整$\alpha$,可以使$\tilde{\mathbf{h}}_j$位于$v_i$所在cluster的附近或内部。
(1)如果$(v_i, v_j)$是一个batch中的positive pair,$v_i$是anchor节点,如果$v_j$位于$v_i$所在的cluster $c_i$内,那么就需要学到的$\mathbf{h}_j$与$\mathbf{h}_i$尽可能靠近。在SupCon中,需要设置较大的$\alpha$使得$\tilde{\mathbf{h}}_j$保留更多$\mathbf{h}_j$ 。对于anchor节点$\mathbf{h}_i$,将它与$\tilde{\mathbf{h}}_j$拉近的时候,由于$\tilde{\mathbf{h}}_j$保留了更多$v_j$特征,所以$\mathbf{h}_j$也会被和$\mathbf{h}_i$拉近。如图2(a)所示。
(2)如果$(v_i, v_j)$是positive pair,如果$v_j$位于$v_i$所在的cluster $c_i$外时,如果$v_j$周围有negative samples (不一定在该batch中),那么直接拉近$(v_i, v_j)$会间接导致潜在的negative samples也会被拉近,因此对于位于$v_i$所在cluster外的节点$v_j$,要求它最终的表示$\mathbf{h}_j$不能被拉的太近,此时就需要小一些的$\alpha$,使得$\tilde{\mathbf{h}}_j$保留少一些$v_j$的信息,那么在SupCon拉近$\mathbf{h}_i$和$\tilde{\mathbf{h}}_j$的过程不会导致$\mathbf{h}_j$被拉近太多。因为$ \mathbf{w}_{c_i}$占据了$\tilde{\mathbf{h}}_j$的大部分,且它与$\mathbf{h}_i$已经很接近。如图2(b)所示。
对于negative pair $(v_i, v_j)$。如果$v_j$位于$v_i$所在的cluster $c_i$内,如果直接推远$\mathbf{h}_i$和$\mathbf{h}_j$,会导致如果$v_j$的邻居有$v_i$的positive sample,那么这个positive sample也会被间接推远。所以$\tilde{\mathbf{h}}_j$应该保留较少的$\mathbf{h}_j$,即$\alpha$应该小。但是本文不考虑negative pairs的这种情况了,直接套用posiive的CDA原则。
综合上面的(1)(2)即对于close positive pairs,要让他们尽可能接近,即$\alpha$要大,对于distant positive pairs,要让他们不要太接近,$\alpha$要小一些。所以$\alpha$应与positive pair之间的相似度相关。所以$\alpha$定义如下: $$ \alpha=\frac{\exp \left(\mathbf{h}_i^{\top} \mathbf{h}_j\right)}{\exp \left(\mathbf{h}_i^{\top} \mathbf{h}_j\right)+\exp \left(\mathbf{h}_i^{\top} \mathbf{w}_{c_i}\right)} $$ 上式分子越大$\alpha$越大,说明对于anchor node $v_i$, 如果的positive sample $v_j$位于它的cluster内($v_i$与$v_j$相似),$\mathbf{h}_j$的augmentation $\tilde{\mathbf{h}}_j$要保留越多自身信息。
Integraging Clustering and CDA into SupCon Learning
目标是给定节点$v_i$以及它所在的cluster 隐变量$c_i$,$v_i$的positive samples $s_i$的cluster-aware SupCon定义为条件概率: $$ \begin{aligned} p\left(s_i \mid v_i, c_i\right) &=\frac{\exp \left(\mathbf{h}_i^{\top} \tilde{\mathbf{h}}_{s_i} / \tau\right)}{\sum_{j \in V \backslash\{i\}} \exp \left(\mathbf{h}_i^{\top} \tilde{\mathbf{h}}_j / \tau\right)} \\ &=\frac{\exp \left(\mathbf{h}_i^{\top}\left(\alpha \mathbf{h}_{s_i}+(1-\alpha) \mathbf{w}_{c_i}\right) / \tau\right)}{\sum_{j \in V \backslash\{i\}} \exp \left(\mathbf{h}_i^{\top}\left(\alpha \mathbf{h}_j+(1-\alpha) \mathbf{w}_{c_i}\right) / \tau\right)} \end{aligned} \tag{6} $$ 即对于positive pair $(v_i, s_i)$,最大化$\mathbf{h}_i$和$s_i$的augmentation $\tilde{\mathbf{h}}_{s_i}$之间的一致性,$\alpha$可以依据$s_i$和$c_i$的关系来调整$\mathbf{h}_{s_i}$对于SupCon的贡献,使得$\mathbf{h}_{i}$与$\mathbf{h}_{s_i}$在位于不同cluster的情况下不会被拉的太近。其中$c_i$是隐变量。
首先定义关于节点$v_i$的cluster分布,即$v_i$属于每个$c_i$的概率。给定anchor node $v_i$,它属于cluster $c_i \in \{1,2, \ldots, M\}$的概率定义为: $$ p\left(c_i \mid v_i\right)=\frac{\exp \left(\mathbf{h}_i^{\top} \mathbf{w}_{c_i} / \kappa\right)}{\sum_{m=1}^M \exp \left(\mathbf{h}_i^{\top} \mathbf{w}_m / \kappa\right)} \tag{7} $$ $\mathbf{w}_{c_i}$是cluster $c_i$的prototype表示,$v_i$属于在embedding空间中与它相似的cluster的概率更高。ClusterSCL旨在最大化给定锚节点$v_i$,锚节点与其positive sample $s_i$的likelihood: $$ p\left(s_i \mid v_i\right)=\int_{c_i} p\left(c_i \mid v_i\right) p\left(s_i \mid v_i, c_i\right) d c_i= \sum^M_{m=1} p(m|v_i)p(s_i|v_i,m) \tag{8} $$ 即给定anchor $v_i$,$s_i$是$v_i$的postive sample的概率为 当$v_i$属于cluster $m$的情况下,$s_i$是其positive sample的概率, over all clusters $m \in M$。
在likelihood Eq.(8)中,anchor node $v_i$ 为待优化参数,它的positive sample $s_i$为观测数据,$c_i$为隐变量。
Maximize likelihood Eq.(8) via EM
Objective: $\mathrm{maximize} \log p(s_i| v_i)$,即最大化positive pairs的条件概率 given anchor node $v_i$。
E-step:$\mathbb{E}_{p(c_i|s_i, v_i)} \log p(s_i, c_i|v_i)$
M-step: $\widehat{v}_i = \arg \max_{v_i} \mathbb{E}_{p(c_i|s_i, v_i)} \log p(s_i, c_i|v_i)$
可见,如果要通过EM算法来优化得到anchor node $v_i$的表示,需要计算后验 $p(c_i|s_i, v_i)$:
$$
\begin{aligned}
p(c_i|s_i, v_i) & = \frac{p(c_i,v_i, s_i)}{p(s_i,v_i)} \\
& = \frac{p(v_i)p(s_i,c_i | v_i)}{p(s_i |v_i) p(v_i)}\\
& = \frac{p(s_i,c_i|v_i)}{p(s_i |v_i)} \\
& = \frac{p(s_i,c_i|v_i)}{\sum^M_{m=1}p(m|v_i)p(s_i | v_i, m)}\\
& = \frac{\frac{p(s_i,c_i,v_i)}{p(v_i)} = \frac{p(c_i,v_i)}{p(v_i)} \frac{p(s_i,c_i,v_i)}{p(c_i,v_i)} = p(c_i | v_i)p(s_i|c_i,v_i)}{\sum^M_{m=1}p(m|v_i)p(s_i | v_i, m)} \\
& = \frac{p(c_i | v_i)p(s_i|c_i,v_i)}{\sum^M_{m=1}p(m|v_i)p(s_i | v_i, m)}
\end{aligned}\tag{9}
$$
后验中,$p(c_i | v_i)$,$p(m|v_i)$是$v_i$的cluster 分布,在Eq.(7)中给出定义。但是,对于$p(s_i|c_i,v_i)$和$p(s_i | v_i, m)$,Eq.(6)中给出了它的定义,$p\left(s_i \mid v_i, c_i\right) =\frac{\exp \left(\mathbf{h}_i^{\top} \tilde{\mathbf{h}}_{s_i} / \tau\right)}{\sum_{j \in V \backslash\{i\}} \exp \left(\mathbf{h}_i^{\top} \tilde{\mathbf{h}}_j / \tau\right)}$, 可以看出分母部分需要计算$\mathbf{h}_i$与所有节点,并且还要over all $M$ cluster,因此后验难以计算。为了解决这个问题,我们可以maximize evidence lower bound (ELBO) of $\log p(s_i | v_i)$:
$$
\begin{aligned}
\log p(s_i | v_i) &= \log \frac{p(s_i,v_i)}{p(v_i)} = \log \frac{p(s_i,v_i)p(c_i | v_i,s_i)}{p(v_i)p(c_i | v_i,s_i)} \\
&= \log \frac{p(v_i,s_i,c_i)}{p(v_i)p(c_i | v_i,s_i)} \\
&= \log \frac{p(s_i|v_i,c_i)p(v_i,c_i)}{p(v_i)p(c_i | v_i,s_i)} = \log \frac{p(s_i|v_i,c_i)p(c_i|v_i)p(v_i)}{p(v_i)p(c_i | v_i,s_i)} \\
& = \log \frac{p(s_i|v_i,c_i)p(c_i|v_i)}{p(c_i | v_i,s_i)} \\
& = \log p(s_i|v_i,c_i)-\log p(c_i | v_i,s_i) + \log p(c_i|v_i) \\
& \text{引进一个关于隐变量$c_i$的分布$q(c_i)$,可以是任意形式,这里定义为$q(c_i|v_i,s_i)$}\\
& = \log p(s_i|v_i,c_i) - \log \frac{p(c_i | v_i,s_i)}{q(c_i|v_i,s_i)} + \log \frac{p(c_i|v_i)}{q(c_i|v_i,s_i)} \\
&\text{左右两边分别对$q(c_i|v_i,s_i)$求期望} \\
\text{左边} &= \int q(c_i|v_i,s_i) \log p(s_i | v_i) d c_i = \int q(c_i|v_i,s_i) d c_i \cdot \log p(s_i | v_i) = \log p(s_i | v_i) \\
\text{右边} &= \int q(c_i|v_i,s_i) \log p(s_i|v_i,c_i) dc_i - \underbrace{\int q(c_i|v_i,s_i) \log \frac{p(c_i | v_i,s_i)}{q(c_i|v_i,s_i)} dc_i}_{-\mathrm{KL}(q(c_i|v_i,s_i)||p(c_i | v_i,s_i))} + \underbrace{\int q(c_i|v_i,s_i) \log \frac{p(c_i|v_i)}{q(c_i|v_i,s_i)} dc_i}_{-\mathrm{KL}(q(c_i|v_i,s_i)||p(c_i|v_i))} \\
&= \int q(c_i|v_i,s_i) \log p(s_i|v_i,c_i) dc_i + \mathrm{KL}(q(c_i|v_i,s_i)||p(c_i | v_i,s_i)) - \mathrm{KL}(q(c_i|v_i,s_i)||p(c_i|v_i)) \\
& \geq \underbrace{\mathbb{E}_{q(c_i|v_i,s_i)} \log p(s_i|v_i,c_i) - \mathrm{KL}(q(c_i|v_i,s_i)||p(c_i|v_i))}_{ELBO}
\end{aligned} \tag{10}
$$
因此, we have:
$$
\log p(s_i | v_i) \geq ELBO = \mathbb{E}_{q(c_i|v_i,s_i)} \log p(s_i|v_i,c_i) - \mathrm{KL}(q(c_i|v_i,s_i)||p(c_i|v_i)) \tag{10}
$$
所以目标为找到node embeddings $\mathbf{h}_i, \forall i$, 最大化ELBO。接下来可以定义任意关于隐变量$c_i$的vartational distribution $q(c_i)$。 这里将关于$c_i$的variational distribution定义为用mini-batch近似后验的形式:
$$
q\left(c_i \mid v_i, s_i\right)=\frac{p\left(c_i \mid v_i\right) \tilde{p}\left(s_i \mid v_i, c_i\right)}{\sum_{m=1}^M p\left(m \mid v_i\right) \tilde{p}\left(s_i \mid v_i, m\right)} \tag{11}
$$
其中$\tilde{p}\left(s_i \mid v_i, c_i\right)=\exp \left(\mathbf{h}_i^{\top} \tilde{\mathbf{h}}_{s_i} / \tau\right) / \sum_{j \in I \backslash\{i\}} \exp \left(\mathbf{h}_i^{\top} \tilde{\mathbf{h}}_j / \tau\right)$,与Eq.(6)不同的是$\tilde{p}\left(s_i \mid v_i, c_i\right)$的分母只计算mini-batch $I$内的negative samples。并且用$\tilde{p}\left(s_i \mid v_i, c_i\right)$来替换了Eq.10 中的$ p(s_i|v_i,c_i)$,文中证明了这种替代的合理性。
在E-step,定义了variational distribution $q\left(c_i \mid v_i, s_i\right)$和likelihood objective的ELBO,在M-step最大化ELBO。给定一个mini-batch $I$,目标函数为最大化$I$中每对positive pairs 的ELBO: $$ \max \quad \mathcal{L}_{\mathrm{ELBO}}(\theta, \mathbf{w} ; I) \approx \frac{1}{|I|} \sum_{i \in I} \frac{1}{\left|S_i\right|} \sum_{s_i \in S_i} \mathcal{L}_{\mathrm{ELBO}}\left(\theta, \mathbf{w} ; v_i, s_i\right) $$