Introduction
在现实世界的社交网络中,一个顶点在与不同的邻居顶点交互时可能表现出不同的方面 (aspect),这是很直观的。例如,研究人员通常与各种合作伙伴就不同的研究主题进行合作(如下图所示),社交媒体用户与分享不同兴趣的各种朋友联系,一个网页出于不同目的链接到多个其它网页。然而,现有的大多数 NE 方法只为每个顶点安排一个 single embedding 向量,并产生以下两个问题:
- 这些方法在与不同邻居交互时,无法灵活转换不同的aspect
- 在这些模型中,一个顶点倾向于迫使它的所有邻居之间的 embedding彼此靠近,但事实上并非一直如此。例如下图中,左侧用户和右侧用户共享较少的共同兴趣,但是由于他们都链接到中间用户,因此被认为彼此接近。因此,这使得顶点 embedding 没有区分性。
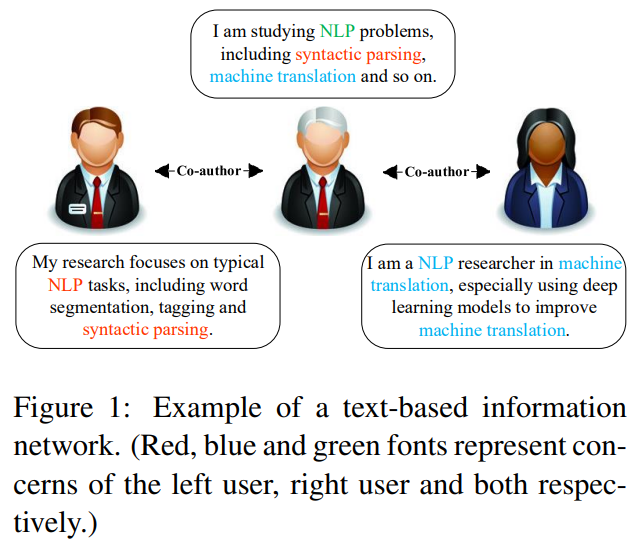
为了解决上述问题,本文提出了一个 CANE框架,用于精确建模顶点之间的关系。更具体而言,论文在信息网络上应用 CANE。信息网络的每个顶点还包含丰富的外部信息,例如文本、标签 、或者其它元数据。在这种场景下,上下文的重要性对 network embedding 更为关键。在不失一般性的情况下,论文在基于文本的信息网络中实现了 CANE,但是 CANE可以很容易地扩展到其它类型的信息网络。
在传统的 network embedding模型中,每个顶点都表达为一个静态的 embedding 向量,即 context-free embedding 。相反,CANE 根据与当前顶点交互的不同邻居,从而将动态的 embedding分配给当前顶点,称为 context-aware embedding。以一个顶点$u$为例:当与不同的邻居交互时, 的 context-free embedding保持不变;而当面对不同的邻居时, $u$的 context-aware embedding是动态的。
当顶点$u$与它的邻居顶点$v$交互时,它们彼此相关的 context embedding 分别来自它们的文本信息。对于每个顶点,可以轻松地使用神经模型neural model ,例如卷积神经网络和循环神经网络来构建 context-free embedding 和 text-based embedding 。为了实现 context-aware text-based embedding,论文引入了 selective attention 方案,并在这些神经模型中建立了 和 之间的互注意力 mutual attention 。mutual attention 预期引导神经模型强调那些被相邻顶点 focus 的单词,并最终获得 context-aware embedding。每个顶点的 context-free embedding 和 context-aware embedding 都可以通过使用现有的 network embedding 方法学到(如 DeepWalk,LINE,node2vec)并拼接起来。
论文对不同领域的三个真实数据集进行了实验。与其它 state-of-the-art 方法相比,链接预测的实验结果展示了论文框架的有效性。结果表明,context-aware embedding 对于网络分析至关重要,特别是对于那些涉及顶点之间复杂交互的任务,如链接预测。论文还通过顶点分类和案例研究来探索论文框架的性能,这再次证实了 CANE 模型的灵活性和优越性。
Model
给定信息网络$G = (V,E,T)$, ,其中$V$为顶点集合, $E \subseteq V \times V$为边集合, $T$为顶点的文本信息。每条边表示顶点之间的关系,并且关联一个权重$w_{u,v}$ 。这里顶点$v \in V$的文本信息表达为单词序列$\mathcal{S}_{v}=\left(t_{1}, t_{2}, \cdots, t_{n_{v}}\right)$,其中$n_{v}=\left|\mathcal{S}_{v}\right|$为序列$\mathcal{S}_{v}$的长度。
NE旨在根据网络结构和关联信息(如文本和 label)为每个顶点$v \in V$ 学习低维embedding$\overrightarrow{\mathbf{v}} \in \mathbb{R}^{d}$, 其中 $d \ll |V|$为embedding的维度。
Context-free Embedding 的定义:传统的 network representation learning 模型为每个顶点学习 context-free embedding 。这意味着顶点的 embedding 是固定的,并且不会根据顶点的上下文信息(即与之交互的另一个顶点)而改变。
Context-aware Embedding 的定义:与现有的、学习 context-free embedding 的NE 模型不同,CANE 根据顶点不同的上下文来学习该顶点的各种 embedding 。具体而言,对于边$e_{u,v}$, CANE 学习 context-aware embedding $\overrightarrow{\mathbf{v}}_{(u)}$和$\overrightarrow{\mathbf{u}}_{(v)}$
Framework
为了充分利用网络结构和关联的文本信息,为顶点$v$提供了两种类型的 embedding:structure-based embedding $\overrightarrow{\mathbf{v}}^{s}$, text-based embedding $\overrightarrow{\mathbf{v}}^{t}$。structure-based embeding 可以捕获网络结构中的信息,而 text-based embedding 可以捕获关联文本信息中的文本含义(textual meaning)。使用这些 embedding,可以简单地拼接它们并获得顶点 embedding 为: $$ \overrightarrow{\mathbf{V}}=\overrightarrow{\mathbf{V}}^{s} \oplus \overrightarrow{\mathbf{V}}^{t} $$ 其中$\oplus$为拼接算子。注意, text-based embedding $\overrightarrow{\mathbf{v}}^{t}$可以是 context-free 的、也可以是context-aware的,这将在后面详细介绍。当$\overrightarrow{\mathbf{v}}^{t}$是 context-aware时,整个顶点 embedding $\overrightarrow{\mathbf{v}}$也将是 context-aware。
通过上述定义,CANE旨在最大化所有边上的目标函数,如下所示: $$ \mathcal{L}=\sum_{e \in E} L(e) $$ 这里每条边的目标函数$L(e)$由两部分组成: $$ L(e) = L_s(e) + L_t(e) $$ $L_s(e)$表示基于结构的目标函数, $L_t(e)$表示基于文本的目标函数。 接下来分别对这两个目标函数进行详细介绍。
基于结构的目标函数
为了不失一般性,假设网络是有向的,因为无向边可以被认为是两个方向相反、且权重相等的有向边。因此,基于结构的目标函数旨在使用 structure-based embedding来衡量观察到一条有向边的对数似然(log-likelihood),即: $$ L_{s}(e)=w_{u, v} \log p\left(\overrightarrow{\mathbf{v}}^{s} \mid \overrightarrow{\mathbf{u}}^{s}\right) $$ 遵从 LINE,将上式中的条件概率定义为: $$ p\left(\overrightarrow{\mathbf{v}}^{s} \mid \overrightarrow{\mathbf{u}}^{s}\right)=\frac{\exp \left(\overrightarrow{\mathbf{u}}^{s} \cdot \overrightarrow{\mathbf{v}}^{s}\right)}{\sum_{z \in V} \overrightarrow{\mathbf{u}}^{s} \cdot \overrightarrow{\mathbf{z}}^{s}} $$
基于文本的目标函数
现实世界社交网络中的顶点通常伴随着关联的文本信息。因此,本文提出了基于文本的目标函数来利用这些文本信息,并学习 text-based embedding 。
基于文本的目标函数$L_{t}(e)$可以通过各种度量指标来定义。为了与$L_{s}(e)$ 兼容,将$L_{t}(e)$定义如下: $$ L_{t}(e)=\alpha L_{t, t}(e)+\beta L_{t, s}(e)+\gamma L_{s, t}(e) $$ 其中:$\alpha$,$\beta$,$\gamma$为对应部分的重要性,为超参数。
$L_{t,t}(e)$,$L_{t, s}(e)$,$L_{s, t}(e)$定义为: $$ \begin{aligned} &L_{t, t}(e)=w_{u, v} \log p\left(\overrightarrow{\mathbf{v}}^{t} \mid \overrightarrow{\mathbf{u}}^{t}\right) \\ &L_{t, s}(e)=w_{u, v} \log p\left(\overrightarrow{\mathbf{v}}^{t} \mid \overrightarrow{\mathbf{u}}^{s}\right) \\ &L_{s, t}(e)=w_{u, v} \log p\left(\overrightarrow{\mathbf{v}}^{s} \mid \overrightarrow{\mathbf{u}}^{t}\right) \end{aligned} $$ 这里构建了 structure-based embedding 、 text-based embedding 之间的桥梁,使得信息在结构和文本之间流动。上式中的条件概率将两种类型的顶点 embedding 映射到相同的 representation 空间中,但是考虑到它们自身的特点,这里并未强制它们相同。类似地,使用 softmax 函数来计算概率,如公式$p\left(\overrightarrow{\mathbf{v}}^{s} \mid \overrightarrow{\mathbf{u}}^{s}\right)$所示。
structure-based embedding 被视为 parameter,与传统的 network embedding 模型相同。但是对于 text-based embedding,本文从顶点的关联文本信息中获取它们。此外, text-based embedding 可以通过 context-free 的方式、或者 context-aware 的方式获取。
Context-Free Text Embedding
有多种神经网络模型可以从单词序列 word sequence 中获取 text embedding,如卷积神经网络 CNN、循环神经网络RNN。在这项工作中,研究了用于文本建模的不同神经网络,包括 CNN、Bidirectional RNN、GRU,并采用了性能最好的 CNN。CNN 可以在单词之间捕获局部语义依赖性。
CNN 以一个顶点的单词序列作为输入,通过 lookup、卷积、池化这三层得到基于文本的 embedding 。
lookup:给定一个单词序列 $\mathcal{S}=\left(t_{1}, t_{2}, \cdots, t_{n}\right)$, lookup layer 将每个单词$t_i$转换为对应的 word embedding $\overrightarrow{\mathbf{t}}_{i} \in \mathbb{R}^{d^{\prime}}$, 并且获得 embedding序列$\mathbf{S}=\left(\overrightarrow{\mathbf{t}}_{1}, \cdots, \overrightarrow{\mathbf{t}}_{n}\right)$, 其中$d^{\prime}$为word embedding的维度。
卷积:lookup之后,卷积层提取输入的embedding序列$\mathbf{S}$局部特征 local feature。具体而言,它使用卷积矩阵$\mathbf{C} \in \mathbb{R}^{d \times\left(l \times d^{\prime}\right)}$在长度为$l$的滑动窗口上进行卷积操作,如下所示:
$$ \overrightarrow{\mathbf{x}}_{i}=\mathbf{C} * \mathbf{S}_{i: i+l-1}+\overrightarrow{\mathbf{b}} $$
$\mathbf{C}$表示$d$个卷积核,每个卷积核的尺寸为$l \times d^\prime$。 $d$为卷积核数量,也称作输出通道数。
其中:$\mathbf{S}_{i: i+l-1} \in \mathbb{R}^{l \times d}$为第$i$个滑动窗口内所有word embedding拼接得到的矩阵。$\overrightarrow{\mathbf{b}} \in \mathbb{R}^{d}$为bias。注意,在单词序列的边缘添加了零填充向量。
- 最大池化:为了获得 text embedding $\overrightarrow{\mathbf{v}}^{t}$, 对 $\left\{\overrightarrow{\mathbf{x}}_{1}, \cdots, \overrightarrow{\mathbf{x}}_{n}\right\}$进行最大池化和非线性变换,如下所示:
$$ \begin{gathered} r_{i}=\tanh \left(\max \left(x_{1, i}, x_{2, i}, \cdots, x_{n, i}\right)\right), \quad i=1, \cdots, d \\ \overrightarrow{\mathbf{v}}^{t}=\left(r_{1}, \cdots, r_{d}\right)^{\top} \in \mathbb{R}^{d} \end{gathered} $$
其中max是在 embedding维度上进行的,tanh为逐元素的函数。
Context-Aware Text Embedding
假设顶点在与其它顶点交互时扮演不同的角色。换句话讲,对于给定的顶点,其它不同的顶点与它有不同的焦点,这将导致 context-aware text embedding。
为了实现这一点,采用 mutual attention来获得 context-aware text embedding。mutual attention使 CNN 中的池化层能够感知 edge中的顶点 pair,从而使得来自一个顶点的文本信息可以直接影响另一个顶点的 text embedding,反之亦然。
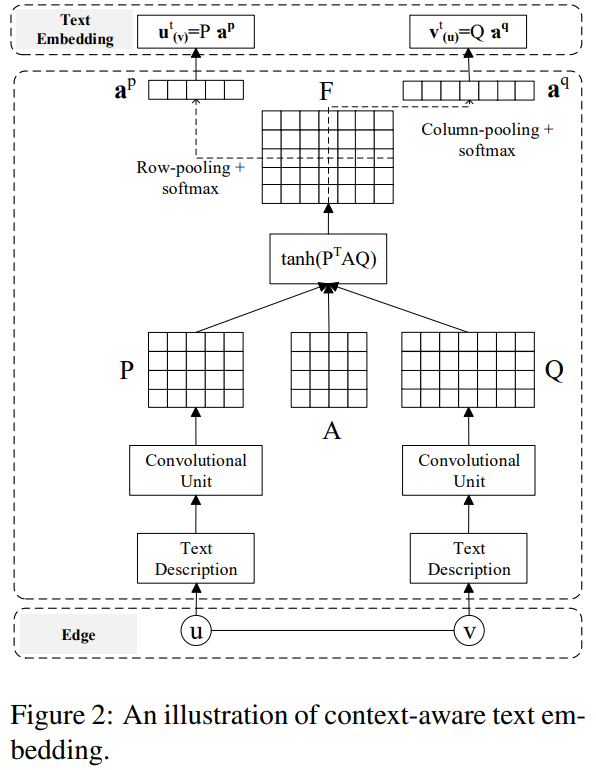
如上图所示,对于context-aware text embedding的生成过程, 给定一条边$e_{u,v}$和两个对应的文本序列$\mathcal{S}_u$和$\mathcal{S}_v$, 可以通过卷积层得到矩阵$\mathbf{P} \in \mathbb{R}^{d \times m}$和$\mathbf{Q} \in \mathbb{R}^{d \times n}$ 。这里$m$表示$\mathcal{S}_u$的长度,$n$表示$\mathcal{S}_v$的长度。通过引入一个注意力矩阵$\mathbf{A} \in \mathbb{R}^{d \times d}$,计算相关性矩阵$\mathbf{F} \in \mathbb{R}^{m \times n}$: $$ \mathbf{F}=\tanh \left(\mathbf{P}^{\top} \mathbf{A} \mathbf{Q}\right) $$ 其中$\mathbf{F}$中的每个元素$\mathbf{F}_{i,j}$表示两个隐向量(即$\overrightarrow{\mathbf{p}}_{i}$, $\overrightarrow{\mathbf{q}}_{j}$)之间的 pair-wise相关性得分。 然后,沿 $\mathbf{F}$的行和列进行池化操作从而生成重要性向量,分别称作行池化row-pooling和列池化column-pooling。根据实验,均值池化的性能优于最大池化。因此,采用如下的均值池化操作: $$ \begin{aligned} g_{i}^{p} &=\operatorname{mean}\left(F_{i, 1}, F_{i, 2}, \cdots, F_{i, n}\right) \\ g_{i}^{q} &=\operatorname{mean}\left(F_{1, i}, F_{2, i}, \cdots, F_{m, i}\right) \end{aligned} $$ 其中:$\overrightarrow{\mathbf{g}}^{p}=\left(g_{1}^{p}, \cdots, g_{m}^{p}\right)^{\top} \in \mathbb{R}^{m}$表示行池化向量,为$\mathbf{P}$的重要性向量。$\overrightarrow{\mathbf{g}}^{q}=\left(g_{1}^{q}, \cdots, g_{m}^{q}\right)^{\top} \in \mathbb{R}^{m}$表示列池化向量,为$\mathbf{Q}$的重要性向量。
接下来,使用softmax函数将重要性向量$\overrightarrow{\mathbf{g}}^{p}$和$\overrightarrow{\mathbf{g}}^{q}$转换为注意力向量 $\overrightarrow{\mathbf{a}}^{p}$和$\overrightarrow{\mathbf{a}}^{q}$: $$ \begin{aligned} a_{i}^{p}=\frac{\exp \left(g_{i}^{p}\right)}{\sum_{j=1}^{m} \exp \left(g_{j}^{p}\right)}, \quad a_{i}^{q}=\frac{\exp \left(g_{i}^{q}\right)}{\sum_{j=1}^{n} \exp \left(g_{j}^{q}\right)} \ \end{aligned} $$
$$ \begin{aligned} \overrightarrow{\mathbf{a}}^{p}=\left(a_{1}^{p}, \cdots, a_{m}^{p}\right)^{\top} \in \mathbb{R}^{m} \\ \overrightarrow{\mathbf{a}}^{q}=\left(a_{1}^{q}, \cdots, a_{n}^{q}\right)^{\top} \in \mathbb{R}^{n} \end{aligned} $$ 最后,顶点$u$和$v$ 的 context-aware text embedding计算为: $$ \overrightarrow{\mathbf{u}}_{(v)}^{t}=\mathbf{P} \overrightarrow{\mathbf{a}}^{p}, \quad \overrightarrow{\mathbf{v}}_{(u)}^{t}=\mathbf{Q} \overrightarrow{\mathbf{a}}^{q} $$ 现在,给定一条边$e_{u,v}$,可以获得 context-aware embedding,它是 structure embedding 和 context-aware text embedding的拼接: $$ \overrightarrow{\mathbf{u}}_{(v)}=\overrightarrow{\mathbf{u}}^{s} \oplus \overrightarrow{\mathbf{u}}_{(v)}^{t}, \quad \overrightarrow{\mathbf{v}}_{(u)}=\overrightarrow{\mathbf{v}}^{s} \oplus \overrightarrow{\mathbf{v}}_{(u)}^{t} $$
CANE优化过程
CANE 旨在最大化若干个条件概率。直观而言,使用 softmax函数优化条件概率在计算上代价太大。因此,使用负采样,并将目标函数转换为以下形式: $$ \log \sigma(\overrightarrow{\mathbf{u}} \cdot \overrightarrow{\mathbf{v}})+k \times \mathbb{E}_{z \sim P(v)}[\log \sigma(-\overrightarrow{\mathbf{u}} \cdot \overrightarrow{\mathbf{z}})] $$ 其中$k$为负采样比例, $\sigma$为sigmoid, $P(v) \propto d_{v}^{3 / 4}$为负顶点的采样分布,$d_{v}$为顶点$v$的out-degree。