Introduction
现有的GNN在图和模型的size方面可拓展性有限。 对于大图,增加模型的深度对导致scope(感受野)大小成指数放大。深层model主要面临两个基本挑战: 1. oversmoothing导致表达能力下降,2. 邻域爆炸导致计算成本高昂。
本文旨在结构GNN的depth 和 scope,首先提取子图作为有限大小(bounded-size)的scope, 然后将任意深度的GNN用于子图上。 由于提取出的局部子图是由少量关键邻居组成,且排除了不相关的邻居,所以深层GNN也可以学到informative representations。
增加GNN层数会造成以下基本障碍:
- Expresivity (oversmoothing): 邻居的迭代混合导致不同节点的切入向量收敛到一个固定的低维子空间
- Scalability (neighbor explosion): 多跳邻居递归导致感受野大小呈指数级增长
为了研究导致表达能力和可拓展性缺陷的根本原因,本文提出了以下insight:
Two views on the graph: 如果从全局视角来看两个节点,如果两个节点在同一个图的同一个连通分量中,那么这两个节点在随机游走中存在到达概率,无论他们间隔多远。而本文给出了图的局部视角,具体来说, 给定节点$v$的局部子图$\mathcal{G}_{[v]}$,将$\mathcal{G}_{[v]}$仅包含节点$v$的特性,整个图看一看做所有子图$\mathcal{G}_{[v]}$的集合。那么$v$的邻域不在是所有节点$\mathcal{V}$,而它的邻域只存在于$\mathcal{V}_{[v]}$中。 如果节点$u$不在$\mathcal{V}_{[v]}$中,$u$将永远不会被考虑为$v$的邻居,无论GNN有多深。
Scope of GNNs: 加深GNN层次所造成的的表达能力和可拓展性问题都和GNN不断扩大的感受野(scope)有关。随着层次变深,感受野不断变大,使得每个节点包含的信息重叠越多,最终收敛到同一个子空间,导致oversmoothing; 另外 感受野变大,导致每个节点的邻居数呈指数级上升,导致邻居爆炸。所以GNN的层数加深会导致感受野变大(耦合),即$L$层GNN的感受野为全部$L$-hop以内的邻居,层数深度(depth)和感受野大小(scope)的强耦合限制了GNN的设计。
Decoupling the GNN depth and scope: 为了解耦GNN的深度(depth)与感受野(scope),使得加层数与感受野无关。对于节点$v$,首先为它提取一个小的子图$\mathcal{G}_{[v]}$,然后在小的子图上应用任意层数的GNN。若GNN的层数$L^\prime$大于感受野的跳数,那么子图中的每对节点会交换多次信息,额外的消息传递有助于GNN更好的融合scope内的信息,从而增强表达能力。
Decoupling the Depth and Scope of GNNs
Definition (Depth of subgraph) :假设子图$\mathcal{G}_{[v]}$是连通的,$\mathcal{G}_{[v]}$的depth定义为$\max _{u \in \mathcal{V}_{[v]}} d(u, v)$, 其中$d(u, v)$表示$u$到$v$的最短路径。
本文提出shaDow-GNN,它包含了一个子图提取器$\text { EXTRACT}$。 shaDow-GNN的过程如下:
- 用子图提取器$\operatorname{EXTRACT}(v, \mathcal{G})$为节点$v$提取一个连通子图$\mathcal{G}_{[v]}$,子图的深度(距离$v$最远的节点和$v$之间的跳数)为$L$。
- 构建一个$L^\prime$层的GNN并应用在$\mathcal{G}_{[v]}$上。 如果 $L^\prime > L$那么可以反映decoupling,因为GNN层数此时与scope无关,层数加深不会影响感受野。
本文从三个不同的角度理论证明了shaDow-GNN可以提升GNN的表达能力。
Graph Signal Processing Perspective
- oversmoothing by deep GCN。 2. oversmoothing by repeated GCN-style propagation。
对于deep GCN, 包含了非线性激活,权重和bias。而带有bias参数的deep GCN 不会导致oversmoothing[1], 但任然存在准确率下降的问题,这说明GCN的这种传播形式是导致学习困难的根本原因,而不是来自于激活函数或者bias。
即,repeat-GCN-style propagation表示为$\boldsymbol{M}=\lim _{L \rightarrow \infty} \widetilde{\boldsymbol{A}}^{L} \boldsymbol{X}$这种邻居迭代聚合的传播形式会导致学习困难。因此,这里在忽略激活函数和bias的情况下分析聚合矩阵的渐近性。
对于子图$\mathcal{G}_{[v]}$, 无限次特征聚合表示为:$\boldsymbol{M}_{[v]}=\lim_{L \rightarrow \infty} \widetilde{\boldsymbol{A}}^{L}_{[v]} \boldsymbol{X}_{[v]}$。$\boldsymbol{M}_{[v]}$为节点$v$的子图$\mathcal{G}_{[v]}$的embedding矩阵。 由于$\widetilde{\boldsymbol{A}}_{[v]} = (\boldsymbol{D}_{[v]} + \boldsymbol{I}_{[v]})^{-\frac{1}{2}} (\boldsymbol{A}_{[v]} + \boldsymbol{I}_{[v]}) (\boldsymbol{D}_{[v]} + \boldsymbol{I}_{[v]})^{-\frac{1}{2}}$,$\widetilde{\boldsymbol{A}}_{[v]}$是实对称阵, 所以可以做特征分解, 即$\widetilde{\boldsymbol{A}}_{[v]}=\boldsymbol{E}_{[v]} \boldsymbol{\Lambda} \boldsymbol{E}_{[v]}^{-1}=\boldsymbol{E}_{[v]} \boldsymbol{\Lambda} \boldsymbol{E}_{[v]}^{\top}$。那么:
$$
\widetilde{\boldsymbol{A}}_{[v]}^{L \to \infty} =\boldsymbol{E}_{[v]} \boldsymbol{\Lambda}^L \boldsymbol{E}_{[v]}^{\top} = \boldsymbol{E}_{[v]} \begin{bmatrix}
\lambda_1^L & & & \\
& \ddots & & \\
& & \lambda_N^L&
\end{bmatrix}\boldsymbol{E}_{[v]}^{\top} = e_{[v]}e_{[v]}^\top
$$
因为归一化邻接矩阵$\widetilde{\boldsymbol{A}}_{[v]}$的最大特征值一定为1,且半正定,那么当$L \to \infty$时, 若$1 = \lambda_1 > \cdots > \lambda_N$, 所以$\lambda_1^L = 1$,$\lambda_2^L,\cdots,\lambda_N^L \to 0$。所以上式成立,其中$e_{[v]}$为$\widetilde{\boldsymbol{A}}_{[v]}$最大特征值对应特征向量。所以:
$$
\lim_{L\to \infty} \widetilde{\boldsymbol{A}}_{[v]}^{L} X_{[v]} = e_{[v]}e_{[v]}^\top X_{[v]} = e_{[v]}(e_{[v]}^\top X_{[v]}) = \boldsymbol{M}
$$
因此在子图$\mathcal{G}_{[v]}$上使用无限多层GNN的 shaDow-GNN得到的节点emb矩阵为$\boldsymbol{M} = e_{[v]}(e_{[v]}^\top X_{[v]})$, 那么 shaDow-GNN为节点$v$学习到的embedding为 节点$v$在其子图$\mathcal{G}_{[v]}$中的对应embedding。即:
$$
\boldsymbol{M}_{[v]}=\left[e_{[v]}\right]_{v} \cdot\left(\boldsymbol{e}_{[v]}^{\top} \boldsymbol{X}_{[v]}\right) \tag{1}
$$
考虑到这是无向图,$\widetilde{\boldsymbol{A}}_{[v]}$的最大特征值对应的特征向量表示中的每个元素表示$\mathcal{G}_{[v]}$中对应节点的度。所以$\left[e_{[v]}\right]_{u}$是$\mathcal{G}_{[v]}$中节点$u$的度$\delta_{[v]}(u)$。所以$e_{[v]} = [\delta_{[v]}(u)]$是$\mathcal{G}_{[v]}$中节点的度向量。由于这里的粗体$e_{[v]}$是对$e_{[v]}$的normalization:
$$
\left[e_{[v]}\right]_{u}=\sqrt{\frac{\delta_{[v]}(u)}{\sum_{w \in \mathcal{V}_{[v]}} \delta_{[v]}(w)}}
$$
上面的$\boldsymbol{M}_{[v]}$为 shaDow-GNN为节点$v$学到的embedding。
对于普通的GCN propagation,可以看做是一个有足够大的hop $L$的$\mathcal{G}_{[v]}$ 和一个有足够大hop $L$的$\mathcal{G}_{[u]}$,使得在无限多层GCN时, $\mathcal{G}_{[v]} = \mathcal{G}_{[u]}$。即对于无限多层的普通GCN,两个不同节点的scope是一样的,这就说明 $e_{[v]} = e_{[u]}$,并且$\boldsymbol{X}_{[u]}=\boldsymbol{X}_{[v]}=\boldsymbol{X}$。即对于普通的无限多层GNN来说,两个不同节点的局部子图就是整个图,无法保存节点特有的特征信息,根据公式一,由于$e_{[v]} = e_{[u]}$只和两个节点的度有关,特征信息又是一样的,所以在整个图上使用无限多层GNN的到的两个节点的embedding $\boldsymbol{M}_{[v]}$和$\boldsymbol{M}_{[u]}$只和两个节点的度有关。
而对于shaDow-GNN,它实现一种局部平滑(local-smoothing),由于是在子图上做特征聚合,那么无论多少层,都不会聚合到子图范围以外的邻居。从公式(1)可以看出,在子图内,目标节点的embedding实际上就是子图内所有节点embedding的线性组合,无限增加层数值只会使得线性组合的系数$e_{[v]}$收敛到一个固定值,即$\widetilde{\boldsymbol{A}}_{[v]}$的稳态分布向量。而稳态分布向量$e_{[v]}$的具体取值只与对应子图的度有关,与GNN层数无关。直观来看,子图提取器$\text { EXTRACT}$会为不同的节点提取不同的子图,若$u$,$v$的子图不同,那么对应的$e_{[v]}$与$e_{[v]}$也不同,$\boldsymbol{X}_{[u]}$和$\boldsymbol{X}_{[v]}$也不同,所以shaDow-GNN在无限多层下依旧捕获局部特征信息。
Function Approximation Perspective
GraphSAGE的每层定义为: $$ \boldsymbol{h}_{v}^{(\ell)}=\sigma\left(\left(\boldsymbol{W}_{1}^{(\ell)}\right)^{\top} \boldsymbol{h}_{v}^{(\ell-1)}+\left(\boldsymbol{W}_{2}^{(\ell)}\right)^{\top}\left(\frac{1}{\mid \mathcal{N}_{v}\mid } \sum_{u \in \mathcal{N}_{v}} \boldsymbol{h}_{u}^{(\ell-1)}\right)\right) $$ 对于$L^\prime$层的shaDow-SAGE,,若$\text { EXTRACT}$为节点提取$L$-hop的邻居,并且,对于shaDow-SAGE的$L+1 \leq \ell \leq L^{\prime}$层,令$\boldsymbol{W}_{1}^{(\ell)}=\boldsymbol{I}$,$\boldsymbol{W}_{2}^{(\ell)}=\mathbf{0}$, 此时$L^\prime$层的shaDow-SAGE等价于$L$层的GraphSAGE。所以$L^\prime$层的shaDow-SAGE可以表达GraphSAGE能表达的所有函数。
要证明shaDow-SAGE可以表达一些GraphSAGE无法表达的函数,首先对于每个邻域子图$\mathcal{G}_{[v]}$考虑一个目标函数:$\tau\left(\boldsymbol{X}, \mathcal{G}_{[v]}\right)=C \cdot \sum_{u \in \mathcal{V}_{[v]}} \delta_{[v]}(u) \cdot \boldsymbol{x}_{u}$,其中$C$是一个scaling常数,$\delta_{[v]}(u)$是节点$u$在子图$\mathcal{G}_{[u]}$中的度。
GraphSAGE准确的学习函数$\tau$,而shaDow-SAGE可以。令子图$\mathcal{G}_{[v]}$的深度为$L$,对于GraphSAGE,只有它在原图上做$L$层的Message Passing,或者它做$L^\prime$次MP的同时,$L^{\prime}-L$层的$\boldsymbol{W}_{2}$为0时,GraphSAGE才会遍历$\mathcal{G}_{[v]}$中的节点,否则,$L^\prime$层GraphSAGE将受到$v^{\prime} \notin \mathcal{V}_{[v]}$的影响,那么它无法近似$\tau$。那么问题就变为比较$L^\prime$层shaDow-SAGE在$\mathcal{G}_{[v]}$上的表达能力 和 $L$层GraphSAGE在原图上的表达能力, 因为他们的感受野都是$\mathcal{G}_{[v]}$。接下来,假设GraphSAGE可以在一个局部子图$\mathcal{G}_{[v]}^{\prime}$学习一个函数$\zeta$, 使得$\zeta\left(\mathcal{G}_{[v]}^{\prime}\right)=\tau\left(\mathcal{G}_{[v]}^{\prime}\right)$, 那么如果我们为子图$\mathcal{G}_{[v]}^{\prime}$添加一条边$e$来连接子图第$L$层的两个节点。 那么边$e$将会改变子图的度分布$\delta_{[v]}(\cdot)$,因此$\tau\left(\mathcal{G}_{[v]}^{\prime}\right) \neq \tau\left(\mathcal{G}_{[v]}^{\prime \prime}\right)$一定成立。对于在原图上$L$层GraphSAGE来说,第$L$-hop节点没有可能进行互相之间的message passing,除非GraphSAGE的层数增加,也就是GraphSAGE至少需要$L+1$层才有可能区分关于两个不同图的函数$\tau$, $\tau\left(\mathcal{G}_{-}[v]^{\prime}\right)$ 和$\tau\left(\mathcal{G}_{-}[v]^{\prime \prime}\right)$。所以原图上的$L$层GraphSAGE难以区分函数$\tau$的不同输入,会将不同的输入图输出同一个值,导致表达能力下降。而对于子图上的$L^\prime$层shaDow-SAGE, 直观上来看,它在最后一层后还有Message Passing,所以可以区分不同的输入。因此表达能力强于GraphSAGE。
Topological Learning Perspective
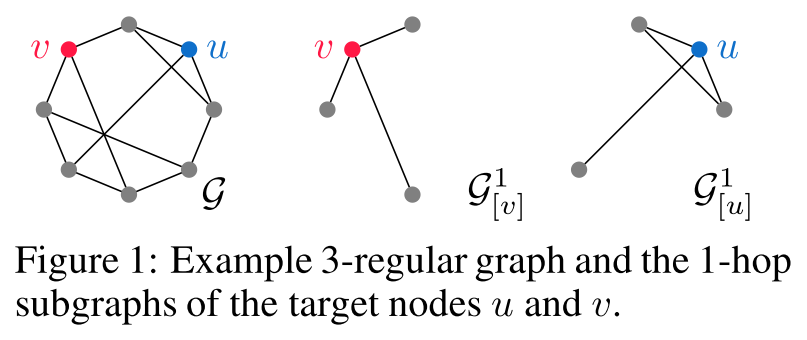
对于Regular Graph, 总所周知它无法被1-WL test 区分, 因为“regular” property describes a global topological symmetry among nodes, 节点之间是全局拓扑对称的,任意两个节点的任意阶邻居数量完全一样,所以1-WL test无法区分regular graph 中的任意两个节点, 如图一中$\mathcal{G}$所示。而对于shaDow-GNN来说,每个节点的局部子图不一定regular,如上图中$\mathcal{G}_{[v]}^{1}$ 和$\mathcal{G}_{[u]}^{1}$所示,使用$\text { EXTRACT}$为节点提取一阶邻居后,可以区分两个节点。
另外$L^\prime$层shaDow-GNN 可以近似$L$层GIN。基于Universal Approximation Theorem, 先做$L^\prime-L$次MLP,使得输入等于输出: $$ \definecolor{energy}{RGB}{114,0,172} \definecolor{freq}{RGB}{45,177,93} \definecolor{spin}{RGB}{251,0,29} \definecolor{signal}{RGB}{18,110,213} \definecolor{circle}{RGB}{217,86,16} \definecolor{average}{RGB}{203,23,206} \definecolor{red}{RGB}{255,0,0} \definecolor{black}{RGB}{0,0,0} \begin{aligned} \boldsymbol{h}_{v}^{(\ell)} &=f_{1}^{(\ell)}\left(\color{red}\boldsymbol{h}_{v}^{(\ell-1)}, \color{black}\sum_{u \in \mathcal{N}_{v}} f_{2}^{(\ell)}\left(\boldsymbol{h}_{v}^{(\ell-1)}, \boldsymbol{h}_{u}^{(\ell-1)}\right)\right) \\ &=\color{red}\boldsymbol{h}_{v}^{(\ell-1)}\color{black}, \quad \forall 1 \leq \ell \leq L^{\prime}-L \end{aligned} $$
在此基础上在做$L$层GIN。 所以$L^\prime$层shaDow-GNN 可以表达$L$层GIN。
子图提取算法
启发式$\text { EXTRACT}$: 1. 根据最短路径,随机选取或者选取全部$L$-hop内的邻居作为$\mathcal{G}_{[v]}$。 2. 基于PPR score为每个节点选取top-K 节点,构造诱导子图。同理 Katz index, SimRank都可以作为分数指标。
Architecture
Subgraph Pooling
对于shaDow-GNN,通过READOUT子图中的所有节点embedding来作为target node的embedding、对于normal GNN, 则是直接将第$L$层的输出作为embedding。考虑一个问题,节点的$L$-hop邻域内的节点也可能存在交互,比如对于节点$v$来说,它的邻域内有两个节点$u$和$w$,这两个节点之间的距离可能有$2L$ hop。 但是$L$层GNN无法捕获$u$和$w$之间的交互,除非将层数扩大到$2L$,但这将引入相当多无关节点。 而shaDow-GNN在$L$-hop子图$\mathcal{G}_{[v]}$中直接应用深层($>2L$)GNN,此时可以捕获邻域内节点互相之间的交互,获得更加有意义的embedding。
Subgraph Ensemble
单一的$\text { EXTRACT}$不一定能够选取有意义的邻居, 所以可以使用多个候选$\text { EXTRACT}$,若有$R$个候选$\text { EXTRACT}$,最后每个节点将得到$R$个embedding,然后可以用一个基于attention的聚合函数将每个$\text { EXTRACT}$输出的node embedding组合目标节点最终的node embedding。
Reference
[1]Tackling Over-Smoothing for General Graph Convolutional Networks.