Overview
The following two works reduce prediction discrimination by optimizing adjacency matrices, which can improve fairness for link prediction tasks:
- On Dyadic Fairness: Exploring and Mitigating Bias in Graph Connections (ICLR 2021)
- All of the Fairness for Edge Prediction with Optimal Transport (AISTATS 2021)
通过修改原图的敏感属性,使用对比学习来实现模型对敏感属性的鲁棒性,即敏感属性的修改不会影响模型的输出:
- Towards a Unified Framework for Fair and Stable Graph Representation Learning (UAI 2021)
使用对抗训练策略来增强图,使得增强图与敏感属性的关系(MI)最小,基于增强图训练的representation可以实现fairness:
- Learning Fair Graph Representations via Automated Data Augmentations (ICLR 2023)
证明了message passing的neighbor aggregation会使得拓扑偏差积累到node representation中,在GNN的signal denoising优化框架中加入fairness regularization,使得学习到的节点表示向量要满足,不同敏感group具有相同的期望logits:
- FMP: Toward Fair Graph Message Passing against Topology Bias (Arxiv 2022)
跨group的属性联合分布在model处理后的分布差异最小化:
- EDITS: Modeling and Mitigating Data Bias for Graph Neural Networks (WWW 22)
1. On Dyadic Fairness: Exploring and Mitigating Bias in Graph Connections (ICLR 2021)
Introduction
为了减轻算法的歧视性,涉及公平的算法至关重要。具体来说本文关注二元公平性(Dyadic fairness),即2个实例间的预测关系独立于敏感属性(敏感属性不会对节点间的预测关系分数产生影响)。本文揭示了调节现有边的权重有益于实现二元公平,并且进一步提出FairAdj来学习一个具有适当图结构约束的公平邻接矩阵,从而实现公平的链路预测。
在推荐系统中,敏感属性可能会主导带有偏见的推荐,比如用户的宗教信可能会对用户的相互推荐偏向产生影响,导致用户更可能被推荐具有相同宗教信仰的其他用户,从而导致社会关系产生隔离。因此,对于两个实例而言,算法应该在不受他们敏感属性影响的情况下执行链路预测。二元公平性的概念来自于统计中的group fairness。首先,图中的节点根据敏感属性的取值分为几个组,二元公平要求一些统计数据在组内和组间大致相等。
Dyadic Fairness
对于某一个敏感属性,每个节点有一个该属性的值,用$S(v)$表示节点 $v$的敏感属性, $\Gamma(v)$表示节点 $v$的一阶邻居集合。如果节点 $u$和 $v$的敏感属性值相同,那么Edge $(u,v)$为intra (Group内边);如果 $u$和 $v$的敏感属性值不同,即 $S(u) \neq S(v)$则Edge $(u,v)$为inter(Group间边)。对于一个binary sensitive attribute,即sensitive attribute有两个可选值(如男/女),可以将图中的节点分为不同敏感属性值的两个组 $S_0$和 $S_1$。 $\widetilde{S_0}:=\left\{v \in S_0 \mid \Gamma(v) \cap S_1 \neq \varnothing\right\}$表示 $S_0$中与 $S_1$有边连接的节点,同理 $\widetilde{S_1}$表示 $S_1$中与 $S_0$ 有边连接的节点。也就是说, $\widetilde{S_0}$和 $\widetilde{S_1}$表示具有跨group边的节点集合 。链路预测模型 $g(\cdot, \cdot): \mathbb{R}^D \times \mathbb{R}^D \rightarrow \mathbb{R}$表示将两个节点的embeddings映射为一个分数来判断是否有边连接。
Definition 2.1 如果link prediction的预测分数满足:
$\operatorname{Pr}(g(u, v) \mid S(u)=S(v))=\operatorname{Pr}(g(u, v) \mid S(u) \neq S(v))$
那么该link prediction算法满足Dyadic fairness。
也就是两个节点是否处在同一个group并不会模型对他们的预测概率。换句话说,任意调整两个节点的敏感属性值,模型对他们之间是否存在边的预测结果不变。
Demographic Parity: A fairness metric that is satisfied if the results of a model’s classification are not dependent on a given sensitive attribute.
图连通如何影响公平性
Proposition 4.1:若链路预测函数 $g(\cdot, \cdot)$定义为一个内积函数 $g(v, u)=v^{\top} \Sigma u$,其中 $\Sigma$是一个正定矩阵,那么 $\exists Q>0$, $\forall v \sim \mathcal{V}$, $||v||_2 \leq Q$,对于 $\mathbb{E}_{v \sim U}[v] \in \mathbb{R}^M$( $U$是节点集 $\mathcal{V}$上的离散均匀分布),如果 $\left|\left|\mathbb{E}_{v \sim U}\left[v \mid v \in S_0\right]-\mathbb{E}_{v \sim U}\left[v \mid v \in S_1\right]\right|\right|_2 \leq \delta$ (即由敏感属性划分的两个集合的期望特征差异小于 $\delta$),则有: $$ \Delta_{\mathrm{DP}}:=\left|\underbrace{\mathbb{E}_{(v, u) \sim U \times U}[g(v, u) \mid S(v)=S(u)]}_{u和v属于同一个group时,模型预测的期望分数}-\underbrace{\mathbb{E}_{(v, u) \sim U \times U}[g(v, u) \mid S(v) \neq S(u)]}_{u和v属于不同group时,模型预测的期望分数}\right| \leq Q||\Sigma||_2 \cdot \delta $$
Proof: 令 $p:=\mathbb{E}_{v \sim U}\left[v \mid v \in S_0\right] \in \mathbb{R}^M$表示group $S_0$中节点特征的期望, $q:=\mathbb{E}_{v \sim U}\left[v \mid v \in S_1\right] \in \mathbb{R}^M$表示group $S_1$中节点特征的期望。那么对于两个节点 $u$和 $v$,他们是跨group节点时表示向量的期望相似度 与 他们是同一个group时表示向量之间的期望相似度 之间的差异应该越小越好,表示模型的预测是独立于划分group的敏感属性。这个差异可以表示为以下形式:
若 $u$和 $v$的敏感属性不同,即他们属于不同的group,那么他们通过模型输出的embeddings相似度的期望表示为如下形式:
$$ \begin{aligned} \mathbb{E}_{\text {inter }} &= \mathbb{E}\left[v^{\top} \Sigma u \mid v \in S_0, u \in S_1\right] \\ &=\frac{1}{|S_0||S_1|} \sum_{v \in S_0} \sum_{u \in S_1} v^\top \Sigma u \\ &=\frac{1}{|S_0|} \sum_{v \in S_0} v^\top \Sigma \frac{1}{|S_1|}\sum_{u \in S_1} u \\ & = p^\top \Sigma q \end{aligned} $$
若 $u$和 $v$的敏感属性相同,即他们属于同一个敏感group,那么他们通过模型输出的embeddings相似度期望可以表示为如下形式:
$$ \begin{aligned} \mathbb{E}_{{\text {inter }}} &= \mathbb{E}\left[v^{\top} \Sigma u \mid (v \in S_0, u \in S_0) \vee (v \in S_1, u \in S_1)\right] \\ &= \frac{1}{|S_0|^2 + |S_1|^2}(\sum_{v \in S_0}v^\top \Sigma \sum_{u \in S_0}u + \sum_{v \in S_1}v^\top \Sigma \sum_{u \in S_1}u) \\ &= \frac{1}{|S_0|^2 + |S_1|^2} (|S_0|p^\top\Sigma|S_0|p + |S_1|q^\top\Sigma|S_1|q) \\ &=\frac{\left|S_0\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} p^{\top} \Sigma p+\frac{\left|S_1\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} q^{\top} \Sigma q \end{aligned} $$
那么跨group节点表示之间的相似度的期望与group内节点表示之间相似度的期望 之间的差异可以表示为如下形式
$$ \begin{aligned} \left|\mathbb{E}_{\text {inter }}-\mathbb{E}_{\text {intra }}\right| & =\left|\mathbb{E}\left[v^{\top} \Sigma u \mid v \in S_0, u \in S_1\right]-\mathbb{E}\left[v^{\top} \Sigma u \mid v \in S_0, u \in S_0 \vee v \in S_1, u \in S_1\right]\right| \\ & =\left|p^{\top} \Sigma q-\left(\frac{\left|S_0\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} p^{\top} \Sigma p+\frac{\left|S_1\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} q^{\top} \Sigma q\right)\right| \\ & =\left|(q-p)^{\top}\left(\frac{\left|S_0\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} \Sigma p-\frac{\left|S_1\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} \Sigma q\right)\right| \end{aligned} $$
令 $\alpha = \frac{\left|S_0\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2}$, $\beta = \frac{\left|S_1\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2}$,那么上式可以改写为: $$ \left|(q-p)^{\top}\left(\frac{\left|S_0\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} \Sigma p-\frac{\left|S_1\right|^2}{\left|S_0\right|^2+\left|S_1\right|^2} \Sigma q\right)\right| = \left|(q-p)^{\top} (\alpha \Sigma p-\beta\Sigma q)\right| $$
|根据柯西-施瓦茨不等式 (Cauchy–Schwarz inequality),有 $|\langle\mathbf{u}, \mathbf{v}\rangle|^2 \leq\langle\mathbf{u}, \mathbf{u}\rangle \cdot\langle\mathbf{v}, \mathbf{v}\rangle$,那么下式成立: $$ \left|(q-p)^{\top} (\alpha \Sigma p-\beta\Sigma q)\right| \leq ||q-p||_2 \cdot||\alpha \Sigma p-\beta\Sigma q||_2 $$
因为敏感group期望的差异被 $\delta$ upper bounded所以下式成立: $$ ||q-p||_2 \cdot||\alpha \Sigma p-\beta\Sigma q||_2 \leq \delta \cdot ||\alpha \Sigma p-\beta\Sigma q||_2 = \delta \cdot ||\Sigma (\alpha p - \beta q)||_2 $$
根据matrix norm,有 $||AB|| \leq ||A||\cdot ||B||$,因此下面不等式成立:
$$ \delta \cdot ||\Sigma (\alpha p - \beta q)|| \leq \delta ||\Sigma||_2 \cdot ||(\alpha p - \beta q)||_2 = \delta ||\Sigma||_2 \cdot ||(\alpha p + (- \beta q))||_2 $$
由于 $||A+B|| \leq ||A||+ ||B||$,所以下式成立:
$$ \delta ||\Sigma||_2 \cdot ||(\alpha p + (- \beta q))||_2 \leq \delta ||\Sigma||_2 \cdot (||\alpha p||_2 + ||\beta q||_2) = Q\delta ||\Sigma||_2 $$
因此,Proposition 4.1得证。
由Proposition 4.1可以得出,模型在link prediction上实现demographic parity的充分条件是模型可以为敏感属性划分的group学习到期望相似的embeddings。 下面证明图结构如何影响demographic parity。
令由敏感属性划分的group中节点表示的期望为 $\mathbb{E}_{v \sim U}\left[v \mid v \in S_0\right] = \mu_0$; $\mathbb{E}_{v \sim U}\left[v \mid v \in S_1\right] = \mu_1$。用 $\sigma$表示节点表示和所在group期望之间的最大偏差,即 $\forall v \in S_0$, $\left|\left|v-\mu_0\right|\right|_{\infty} \leq \sigma$ 且 $\forall v \in S_1$, $\left|\left|v-\mu_1\right|\right|_{\infty} \leq \sigma$。图中节点的最大加权度为 $D_{\max }:=\max_{v \in \mathcal{V}} \operatorname{deg}_w(v)$, $m_w = \sum_{S(v)\neq S(u)} a_{vu}$表示所有跨group边的权重和。下面定理展示了单次GNN平滑后,两个group的期望的差异会如何变化:
Theorem 4.1. 对于一个没有负边权重的图,在执行一次mean aggregation后,2个sensitive group中的表示差异 $\Delta_{\mathrm{DP}}^{\mathrm{Aggr}}:=\left|\left|\mathbb{E}_{v \sim U}\left[\operatorname{Agg}(v) \mid v \in S_0\right]-\mathbb{E}_{v \sim U}\left[\operatorname{Agg}(v) \mid v \in S_1\right]\right|\right|_2$会被下式bounded:
$$
\max \left\{\alpha_{\min }\left|\left|\mu_0-\mu_1\right|\right|_{\infty}-2 \sigma, 0\right\} \leq \Delta_{\mathrm{DP}}^{\mathrm{Aggr}} \leq \alpha_{\max }\left|\left|\mu_0-\mu_1\right|\right|_2+2 \sqrt{M} \sigma
$$
其中 $\alpha_{\min }=\min \left\{\alpha_1, \alpha_2\right\}$, $\alpha_{\max}=\max \left\{\alpha_1, \alpha_2\right\}$, $\alpha_1=\left|1-\frac{m_w}{D_{\max }}\left(\frac{1}{\left|S_0\right|}+\frac{1}{\left|S_1\right|}\right)\right|$, $\alpha_2=\left|1-\frac{\left|\widetilde{S_0}\right|}{\left|S_0\right|}-\frac{\left|\widetilde{S_1}\right|}{\left|S_1\right|}\right|$ , $M$是输入特征的维度。 $\alpha_2$只和图相关,所以是定值。
Theorem 4.1 中,只有跨group边的总权重 $m_w$和图中最大加权度 $D_{\max}$是可调节的,因此通过调节图中边的权重,可以调节一层GNN后得到的两个group期望表示差异,通过最小化这个差异 $\Delta_{\mathrm{DP}}^{\mathrm{Aggr}}$的上界,可以得到关于sensitive group公平的representations。
只看右边的upper bound, $\alpha_{\max}$中 $|S_0|$和 $|S_1|$是定值,对于 $\alpha_1$,如果跨group边权重很小( $m_w \rightarrow 0$)会使得 $\alpha_1$趋近于1,如果跨group边的权重很大(一个group中的所有边都连到另一个group: $m_w \rightarrow D_w \cdot \min \left\{\left|S_0\right|,\left|S_1\right|\right\}$)也会使得 $\alpha_1$趋近于1。(这里不理解???为什么 $m_w$的上限是这种形式?) 因此,增加跨group边的权重并不能够达到demographic parity,因为增得太大会使 $\alpha_{\max}$增大,导致无法取到最小上界。
Learning Fair Graph Connections
上面的分析说明了调整图结构有助于模型有条件地获得公平性。然而,在多层GNN中优化图结构并不容易,因此FairAdj在保留原始图结构的基础上更新 $\widetilde{A}$,即更新已有边的权重来实现学习表示的公平。
因为是链路预测任务,GNN编码器用于重构原始图中的边,使得GNN可以预测原图中的连接关系,本文采用VGAE作为GNN编码器:
$$ \max _\theta \quad \mathcal{L}_{\text {util }}:=\mathbb{E}_{\mathrm{GNN}_\theta(Z \mid X, \widetilde{A})}[\log p(A \mid Z)]-K L\left[\operatorname{GNN}_\theta(Z \mid X, \widetilde{A}) || \mathcal{N}(0,1)\right] $$
即 GNN编码器基于$\widetilde{A}$和 $X$生成高斯分布,再基于reparameterization trick把构造decoder来重构原图结构 $A$,这样的GNN具备链路预测能力。接下来为模型注入关于敏感属性公平性,公平性要求GNN对具有跨group边的节点间(inter 边)预测的期望分数 与group内边(intra边)预测的期望分数的差异要尽可能小,表示模型的预测独立于敏感属性:
$$ \begin{array}{cl} \min_{\widetilde{A}} & \mathcal{L}_{\text {fair }}:=\left|\left|\mathbb{E}_{v, u \sim U \times U}\left[\hat{a}_{v u} \mid S(v)=S(u)\right]-\mathbb{E}_{v, u \sim U \times U}\left[\hat{a}_{v u} \mid S(v) \neq S(u)\right]\right|\right|^2 \\ \text { s.t. } & (1) .[\widetilde{A}]_{v u}=0, \text { if }[A]_{v u}=0, \quad(2) . \widetilde{A} \mathbb{1}=\mathbb{1}, \widetilde{A} \geq 0, \end{array} $$
2. All of the Fairness for Edge Prediction with Optimal Transport (AISTATS 2021)
给定两个节点 $(V, V^\prime)$,用 $\mathbb{P}_1(h)=\mathbb{P}\left(h\left(V, V^{\prime}\right)=1 \mid S \neq S^{\prime}\right)$表示两个节点敏感属性不同时,模型 $h$为他们预测的边概率;
$\mathbb{P}_0(h)=\mathbb{P}\left(h\left(V, V^{\prime}\right)=1 \mid S=S^{\prime}\right)$表示两个节点敏感属性相同时,模型 $h$为他们预测的边概率。
Definition (Disparate Impact (DI)) :
$$ D I\left(h, \mathbb{V}, S \oplus S^{\prime}\right)=\frac{\mathbb{P}_1(h)}{\mathbb{P}_0(h)} $$
其中 $S \oplus S^{\prime}$是XOR操作,不同为1,相同为0。分子 $\mathbb{P}_1(h)$表示 $h$为跨group节点预测有边的概率,分布表示 $h$为group内节点预测有边的概率。如果模型 $h$是完美平衡的,那么DI等于1,也就是无论两个节点的敏感属性如何设置, $h$为他们预测的边概率都相同。
Definition (Balanced Error Rate (BER)):
$$ \operatorname{BER}\left(h, \mathbb{V}, S \oplus S^{\prime}\right)=\frac{\mathbb{P}_1(h)-\mathbb{P}_0(h)+1}{2} $$
BER表示模型预测两个节点敏感属性相同的概率,BER的最佳值为 $\frac{1}{2}$,即模型预测两个节点敏感属性相同的概率和不同的概率一样,都为 $\frac{1}{2}$。
Remark 1: DI 的定义可以改写成关于单个节点fairness的形式:
$$ D I(h, \mathbb{V}, S)=\frac{\mathbb{P}\left(h\left(V, V^{\prime}\right)=1 \mid S=0\right)}{\mathbb{P}\left(h\left(V, V^{\prime}\right)=1 \mid S=1\right)} $$
分子 $\mathbb{P}\left(h\left(V, V^{\prime}\right)=1 \mid S=0\right)$表示某节点敏感属性是0时, $h$预测它与其他节点产生边的概率;
分母 $\mathbb{P}\left(h\left(V, V^{\prime}\right)=1 \mid S=1\right)$表示某节点敏感属性是1时, $h$预测它与其他节点产生边的概率。
Theorem 1: 给定一个图 $\mathcal{G}=(\mathcal{V}, \mathcal{E})$ 和一个边预测函数 $h: \mathbb{V} \times \mathbb{V} \rightarrow{0,1}$,假设 $D I(h, \mathbb{V}, S) \leq \tau$,那么下式成立:
$$ D I\left(h, \mathbb{V}, S \oplus S^{\prime}\right) \leq D I(h, \mathbb{V}, S) \leq \tau $$
Corollary 1: 在Theorem 1成立的前提下,下式成立:
$$ \begin{aligned} B E R\left(h, \mathbb{V}, S \oplus S^{\prime}\right) & \leq \frac{1}{2}-\frac{\mathbb{P}_1(h)}{2}\left(\frac{1}{\tau}-1\right) \\ \min_{h \in \mathcal{H}} B E R\left(h, \mathbb{V}, S \oplus S^{\prime}\right) & =\frac{1}{2}\left(1-\frac{1}{2} W_{1 . \neq \cdot}\left(\gamma_0, \gamma_1\right)\right) \end{aligned} $$
其中 $W_{1 . \neq \cdot}$是Wasserstein Distance on the joint distributions $\gamma_0$ and $\gamma_1$. 其中 $\gamma_0$ 和 $\gamma_1$分别是group $S=0$和group $S=1$的节点分布。因此邻接矩阵的优化目标是两个group节点的分布要相似(Wasserstein distance)。
Group Graph Fairness with OT
从Corollary 1可以看出,使得模型 $h$学习到的节点表示在敏感属性划分的group上达到fairness需要两个group上节点的分布 $\gamma_0$ 和 $\gamma_1$之间的Wasserrstein distance尽可能小。
对于邻接矩阵 $\mathcal{A} \in \mathbb{R}^{N \times N}$,分布 $\gamma_0$ 是由 $\mathcal{A}$中敏感属性 $S=0$的行 $\mathcal{A}_0 \in \mathbb{R}^{N_0 \times N}$构成,分布 $\gamma_1$ 是由 $\mathcal{A}$中敏感属性 $S=1$的行 $\mathcal{A}_1 \in \mathbb{R}^{N_1 \times N}$构成。 $\gamma \in \Pi\left(\frac{1}{N_0}, \frac{1}{N_1}\right)$表示两个节点分布之间的transport plan。 $\frac{1}{N_0}, \frac{1}{N_1}$分别表示有 $N_0$和 $N_1$个元素的均匀分布,表示2个group中节点的分布。 两个group中节点到节点的运输距离用矩阵 $M \in \mathbb{R}^{N_0 \times N_1}$表示,其中 $M_{i j}=l\left(a_0^{(i)}, a_1^{(j)}\right)$表示两个跨group节点间的距离, $a_0^{(i)}$分别表示 $\mathcal{A}_0$的第 $i$行, $a_1^{(j)}$表示 $\mathcal{A}_1$的第 $j$列。 $l$是距离度量。因此,两个group中节点分布之间的距离(Wasserstein distance)是以下OT问题的解:
$$ \mathrm{inf}_{\gamma \in \Pi\left(\frac{1}{N_0}, \frac{1}{N_1}\right)} \langle\gamma, M\rangle $$
要使上式达到最小,需要优化 $M$,也就是图的邻接矩阵,使得两个group分布的Wasserstein distance达到最小:
$$ \tilde{\mathcal{A}}_{\text {bary }}=\underset{\mathcal{A} \in \mathbb{R}^{N \times N}}{\operatorname{argmin}} \frac{1}{|S|} \sum_{i=1}^{|S|} \min _{\gamma_i \in \Pi\left(\frac{1}{N}, \frac{1}{N_i}\right)} \langle\gamma, M\rangle $$
3. Towards a Unified Framework for Fair and Stable Graph Representation Learning (UAI 2021)
Notations
令图 $\mathcal{G}=(\mathcal{V}, \mathcal{E}, \mathbf{X})$表示无向图,其中 $\mathbf{x}_v \in \mathbf{X}$是节点 $v$的一个 $M$维属性向量。令 $\mathbf{I}_u \in{0,1}^N$表示节点 $u$的局部邻居,即如果 $v$与 $u$有边连接,那么 $\mathbf{I}_{uv}=1$,否则 $\mathbf{I}_{uv}=0$。令 $\mathbf{b}_u=\left[\mathbf{x}_u ; \mathbf{I}_u\right]$表示节点 $u$所有信息(局部邻居和属性特征)。
Fairness and Stability
Counterfactual Fairness (模型关于敏感属性的改变是robust的): 对于节点 $u$和它的增强 $\tilde{u}^s$(将 $u$的敏感属性翻转后得到),编码器 $\text { ENC }$若满足下面条件,那么$\text { ENC }$满足counterfactual fairness:
$$ \operatorname{ENC}(u)=\operatorname{ENC}\left(\tilde{u}^s\right) $$
Stability via Lipschitz Continuity: 对于节点 $u$和它的增强 $\tilde{u}$(对$u$扰动节点特征/边),如果编码器 $\text { ENC }$满足以下条件:
$$ ||\operatorname{ENC}(\tilde{u})-\operatorname{ENC}(u)||_p \leq L\left|\left|\tilde{\mathbf{b}}_u-\mathbf{b}_u\right|\right|_p $$
则编码器 $\text { ENC }$关于Lipschitz continuity是稳定的。 $L$ is the Lipschitz constant,对于固定的编码器函数,比如ReLU是一个1-Lipschitz连续函数 $L=1$。对于一个有固定激活函数的编码器, $L$的值是固定的。
图增强
a) 节点属性扰动:给定一个 $M$维的attribute masking向量 $\mathbf{r} \in\{0,1\}^M$用于选择需要被扰动的属性, $\mathbf{r}$中的每个值从Bernoulli distribution $p_n$中采样,表示每个属性(除了敏感属性)是否要被扰动,而扰动量从normal distribution中采样 $\delta \in \mathbb{R}^M$。那么节点 $u$特征的扰动量为 $\mathbf{r} \circ \delta$,扰动后的节点特征为: $\tilde{\mathbf{x}}_u=\mathbf{x}_u+\mathbf{r} \circ \delta$。
b) 敏感属性的反事实扰动:将节点的敏感属性值翻转,这里考虑二值敏感属性分布,即 $s \in\{0,1\}$。
c) 图结构扰动:Bernoulli distribution $\mathcal{B}(p_e)$ 中每条边以 $p_e$概率被drop,由此生成扰动后的图结构 $\tilde{\mathbf{A}}$。
Contrastive Objective
为了使模型可以对属性/结构的扰动,以及敏感属性的修改鲁棒,则需要在原图和增强后的图上,GNN可以学习到相似的embeddings,这样等价于学习扰动/敏感属性鲁棒的节点表示:
$$ \mathcal{L}_s=\mathbb{E}_u\left[\frac{1}{2}\left(D\left(t\left(\mathbf{z}_u\right), \operatorname{sg}\left(\tilde{\mathbf{z}}_u\right)\right)+D\left(t\left(\tilde{\mathbf{z}}_u\right), \operatorname{sg}\left(\mathbf{z}_u\right)\right)\right)\right] $$
Stability
若模型要满足稳定性,那么编码器应满足Lipschitz Continuity。将第 $k$层GNN编码器定义为 $\mathbf{h}^k_u = \sigma\left(\mathbf{W}_a^k \mathbf{h}_u^{k-1}+\mathbf{W}_n^k \sum_{v \in \mathcal{N}(u)} \mathbf{h}_v^{k-1}\right)$,那么下式成立:
$$ ||\operatorname{ENC}(\tilde{u})-\operatorname{ENC}(u)||_p \leq \prod_{k=1}^K\left|\left|\mathbf{W}_a^k\right|\right|_p\left|\left|\left(\tilde{\mathbf{b}}_u-\mathbf{b}_u\right)\right|\right|_p $$
Proof: 第 $k$层编码器关于节点 $u$的扰动后差异可以写为:
$$ \tilde{\mathbf{h}}_u^k-\mathbf{h}_u^k= \sigma\left(\mathbf{W}_a^k \tilde{\mathbf{h}}_u^{k-1}+\mathbf{W}_n^k \sum_{v \in \mathcal{N}(\bar{u})} \mathbf{h}_v^{k-1}\right)-\sigma\left(\mathbf{W}_a^k \mathbf{h}_u^{k-1}+\mathbf{W}_n^k \sum_{v \in \mathcal{N}(u)} \mathbf{h}_v^{k-1}\right) $$
其中 $\sigma(\cdot)$为非线性激活函数。假设 $\sigma(\cdot)$满足1-Lipschitz continuity(例如ReLU),那么下式成立:
$$ ||\sigma(b)-\sigma(a)||_p \leq||b-a||_p \quad \quad \text{(1-Lipschitz, Lip_Constant=1)} $$
所以下式成立:
$$ \begin{aligned} ||\tilde{\mathbf{h}}_u^k-\mathbf{h}_u^k||_p&= \left|\left|\sigma\left(\mathbf{W}_a^k \tilde{\mathbf{h}}_u^{k-1}+\mathbf{W}_n^k \sum_{v \in \mathcal{N}(\bar{u})} \mathbf{h}_v^{k-1}\right)-\sigma\left(\mathbf{W}_a^k \mathbf{h}_u^{k-1}+\mathbf{W}_n^k \sum_{v \in \mathcal{N}(u)} \mathbf{h}_v^{k-1}\right)\right|\right|_p\\ &\leq ||\mathbf{W}_a^k(\tilde{\mathbf{h}}_u^{k-1}-\mathbf{h}_u^{k-1}) + \mathbf{W}_n^k (\sum_{v \in \mathcal{N}(\bar{u})} \mathbf{h}_v^{k-1}- \sum_{v \in \mathcal{N}(u)} \mathbf{h}_v^{k-1})||_p \end{aligned} $$
由于对图中的边做扰动,边drop概率 $p_e$通常来说非常小,本文中设置为0.001,因此结构改变不大,所以上式的第二项可以近似为0,那么上式可以改写为如下形式:
$$ ||\tilde{\mathbf{h}}_u^k-\mathbf{h}_u^k||_p \leq ||\mathbf{W}_a^k(\tilde{\mathbf{h}}_u^{k-1}-\mathbf{h}_u^{k-1})||_p $$
根据Cauchy-Schwartz inequality $|\langle\mathbf{u}, \mathbf{v}\rangle|^2 \leq\langle\mathbf{u}, \mathbf{u}\rangle \cdot\langle\mathbf{v}, \mathbf{v}\rangle$,上式可以改写成:
$$ ||\tilde{\mathbf{h}}_u^k-\mathbf{h}_u^k||_p \leq ||\mathbf{W}_a^k(\tilde{\mathbf{h}}_u^{k-1}-\mathbf{h}_u^{k-1})||_p \leq ||\mathbf{W}_a^k||_p ||\tilde{\mathbf{h}}_u^{k-1}-\mathbf{h}_u^{k-1}||_p $$
进而得到下式:
$$ ||\tilde{\mathbf{h}}_u^k-\mathbf{h}_u^k||_p \leq ||\mathbf{W}_a^k||_p ||\tilde{\mathbf{h}}_u^{k-1}-\mathbf{h}_u^{k-1}||_p \leq ||\mathbf{W}_a^k||_p ||\mathbf{W}_a^{k-1}||_p ||\tilde{\mathbf{h}}_u^{k-2}-\mathbf{h}_u^{k-2}||_p \cdots $$
因此下式成立:
$$ \begin{aligned} ||\operatorname{ENC}(\tilde{u})-\operatorname{ENC}(u)||_p & =\left|\left|\tilde{\mathbf{z}}_u-\mathbf{z}_u\right|\right|_p=\left|\left|\tilde{\mathbf{h}}_u^K-\mathbf{h}_u^K\right|\right|_p \leq \prod_{k=1}^K\left|\left|\mathbf{W}_a^k\right|\right|_p\left|\left|\left(\tilde{\mathbf{b}}_u-\mathbf{b}_u\right)\right|\right|_p, \end{aligned} $$
这里考虑 $p=2$的情况,根据spectral norm,有 $||A||_2 =\sqrt{\lambda_{\max}(A^\star A)} = \sigma_{\max}(A)$,即最大 $A$的最大奇异值。所以下式成立:
$$ \begin{aligned} ||\operatorname{ENC}(\tilde{u})-\operatorname{ENC}(u)||_p & =\left|\left|\tilde{\mathbf{z}}_u-\mathbf{z}_u\right|\right|_p=\left|\left|\tilde{\mathbf{h}}_u^K-\mathbf{h}_u^K\right|\right|_p \leq \prod_{k=1}^K \sigma_{\max} (\mathbf{W}_a^k)\left|\left|\left(\tilde{\mathbf{b}}_u-\mathbf{b}_u\right)\right|\right|_p, \end{aligned} $$
因为GNN的激活函数为ReLU,严格满足1-Lipschitz,因此 $\prod_{k=1}^K \sigma_{\max} (\mathbf{W}_a^k)$应等于1,为了是模型每层权重的最大奇异值为1,需要对权重矩阵做spectral normalization:
$$ \tilde{\mathbf{W}}_a^k=\mathbf{W}_a^k / \sigma\left(\mathbf{W}_a^k\right) $$
4. Learning Fair Graph Representations via Automated Data Augmentations (ICLR 2023)
FairAdj和FairGraph对所有图均使用统一的邻接矩阵增强策略。FairAdj要求优化图中边的权重,使得模型预测两个节点无论他们是否在同一个group,他们之间有边连接的概率相同(对所有图均使用这一原则来增强图结构);而FairGraph要求优化图结构,使得不同group节点的分布Wasserstein distance最小。这些方法通过添加**启发式的fairness regularization (上面提到的原则就是这些fairness regularization的启发式规则)**来对表示学习过程施加公平性约束。然而对所有图均使用统一的公平性策略来做数据增强并不合适,不同图的敏感属性不同,敏感属性的分布也不同,因此不同的图可能需要不同的图结构或者节点特征增强策略来适应这些多样化的敏感属性。因此,针对不同图的敏感属性,采用自适应的图结构和节点特征的增强策略,而不是局限在固定的启发式的公平性规则中,是highly desirable solution。
Automated Graph Augmentations
给定一个GNN encoder $g_{\text {enc }}:(A, X) \rightarrow Z \in \mathbb{R}^{n \times d_r}$将每个节点映射为表示向量 $Z$。基于 $Z$可以自适应生成增强图。
Edge Perturbation: 基于 $Z$生成增强图的结构:
$$ Z_A=\operatorname{MLP}_A(Z), \quad \widetilde{A^{\prime}}=\sigma\left(Z_A Z_A^T\right), \quad A_{i j}^{\prime} \sim \operatorname{Bernoulli}\left({\widetilde{A^{\prime}}}_{i j}\right) \text { for } i, j=1, \cdots, n $$
其中 $\operatorname{MLP}_A$是结构增强器的训练参数, $\sigma(\cdot)$是sigmoid函数。增强图的邻接矩阵从Bernoulli分布 $\operatorname{Bernoulli}\left({\widetilde{A^{\prime}}}\right)$中采样。
Node Feature Masking: 基于 $Z$来自适应mask节点特征矩阵中的元素:
$$ \begin{aligned} &Z_X =\operatorname{MLP}_X(Z), \\ &\widetilde{M}=\sigma\left(Z_X\right), \\ &M_{i j} \sim \operatorname{Bernoulli}\left(\widetilde{M}_{i j}\right) \text { for } i, j=1, \cdots, n, \\ &X^{\prime}=M \odot X \end{aligned} $$
$\operatorname{MLP}_A$是特征增强器的参数,node feature mask矩阵从Bernoulli分布 $M_{i j} \sim \operatorname{Bernoulli}\left(\widetilde{M}_{i j}\right)$采样,然后与原特征矩阵 $X$。
在端到端的模型优化中,从Bernoulli distribution中采样邻接矩阵和featre masking矩阵是不可微的。为了使 $g$是端到端可训练的,Bernoulli distribution的采样操作可以使用Gumbel-Softmax reparameterization trick来模拟。具体来说,给定一个由模型 $\varphi$输出的概率 $\widetilde{P}$,那么可以通过添加一个从Gumbel分布中采样的随机变量 $G$来作为概率 $\widetilde{P}$的连续近似(continuous approximation): $\hat{P}=\frac{1}{1+\exp (-(\log \widetilde{P}+G) / \tau)}$。那么该概率下的伯努利分布采样值为 $P=\left\lfloor\hat{P}+\frac{1}{2}\right\rfloor$,这个从 $\hat{P}$中得到采样值可以近似作为 $\widetilde{P}$的采样值。在反向传播计算梯度的时候,计算的使 $\hat{P}$关于可训练参数 $\varphi$的梯度。
Adversarial Training
由于图中那些边以及节点的哪些属性会导致出现不公平的预测是未知的,因此使用对抗训练的方法来学习一个图增强器 $g$,用上文提到的方式来生成增强图的结构和节点特征,所得到的增强要尽可能与敏感属性无关,也就是判别器 $k$要无法建立增强图与敏感属性之间的关系。此时可以认为图增强器 $g$生成的增强图与敏感属性无关。
具体来说,判别器 $k:\left(A^{\prime}, X^{\prime}\right) \rightarrow \hat{S} \in[0,1]^n$用来基于增强图来预测每个节点的敏感属性值,预测损失越低说明增强图和敏感属性之间的关系越弱。因此对抗训练来学习图增强器的过程为以下优化问题:
$$ \begin{aligned} \min_g \max_k L_{\mathrm{adv}}&=\min_g \max_k \frac{1}{n} \sum_{i=1}^n\left[S_i \log \hat{S}_i+\left(1-S_i\right) \log \left(1-\hat{S}_i\right)\right] \\ &= \min_g \max_k -\operatorname{CE}\left(S, \hat{S}\right) \end{aligned} $$
上面的优化目标可以改写为:
$$ \max_g \min_k \operatorname{CE}\left(S, \hat{S}\right) = \max_g \min_k \operatorname{CE} \left(S, k(g(A, X))\right) $$
上式的优化过程可以总结如下:固定判别器 $k(\cdot, \cdot)$,优化z
固定判别器 $k(\cdot, \cdot)$,优化图增强器 $g$,使得CE loss最大化,即通过 $g$来生成的增强图 $g(A,X) = A^\prime, X^\prime$要使得 $k$无法利用它们来预测每个节点的敏感属性值,也就是 $g$需要生成与敏感属性无关的增强图。
固定图增强器 $g$,优化判别器 $k(\cdot, \cdot)$,使得CE loss最小化,即对于当前得到的增强图 $\left(A^{\prime}, X^{\prime}\right)$,需要一个更强的判别器 $k(\cdot, \cdot)$来建立增强图与敏感属性的关系,也就是用增强图来预测每个节点的敏感属性。
这种对抗训练的过程可以让增强器 $g$生成尽可能难以被用来预测敏感属性的图结构,而判别器 $k$则要尽可能建立增强图与敏感属性之间的关联。当对抗训练收敛时,可以认为 $g$足以生成无法与敏感属性建立起关系的增强图 $\left(A^{\prime}, X^{\prime}\right)$。
这种图增强的方法来减轻敏感属性对预测的影响是自适应的,并没有基于确定的规则regularization(比如intra/inter group相似度,distribution相似度),对于不同的图会自适应地学习与敏感属性关系最低的对应增强图。因此相对于基于fairness regularization的方法,更加通用。
5. FMP: Toward Fair Graph Message Passing against Topology Bias (Arxiv 2022)
Topology bias 指的是在许多现实世界graph中,具有相同敏感属性(除了节点特征外的敏感属性,如性别,国籍等)的节点更可能相互连接。本文证明了message passing中的聚合过程会在node representation中积累偏差。
给定一个有 $n$个节点的图 $\mathcal{G}=\{\mathcal{V}, \mathcal{E}\}$,节点的(binary)敏感属性是一个 $n$维向量 $\mathbf{s} \in\{-1,1\}^n$,表示每个节点的敏感属性取值。图中节点敏感属性的指示向量(incident vector)定义为:
$$ \Delta_{\mathbf{s}}=\frac{\mathbb{1}_{>0}(\mathbf{s})}{\left|\left|\mathbb{1}_{>0}(\mathbf{s})\right|\right|_1}-\frac{\mathbb{1}_{>0}(-\mathbf{s})}{\left|\left|\mathbb{1}_{>0}(-\mathbf{s})\right|\right|_1} $$
其中 $\left|\left|\mathbb{1}_{>0}(\mathbf{s})\right|\right|_1$等于敏感属性为1的节点数 $n_1$, $\left|\left|\mathbb{1}_{>0}(-\mathbf{s})\right|\right|_1$等于敏感属性为-1的节点数。若 $s_i=1$,那么 $\mathbb{1}_{>0}(\mathbf{s}_i)=1$, $\mathbb{1}_{>0}(-\mathbf{s}_i)=0$,则 $\Delta_{\mathbf{s}_i} = \frac{1}{n_1}$;同理,若 $s_i=0$,那么 $\Delta_{\mathbf{s}_i} = -\frac{1}{n_{-1}}$,其中 $n_{-1}$表示敏感属性为-1的节点数。因此normalized incident vector $\Delta_{\mathbf{s}} = \{\frac{1}{n_1}, -\frac{1}{n_{-1}}\}^n$。
Definition 1 (Label and Sensitive Homophily Coefficient) Label homophily coefficient: $$ \epsilon_{\text {label }}(\mathcal{G}, \mathbf{y})=\frac{1}{|\mathcal{E}|} \sum_{(i, j) \in \mathcal{E}} \mathbb{1}\left(\mathbf{y}_i=\mathbf{y}_j\right) $$
表示连接相同label节点的边占总边数的比例。
Sensitive homophily coefficient:
$$ \epsilon_{\text {sens }}(\mathcal{G}, \mathbf{s})=\frac{1}{|\mathcal{E}|} \sum_{(i, j) \in \mathcal{E}} \mathbb{1}\left(\mathbf{s}_i=\mathbf{s}_j\right) $$
表示连接相同敏感属性节点的边占总边数的比例。
GNNs as Graph Signal Denoising
现有的GNN如GCN, SGC, APPNP等均可以看作以不同的方式(直接求导或梯度下降)来优化signal denoising函数:
$$ \min_\mathbf{F} h_s(\mathbf{F}) = \min_\mathbf{F}\frac{\lambda_s}{2} \operatorname{tr}\left(\mathbf{F}^T \tilde{\mathbf{L}} \mathbf{F}\right)+\frac{1}{2}\left|\left|\mathbf{F}-\mathbf{X}_{\text {trans }}\right|\right|_F^2 $$
用来enforce smoothnes以及保持和输入特征的相似度。
The Optimization Framework
在优化 $\mathbf{F}$的同时, $\mathbf{F}$要满足公平性约束fairness objective $\left|\left|\boldsymbol{\Delta}_s S F(\mathbf{F})\right|\right|_1$:
$$ \min_{\mathbf{F}} \underbrace{\frac{\lambda_s}{2} \operatorname{tr}\left(\mathbf{F}^T \tilde{\mathbf{L}} \mathbf{F}\right)+\frac{1}{2}\left|\left|\mathbf{F}-\mathbf{X}_{\text {trans }}\right|\right|_F^2}_{h_s(\mathbf{F})}+\underbrace{\lambda_f\left|\left|\boldsymbol{\Delta}_s S F(\mathbf{F})\right|\right|_1}_{h_f\left(\boldsymbol{\Delta}_s S F(\mathbf{F})\right)} $$
其中 $S F(\mathbf{F})_{ij} = \hat{P}\left(y_i=j \mid \mathbf{X}\right)$表示将节点 $v_i$预测label为 $j$的概率,而 $S F(\mathbf{F})_{i:}$ 表示节点 $v_i$的预测logits向量,所以 $S F(\mathbf{F}) = \operatorname{Softmax}(\mathbf{F})$。
由于$\Delta_{\mathbf{s}} = \{\frac{1}{n_1}, -\frac{1}{n_{-1}}\}^n$用来指示每个节点的敏感属性,因此 $\boldsymbol{\Delta}_s S F(\mathbf{F}) \in \mathbb{R}^n$。那么 $\boldsymbol{\Delta}_s S F(\mathbf{F})$的第 $j$个元素 $\boldsymbol{\Delta}_s S F(\mathbf{F})_j = \boldsymbol{\Delta}_s \cdot \operatorname{Softmax}(\mathbf{F})_{:,j}$,因此, $\boldsymbol{\Delta}_s S F(\mathbf{F})_j$等于敏感属性$s=1$的节点预测为label $j$的平均概率 与 $s=-1$的节点预测为label $j$的平均概率 之差:
$$ \left(\Delta_s S F(\mathbf{F})\right)_j = \hat{P}\left(y_i=j \mid \mathbf{s}_i=1, \mathbf{X}\right)-\hat{P}\left(y_i=j \mid \mathbf{s}_i=-1, \mathbf{X}\right) $$
其中 $\hat{P}\left(y_i=j \mid \mathbf{s}_i=1, \mathbf{X}\right)$表示敏感属性为 $1$的节点预测为标签 $j$的期望概率。如果 $\left(\boldsymbol{\Delta}_s S F(\mathbf{F})\right)_j$越小,说明模型学习到的node representations $\mathbf{F}$ is equivalent to demographic parity,也就是模型对通过敏感属性划分的sensitive group的预测不会产生偏差,即模型的预测与sensitive attribute无关。
6. EDITS: Modeling and Mitigating Data Bias for Graph Neural Networks (WWW 22)
Bias in attribute:敏感属性划分的demographic group的attribute distribution (除了敏感属性之外的node feature)是不同的
Bias in network structure:敏感属性划分的demographic groups之间的节点邻居分布存在差异
上面两个bias意味着图的feature信息或图的结构信息与敏感属性高度相关
Case 1: 有偏属性和无偏结构。 对于两个demographic group (例如通过敏感属性性别来划分group),bias in attribute意味着两个group中节点的属性分布(除了敏感属性之外的node feature)不同,但是图的连通性与敏感属性无关。这里将male节点的node feature从分布 $\mathcal{N}\left(-1.5,1^2\right)$采样,female节点的node feature从分布 $\mathcal{N}\left(1.5,1^2\right)$中采样。通过这种方式可以让敏感属性和节点特征保持强相关。为了实现无偏网络结构,图中的节点对以 $2\times 10^{-3}$的概率连接。
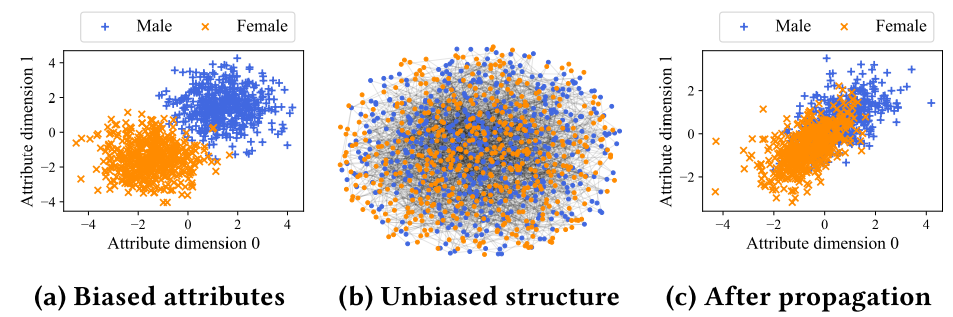
上图(a)是在propagation之前的两个敏感group的node feature分布,(b)可以看出图连通与group无关,(c) 可以看出propagation之后的node representations与(a)中的输入特征相比,2个敏感group节点之间的表示差异变小,说明无偏的结构可以使GNN学到的node representations与敏感属性的相关性降低。
Case 2: 无偏属性和有偏结构。 这里假设所有节点的特征均采样自同一个分布$\mathcal{N}\left(0,1^2\right)$来构造无偏属性。为了构造关于敏感属性的有偏结构,对于每个节点,它的邻居的敏感属性与中心节点的敏感属性相关。首先,为每个节点累加它们的属性值,并且按照降序排列所有节点。取排名最高的前 $t$个male和最低的后 $t$个female构造两个community,在每个community内,节点以 $5\times 10^{-2}$的概率构造边。对于其它节点,以 $1\times 10^{-2}$的概率构造边。如下图所示:
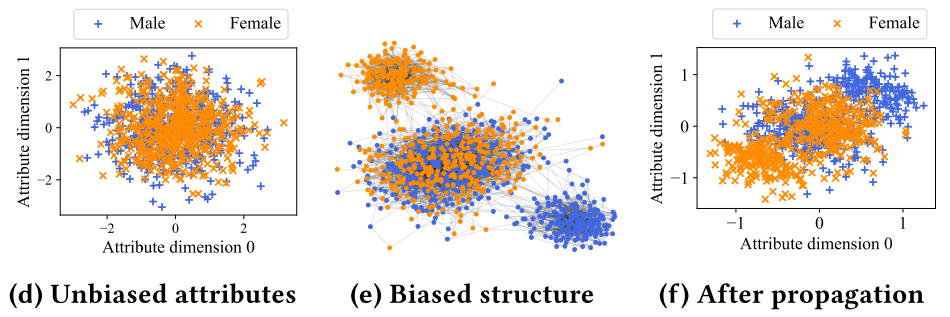
从上图中可以看出,虽然(a)中的原始node feature是与sensitive attribute无关的,但是有偏的network structure会导致propagation之后的node representation会产生与sensitive attribute相关的聚类。
Bias
Definition 1 (Attribute bias) 敏感属性 $i$将节点分为2个demographic groups。如果node feature中的任意属性在2个groups间存在分布差异,那么属性偏差存在。也就是node feature的分布与敏感属性相关。
Definition 2 (Structural bias) Propagate后2个group的节点属性分布出现差异,即 $AX$会导致representation在group间出现分布差异。因此图结构与敏感属性相关。
Objective Function
考虑到节点特征有 $M$个属性,那么用 $P_{0,m}$表示group 0的第 $m$个属性的值分布,用 $P_{1,m}$表示group 1的第 $m$个属性的值分布。
若在structural debiasing阶段,模型propagate $H$次,并计算每次propagate的跨group属性差异。那么第 $h$层( $1 \leq h \leq H$)group 0中节点的第 $m$个属性的值分布为 $P_{0,m}^{(h)}$,group 1中节点的第 $m$个属性值的分布为 $P_{1,m}^{(h)}$。那么对于所有 $H+1$层,group 0 的第 $m$个属性的联合概率分布 $P_{0,m}^{Joint} = P_{0,m}^{(0)} \cdot P_{0,m}^{(1)} \cdot P_{0,m}^{(2)} \cdots P_{0,m}^{(H)}$ ,同理,group 1的第 $m$个属性的联合概率分布 $P_{1,m}^{Joint} = P_{1,m}^{(0)} \cdot P_{1,m}^{(1)} \cdot P_{1,m}^{(2)} \cdots P_{1,m}^{(H)}$。这两个分布可以看作 $H+1$维的随机变量,每个随机变量服从一个分布。模型的参数可以分为2个部分,分别是 $g_{\theta_m}: \mathbb{R} \to \mathbb{R}$,用于mitigate每个节点第 $m$个属性的bias。参数化的邻接矩阵 $\tilde{A}$ 用于mitigate bias from structure。因此,对于第 $m$个attribute,模型的目标函数定义为如下形式:
$$ \min_{\theta_m, \tilde{A}} W(P_{0,m}^{Joint}, P_{1,m}^{Joint}) $$
优化目标是优化第 $m$个属性的“去偏器”参数 $\theta_m$和图结构 $\tilde{A}$,使得2个group原始节点属性分布以及propagate之后的属性分布之间的差异最小,即原始属性分布要在group间无差异,且propagate后的属性分布也要在group间无差异。
联合分布 $P_{0,m}^{Joint}$中的一个样本 $\mathrm{x}_{0, m} \sim P_{0,m}^{Joint}$ 定义为每个概率分布的一个样本 $\mathrm{x}_{0, m}=\left[x_{0, m}^{(0)}, x_{0, m}^{(1)}, \ldots, x_{0, m}^{(H)}\right]$。而group 1的第 $m$个属性服从联合分布 $P_{1,m}^{Joint}$,那么它的一个样本可以视为从每个分布中采样一个样本的组合 $\mathrm{x}_{1, m}=\left[x_{1, m}^{(0)}, x_{1, m}^{(1)}, \ldots, x_{1, m}^{(H)}\right]$。
上面目标函数用Wasserstein distance 来表示,其中 $\gamma$表示两个分布间的一种传输方案,Wasserstein distance则表示两个分布中样本的平均差异:
$$ W(P_{0,m}^{Joint}, P_{1,m}^{Joint})= \inf_{\gamma\in \Pi(P_{0,m}^{Joint}, P_{1,m}^{Joint})} \mathbb{E}_{(\mathrm{x}_{0, m},\mathrm{x}_{1, m}) \sim \gamma} \left[||\mathrm{x}_{0, m}-\mathrm{x}_{1, m}||_1\right] $$
因此模型优化的目标函数是要使2个group联合概率分布中样本的平均差异最小。
考虑所有 $M$个属性,模型的目标函数为:
$$ \min_{\theta, \tilde{A}} \frac{1}{M} \sum_{1 \leq m \leq M} W\left(P_{0, m}^{Joint }, P_{1, m}^{Joint }\right) $$