1. Label Information Enhanced Fraud Detection against Low Homophily in Graphs (WWW ‘23)
Introduction
GNN4FD存在问题: 大多数基于GNN的欺诈检测器难以泛化到low homophily网络中,除此之外,如何充分利用label信息也是Fraud detection的重要因素。即如果一个Fraud node的邻居都是benign nodes,那么这样的图就是heterophily or low homophily graph,由于GNN的neighborhood aggregation机制,target node的表示会和它的邻居相似,无论他们的label是否不同,这样会使得GNN难以区分位于异质邻域内的Fraud nodes。另外, 现有的GNN4FD方法利用label信息的能力有限,这些方法仅在训练阶段使用label信息作为监督信号,但是在设计message passing 机制的过程中并没有使用label信息。
为了解决上述2个挑战,本文提出GAGA: 基于分组聚合的Transformer。 GAGA首先提出了一种预处理策略Group Aggregation (GA, 分组聚合),然后每个节点的原始邻居特特征被分组为序列数据。 然后提出一种科学系的编码方式来编码structural,relational 和label信息 (全局),即整个图的relational encoding,group encoding 和 hop encoding (图中又几个relation就有几个relational embedding,取几个hop就又几个hop embedding..)。 最后用多头attention为每个节点聚合embedding sequence.
Preliminaries
Multi-relational fraud graph construction Multi-relational fraud graph $\mathcal{G}(\mathcal{V}, \mathcal{E}, \mathcal{X}, \mathcal{Y})$, 其中节点集$\mathcal{V}=\left\{v_1, v_2, \ldots, v_N\right\}(N=|\mathcal{V}|)$,$R$ 个邻接矩阵$\mathcal{E}=\left\{\mathbf{A}_1, \mathbf{A}_2, \ldots, \mathbf{A}_R\right\}(R=|\mathcal{E}|)$的多关系图 ($R$个关系)。节点feature vectors $X=\left\{\mathbf{x}_1, \mathrm{x}_2, \ldots, \mathrm{x}_N\right\}$以及节点的label集合$\mathcal{Y}$。 对于一个relation的邻接矩阵$\mathbf{A}_r$,如果$\mathbf{A}_1[u,v]=1$,那么在关系$r$下节点$u$和$v$被连接。每个节点$v \in \mathcal{V}$ 有一个$d$维feature vector $\mathbf{x}_v \in \mathbb{R}^d$。 在基于Graph的fraud detection中,我们考虑半监督场景,其中一小部分节点 $\hat{\mathcal{V}} \supset \mathcal{V}$是有label的 ($y=1$表示该节点为fraud node,$y=0$表示该节点为benign node)所以对于fraud graph,节点class数为2。
GAGA
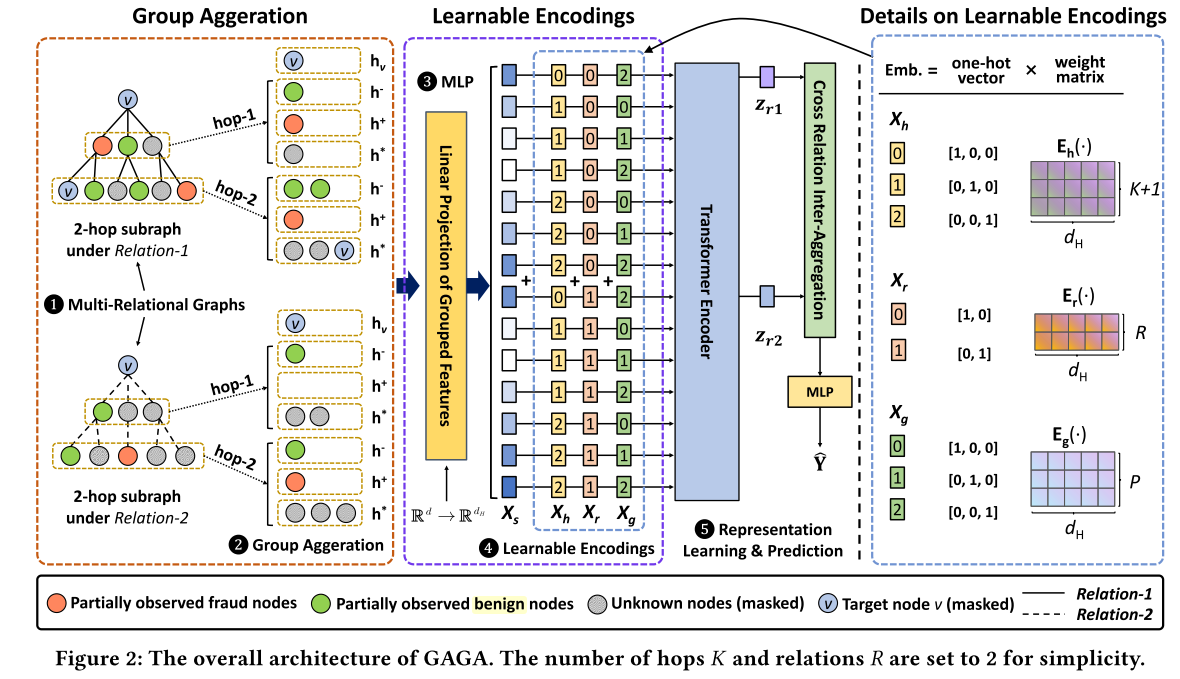
上图为GAGA的框架。第一步为Group Aggregation,为预处理过程,为每个节点计算多条邻居信息,并且每跳内的信息分组表示(一跳内 label=0,label=1,label=None的节点分别聚合)。这样会为每个节点生成一系列embeddings。第二步中,定义三种类型可学习的embeddings:hop embeddings, relation embeddings,group embeddings,即如果每个节点有$K$-hop邻居参与聚合,那么hop embeddings 是一个$K \times d_H$ 矩阵,每个hop(结构特征)用一个$d_H$维向量表示。 同理relational embedding是一个$R \times d_H$矩阵,每个relation 用一个$d_H$维向量表示。一共存在3种group($y=1$的group, $y=0$的group, 无标签邻居的group),所以group embeddings是一个$3 \times d_H$的矩阵,每种group 表示为一个$1 \times d_H$的向量。
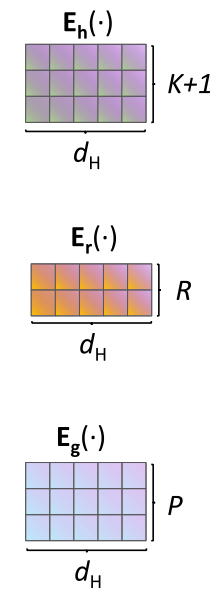
对于第一步得到的某一个节点$v$在relation 0的邻接矩阵$\mathbf{A}_0$下的第2跳邻居的fraud neighbors ($y=1$)的group embedding $g_v (r=0, h=2, y=1)$,为这个embedding融合hop信息 + relation信息+ group 信息得到 $x_v = g_v (r=0, h=2, y=1) + E_h(1) + E_r(0) + E_g(1)$ 关于节点$v$的某个group的融合结构,关系特征的表示向量。最后一步将一个节点的所有多关系多hop的group向量用transformer合并然后输入MLP种来预测节点label。
即一个节点会生成 $\#relation (\#hop * (\#class+1) + 1)$个group 向量,每个group向量属于某个relation下的某个hop,这个group向量属于那个relation就加上这个relation的一维encoding,属于那是个hop就加上这个hop的1维encoding,这个group是0/1/None group就再加上对应group的encoding,从而得到这个group的最终encoding。
Group Aggregation
对于Fraud detection任务,每个节点的label有3种情况,分别为 benign node $y=0$, Fraud node $y=1$, unlabeled node $y = None$,所以对于每个节点,它的第$k$hop邻居可以被分为3个group,每个group的节点做聚合: $$ \mathbf{H}_g^{(k)}=\left[\mathbf{h}^{-}, \mathbf{h}^{+}, \mathbf{h}^*\right]^{(k)} \text { given } \hat{\mathcal{N}}_k(v) $$ 表示节点$k$ hop内的3个group表示向量 (由每个group节点取平均得到)。那么对于关系$r$下的所有$K$个hop内的group embedding可以表示为: $$ \mathbf{H}_r=||_{k=1}^K \mathbf{H}_g^{(k)}, $$ 那么对于所有$R$个关系,所涉及的group embedding sequence表示为: $$ \mathbf{H}_s=||_{r=1}^R \mathbf{H}_{v, r} . $$ 关于每个节点,共有$S=R \times(P \times K+1)$个group embeddings。其中$R$为relation数, $K$为hop数,$K = \#class +1$ 为label数+1 (有多少种group)。
Learnable Encoding for Graph Transformer
先将每个节点的所有$S$个group embeddings过一下MLP得到$\mathbf{X}_s \in \mathbb{R}^ {S\times d_H}$。用nn.Embedding来定义一个$K \times d_H$的可训练的Hop encoding 矩阵$E_h(\cdot)$,每行表示一种hop的embedding。 对于节点的$S$个group 向量,每个group向量都属于一个hop种,那么这个group embedding 就+对应hop的embedding,从而融合结构特征。 比如$X_s[3]$是hop 2的 group embedding,那么这个group embedding 就要加上 $E_h(1)$ 来保留hop结构特征。所有$S$个group embedding 都要融合各自的hop特征,他们的hop 特征为: $$ \begin{gathered} \mathbf{X}_h=[\underbrace{\mathbf{E}_h(0), \overbrace{\mathbf{E}_h(1), \mathrm{E}_h(1), \mathrm{E}_h(1)}^{1 \text { st hop }}, \ldots, \overbrace{\mathrm{E}_h(K), \mathrm{E}_h(K), \mathbf{E}_h(K)}^{K-\text { th hop }}}_{1 \text { st relation }}, \\ \ldots, \underbrace{\mathbf{E}_h(0), \mathrm{E}_h(1), \mathrm{E}_h(1), \mathrm{E}_h(1), \ldots, \mathrm{E}_h(K), \mathrm{E}_h(K), \mathrm{E}_h(K)}_{R \text {-th relation }}] \end{gathered} $$ $S$中1-st到R-th relation的所有1hop group embedding都要加上hop 1 的encoding $E_h(1)$,对于其他hop的group embedding 同理。$\mathbf{X}_s$ 表示一个节点的所有$S$个group embedding,每个group embedding 要加上它所在的relation encoding $E_r(\text{relation of group})$,hop encoding $E_h(\text{hop of group})$ 以及它属于那个group $E_g (\text{label of group})$: $$ \mathrm{X}_{i n}=\mathrm{X}_s+\mathrm{X}_h+\mathrm{X}_r+\mathrm{X}_g $$ $\mathbf{X}_in$为一个节点新的group embeddings。每个节点的每个group embedding 都要融合它所在的hop 特征,所在的relation特征和所在的label特征(group 特征)然后用transformer将一个节点所有$S$个融合丰富特征的group embedding 做聚合,从而得到这个节点的最终embedding,用这个最终embedding来计算binary classification loss。
2. GCCAD: Graph Contrastive Coding for Anomaly Detection (TKDE)
本文的目标:拉近normal nodes和global embedding的距离,拉远fraud nodes和global embedding的距离。inference阶段通过计算testing node和global embedding的距离来判断节点是否为fraud node。
Preliminary Observations
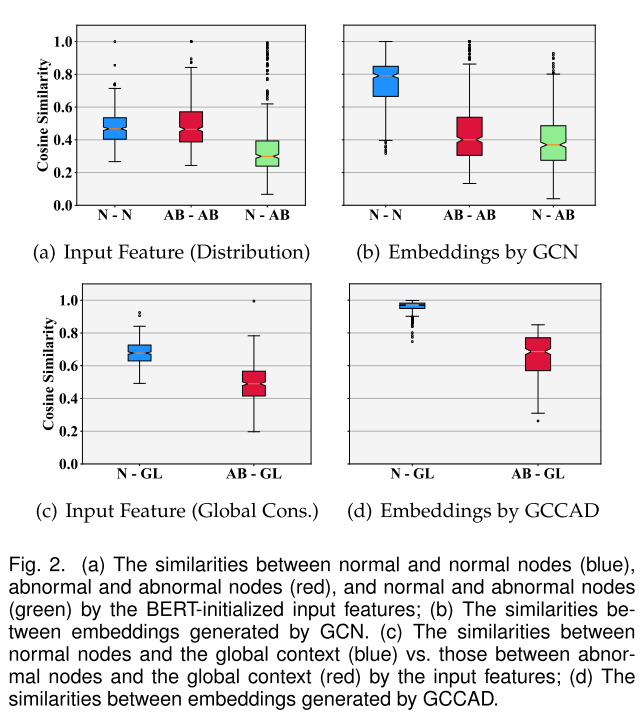
上图中N-N表示Normal nodes之间的相似度,AB-AB表示Abnormal nodes之间的相似度,N-AB表示Normal nodes和Abnormal nodes之间的相似度,从图(a)中可以发现N-N节点原始之间的相似度差别很大,即normal nodes之间的相似度差别很大,相似度范围在$[0.2,0.8]$, 而abnormal nodes之间的相似度差别也很大。从图(a)中还可以看出,normal nodes (N)和abnormal nodes (AB)原始特征之间有很大一部分是相似的。从图(b)中可以看出,当使用GCN学习到新的节点feature vectors后,normal nodes之间的相似度(N-N)得到了提升,即从$[0.2,0.8]$改善到$[0.4,1.0]$,但是N-N,AB-AB内部的相似度依然变化较大,并且依然存在大量高相似度的N-AB。
从图(c)可以看出normal nodes的原始特征和global embedding (N-GL)之间相似度较高,并且相似度变化范围小。而Abnormal nodes和global embedding (AB-GL)之间的相似度较低,并且N-GL相似度和AB-GL相似度更好区分。所以通过与global embedding之间的相似度来区分normal nodes和abnormal nodes可能更加有效。而本文提出的GCCAD会进一步提升normal nodes和global emb之间的相似度,并且更加容易区分N-GL相似度与AB-GL相似度。
GCCAD Model
GCCAD基于监督对比学习来优化node embeddings和global embeddings,目标函数如下: $$ \mathcal{L}_{\text {con }}=\underset{\substack{i: y_i=0 \\ j: y_j=1}}{\mathbb{E}}\left[-\log \frac{\exp \left(\mathbf{q}^{\top} \boldsymbol{h}_i / \tau\right)}{\sum_j \exp \left(\boldsymbol{q}^{\top} \boldsymbol{h}_j / \tau\right)+\exp \left(\boldsymbol{q}^{\top} \boldsymbol{h}_i / \tau\right)}\right] $$ 其中$\boldsymbol{q}$为global embedding,$\boldsymbol{h}_i$为normal node $v_i$的embedding。基于上述supervised contrastive loss,训练目标为增大训练集中normal nodes和global embedding的相似度,减少abnormal nodes和global embedding的相似度。即使得global embedding尽可能不受abnormal nodes的影响。
另外 本文不直接在原图上训练contrastive loss,而是先优化图结构,然后在优化的图结构上训练contrastive loss。由于message passing过程中会使得节点特征局部平滑,而abnormal node通常和位于normal node中,所以MPNN无论如何都会使得abnormal node和周围的normal node变得相似。所以在MPNN前先使用Edge Update模块对图更新,移除潜在的可以links,使得abnormal nodes尽可能少的接受到normal node的信息。本文提出Context-Aware Link Predictor来衡量原图中两个节点的边的保留概率: $$ \begin{array}{r} p_{i j}^{(l)}=\operatorname{MLP}\left(\left(\boldsymbol{h}_i^{(l-1)}-\boldsymbol{h}_j^{(l-1)}\right) \oplus\left(\boldsymbol{h}_i^{(l-1)}-\boldsymbol{q}^{(l-1)}\right)\right. \left.\oplus\left(\boldsymbol{h}_j^{(l-1)}-\boldsymbol{q}^{(l-1)}\right)\right) \end{array} $$ 两个节点间边的保留概率和两个节点间的embedding相似度有关(第1项),也和节点与global emb相似度有关。然后用训练集中标注好的normal nodes和abnormal nodes来训练$p_{i j}^{(l)}$: $$ \mathcal{L}_{\text {link }}=\mathbb{E}\left[\sum_{i, j: y_i=y_j=0}-\log p_{i j}^{(l)}-\sum_{i, j: y_i \neq y_j=0}\left(1-\log p_{i j}^{(l)}\right)\right] $$ 通过这种方式,来将潜在的与abnormal nodes连接的边移除,从而使得abnormal node在message passing过程减少收到normal node的影响。基于每条边的保留概率,基于Bernoulli 分布来采样edges从而得到边mask 矩阵 $I^{(l)}$。新的图结构定义为: $$ A_{i j}^{(l)}=\left(\alpha A_{i j}^{(l-1)}+(1-\alpha) p_{i j}^{(l)}\right) \odot I_{i j}^{(l)} $$ 反向传播时$I$视为常量,梯度从$p_{ij}$走。得到新的图结构后用GNN学习图的node embeddings。最后基于得到的node embeddings计算每个node embedding 和global embedding $\boldsymbol{q}$ 的相似度 ($\boldsymbol{q}$初始化为所有节点初始feature的均值): $$ s_i^{(l)}=\operatorname{cosine}\left(\boldsymbol{h}_i^{(l)}, \boldsymbol{m}\right) $$ 然后基于每个节点和global emb之间的相似度来计算聚合权重: $$ \alpha_i^{(l)}=\frac{\exp \left(s_i^{(l)}\right)}{\sum_{j=1}^N \exp \left(s_j^{(l)}\right)} $$ 聚合node emb得到global emb: $$ \boldsymbol{q}^{(l)}=\sum_{i=1}^N \alpha_i^{(l)} \cdot \boldsymbol{h}_i^{(l)} $$ Training and Inference
每个epoch 基于得到的global emb $\boldsymbol{q}$以及node embeddings $\boldsymbol{h}$ 来计算supervised contrastive loss,从而同时优化node embs和global embs。测试阶段,将测试节点的emb计算和global emb之间的相似度,相似度越低,测试节点是abnormal nodes的可能性越大。
3. H2-FDetector: A GNN-based Fraud Detector with Homophilic and Heterophilic Connections (WWW ‘22)
Introduction
Fraud graph通常包含2种类型的实体关联:1. homophilic connections: 相同label的节点被连接。 2. heterophilic connections: 不同label的节点被连接(fraudster 和 benign)。对于同时存在homophily 和heterophily的fraud graph,存在以下挑战:(1)如何学习一个边判别器,来判断图中的边是homophilic (两端都是benign 或 fraud) 还是 heterophilic (边一端是fraud一端是benign)。(2)如何为同时包含homophilic和heterophilic connections的fraud graph设计GNN。 (3) 如何利用整个类别的特征来判别新的fraud node? 即fraud node除了捕获与其邻居中benign nodes不相似的信息,还要捕获其他fraudster的信息,所以本方法让每个节点的表示和它所在类别的category feature相似,来捕获其他fraud 节点的特征。
Methodology
H$^2$-connection Identification
训练一个边判别器来预测图中任意一条边是homophilic edge还是heterophilic edge,基于训练集中的节点label。对于第$l$层的node embedding $H^{(l-1)}=\left\{h_1^{(l-1)}, h_2^{(l-1)}, \ldots, h_N^{(l-1)}\right\}$。对于图中的每条边 $e_{uv}$,定义一个可训练的判别器来判断该边是homophilic还是heterophilic。 首先: $$ \begin{aligned} & \bar{h}_u^{(l)}=\sigma\left(W_t^{(l)} h_u^{(l-1)}\right) \\ & \bar{h}_v^{(l)}=\sigma\left(W_t^{(l)} h_v^{(l-1)}\right) \end{aligned} $$ 其中$W_t^{(l)} \in \mathbb{R}^{d_l \times d_{l-1}}$是边判别器的可学习参数。然后基于$\bar{h}_u^{(l)}$和$\bar{h}_v^{(l)}$来计算边$e_{uv}$的homophilic分数。边的homophilic分数通过对两个节点的拼接 以及两个节点的不同来计算,$W_c^{(l)}$也是边判别器的参数,用于输出边分数: $$ m_{u v}^{(l)}=\tanh \left(W_c^{(l)}\left[\bar{h}_u^{(l)}||\bar{h}_v^{(l)}||\left(\bar{h}_u^{(l)}-\bar{h}_v^{(l)}\right)\right]\right) $$ 其中 $\mathrm{tanh}(\cdot) \in (-1,1)$。根据$m_{u v}^{(l)}$的符号来判断$e_{uv}$是homo还是hetero: $$ c_{u v}^{(l)}=\operatorname{SIGN}\left(m_{u v}^{(l)}\right) $$ 基于第$l$层的embedding输入边判别器中,可以得到所有边是homophilic还是heterophilic: $$ C^{(l)}=\left\{c_{u v}^{(l)}\right\}_{e_{u v} \in \mathcal{E}} $$ 因为边判别器的输出是$\{-1,1\}$,所以对于训练集中的homophilic边,$y_{uv}=1$,那么$m_{u v}^{(l)}$要逼近1。同理对于heterophilic边,$y_{uv}=-1$,那么$m_{u v}^{(l)}$要逼近-1。即最小化以下目标: $$ \mathcal{L}_{H I}^{(l)}=\frac{1}{\mathcal{E}_t} \sum_{e_{u v}}^{\mathcal{E}_t} \max \left(0,1-y_{u v} m_{u v}^{(l)}\right) $$
H$^2$-connection Aggregation
对于第$r$个relation下的图$\mathcal{G}_r=\left\{\mathcal{V}, X,\left\{\mathcal{E}_r\right\}, Y\right\}$,$\mathcal{N}_r(v)$表示关系$r$下节点$v$的邻居,$u \in \mathcal{N}_r(v)$。计算$u$对中心节点$v$重要性分数时考虑他们之间的边是homo边还是hetero边,所以在计算边$e_{vu}$间的重要性系数时考虑$c_{uv}^{(l)}$: $$ e_{u v}^{(l), r}=a^{(l), r}\left[W_r^{{l}} h_v^{(l-1)} || c_{u v}^{(l)} W_r^{(l)} h_u^{(l-1)}\right] $$ 其中 attention mechanism权重向量$a^{(l), r} \in \mathbb{R}^{1 \times 2d_l}$。类似于GAT,邻居聚合的attention系数如下: $$ \alpha_{u, v}^{(l), r}=\frac{\exp \left\{\operatorname{LeakyReLU}\left(e_{u v}^{(l), r}\right)\right\}}{\sum_{k \in \mathcal{N}_r(v)} \exp \left\{\operatorname{LeakyReLU}\left(e_{k v}^{(l), r}\right)\right\}} $$ 考虑多头attention,并且在邻居聚合的时候考虑边类型: $$ h_v^{(l), r}=||_{k=1}^K \sigma\left(\sum_{u \in \mathcal{N}_r(v)} \alpha_{u, v}^{(l), r, k} c_{u v}^{(l)} W_r^{(l), k} h_u^{(l-1)}\right) $$ 对于$R$个relation,将每个节点每层输出$h_v^{(l), r}$的所有$R$个关系拼接后做特征变换,得到融合多关系的节点embedding: $$ \begin{aligned} & h_v^{(l), \text { all }}=||_{r=1}^R h_v^{(l), r} \\ & h_v^{(l)}=W_d^{(l)} h_v^{(l), \text { all }} \end{aligned} $$ 其中$W_d^{(l)} \in \mathbb{R}^{d_l \times R d_l}$。最后一层输出维度为2,并做softmax: $$ p_v=\operatorname{softmax}\left(h_v^{(L)}\right) $$ 用cross-entropy 训练GNN: $$ \mathcal{L}_o=-\sum_{v \in \mathcal{V}_t}\left[y_v \log \left(p_v\right)+\left(1-y_v\right) \log \left(1-p_v\right)\right] $$
Prototype Extraction
除了训练边类型判别器H$^2$-connection Identification $\mathcal{L}_{H I}$,节点embedding类型判别器$\mathcal{L}_o$外,节点的每层embedding要和该节点所属的类embedding(prototype embedding)相似。类的prototype embedding: $$ \begin{aligned} \operatorname{prototype}_{\text {fraud }}^{(l)} & =\frac{1}{\left|\mathcal{V}_f\right|} \sum_{v \in \mathcal{V}_f} h_v^{(l)} \\ \operatorname{prototype}_{\text {benign }}^{(l)} & =\frac{1}{\left|\mathcal{V}_b\right|} \sum_{v \in \mathcal{V}_b} h_v^{(l)} \end{aligned} $$ distance between node $v$ and two prototype: $$ \begin{aligned} & \mathcal{D}_f^{{l}}(v)=|| h_v^{(l)}-\text { prototype }_{f r a u d}^{(l)} ||_2 \\ & \mathcal{D}_b^{{l}}(v)=|| h_v^{(l)}-\text { prototype }_{\text {benign }}^{(l)} ||_2 \end{aligned} $$ $v$到两个prototype 的距离可以用softmax来输出一个2维概率向量,用来匹配他的ground truth one-hot label: $$ \begin{gathered} \mathcal{L}_{P E}^{(l)}=-\sum_{v \in \mathcal{V}_t}\left[y_v \log \left(q_v^{(l)}\right)+\left(1-y_v\right) \log \left(1-q_v^{(l)}\right)\right] \\ q_v^{(l)}=\operatorname{softmax}\left(-\mathcal{D}_{C(v)}^{(l)}(v)\right) \end{gathered} $$ 最终的训练目标为: $$ \mathcal{L}=\mathcal{L}_o+\gamma_1 \sum_{l-1}^L \mathcal{L}_{H I}^{(l)}+\gamma_2 \sum_{l=1}^L \mathcal{L}_{P E}^{(l)} $$
4. Care-GNN: Enhancing Graph Neural Network-based Fraud Detectors against Camouflaged Fraudsters (CIKM ‘20)
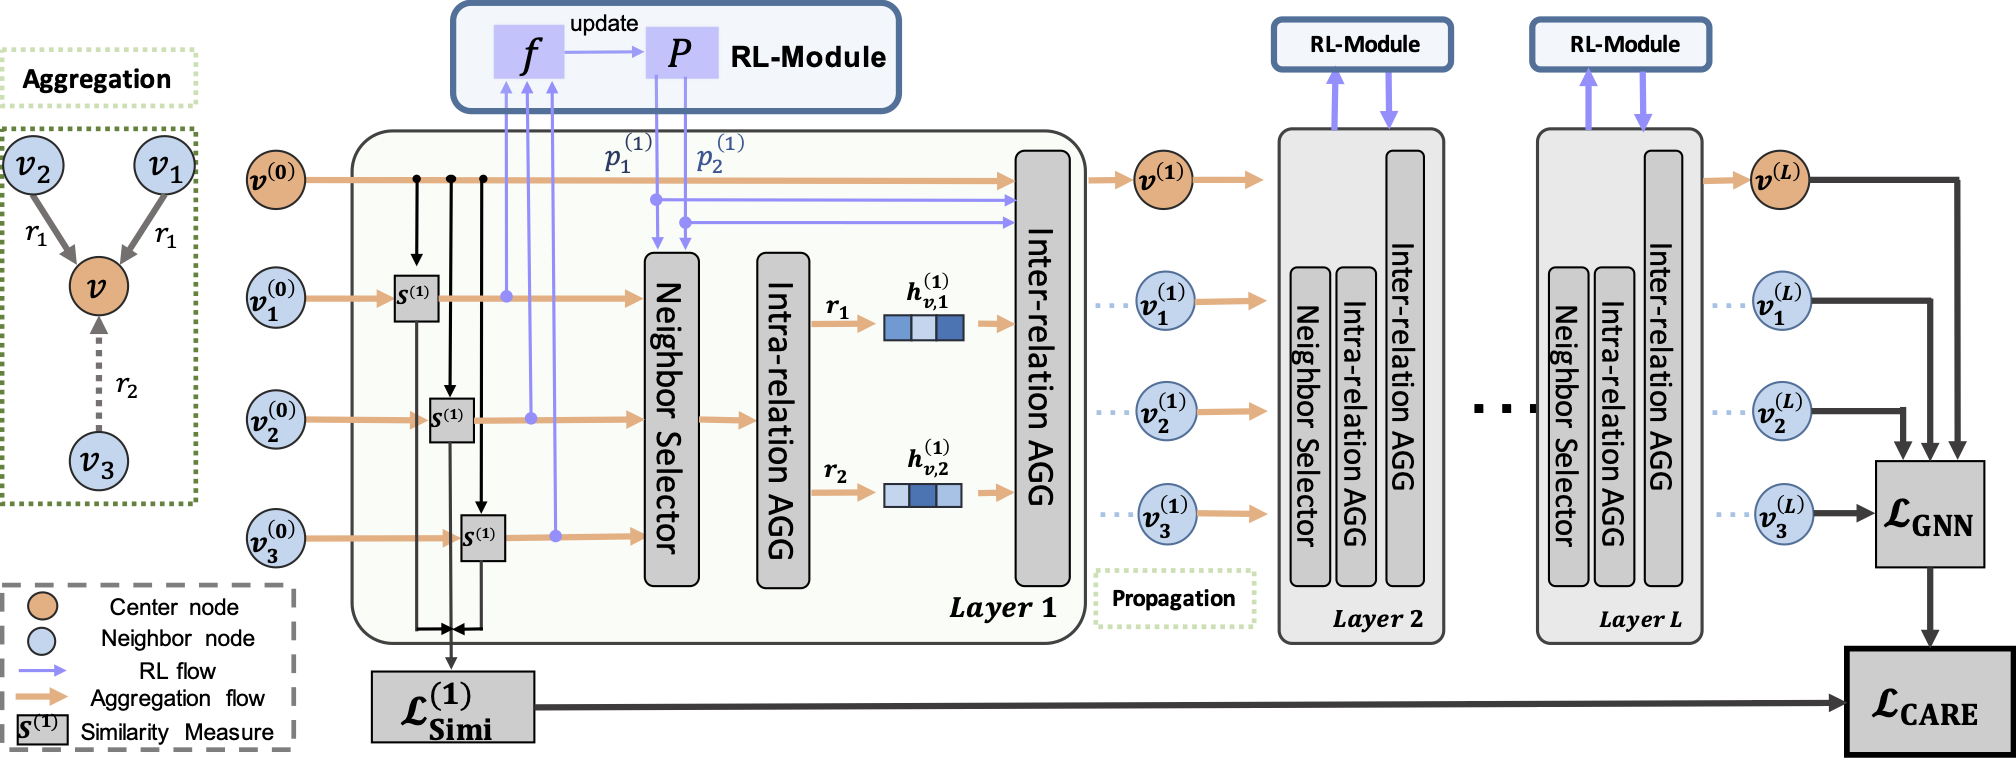
Fraud nodes 在图中有2中类型的伪装(Camouflage)。(1)Feature Camouflage:通过添加一些特殊属性,从而骗过基于特征的一场检测器。(2)Relation Camouflage:Fraud nodes 隐藏在benign nodes中。为了解决两种伪装问题,对于特征伪装,提出一种标签感知的节点相似度衡量指标(label-aware similarity measure)用来为节点找到在特征层面和它最相似的邻居,节点特征基于它的label训练得到。(2)相似度感知的邻居提取器。基于强化学习,在GNN训练过程中自适应的寻找和他最相似的邻居。
Label-aware Similarity Measure
在关系$r$下,中心节点$v$在第$l$层的表示为$\mathbf{h}_v^{(l-1)}$,对于该关系下的关于$v$的边$\left(v, v^{\prime}\right) \in \mathcal{E}_r^{(l-1)}$,他们在该层embeddings之间的$l_1$-distance为: $$ \mathcal{D}^{(l)}\left(v, v^{\prime}\right)=||\sigma\left(M L P^{(l)}\left(\mathbf{h}_v^{(l-1)}\right)\right)-\sigma\left(M L P^{(l)}\left(\mathbf{h}_{v^{\prime}}^{(l-1)}\right)\right)||_1 $$ 基于距离可以直接得到相似度: $$ S^{(l)}\left(v, v^{\prime}\right)=1-\mathcal{D}^{(l)}\left(v, v^{\prime}\right) $$ 其中MLP输出的是一个scalar,然后输出到一个激活函数$\sigma = \tanh \in [-1,1]$中,通过衡量两个节点1维实数表示的距离来评价$v$和它邻居$v^{\prime}$的相似度。其中$M L P^{(l)}$是相似度评价器的参数,目标是基于node label $\{-1,1\}$来训练scalar embedding: $$ \mathcal{L}_{\mathrm{Simi}}^{(l)}=\sum_{v \in \mathcal{V}}-\log \left(y_v \cdot \sigma\left(M L P^{(l)}\left(\mathbf{h}_v^{(l)}\right)\right)\right) $$ $MLP$要使得训练集节点可以正确分类,在这种情况下计算两个节点的相似度。
Similarity-aware Neighbor Selector
对于第$r$个relation,设置第$l$层的邻居采样阈值$p_r^{(l)} \in[0,1]$,表示当前epoch,在关系$r$下第$l$层每个fraud node仅采样和他相似度最高的前$p_r^{(l)}$比例个数的邻居参与聚合。这样可以尽可能为fraud node提取出和他相连的fraud nodes。注意,本文只针对fraud node计算$p_r^{(l)}$,但是该$p_r^{(l)}$会应用到关系$r$第$l$层的所有节点上。因为benign周围的同类型节点占比有绝对优势,所以对$p_r^{(l)}$的大小不敏感,$p_r^{(l)}$不管很大还是很小,都能为它聚合到同类的节点,所以基于fraud node计算的$p_r^{(l)}$来通用在所有节点上。
那么如何设置$p_r^{(l)}$,使得fraud node可以聚合到和它最相似的邻居,从而尽可能过滤掉和它不同类的邻居?由于在训练过程中$p_r^{(l)}$是一个采样概率,采样出的邻居参与聚合,所以$p_r^{(l)}$没有梯度,无法在端到端的训练过程中基于梯度优化。所以为了优化$p_r^{(l)}$,CARE-GNN采用一种基于强化学习的方式,在每个epoch中优化$p_r^{(l)}$。具体来说,代码中只设置了一层GNN,对于一个3relation的图,每个relation下有一个采样概率,$[p_1 ,p_2, p_3]$,初始化为$[0.5, 0.5, 0.5]$,reward初始话为$[0,0,0]$。对于关系$i$下的采样概率$p_i$,第一个epoch先基于初始化概率采样邻居,然后聚合采样出的邻居: $$ \mathbf{h}_{v, r}^{(l)}=\operatorname{ReLU}\left(\mathrm{AGG}_r^{(l)}\left(\left\{\mathbf{h}_{v^{\prime}}^{(l-1)}:\left(v, v^{\prime}\right) \in \mathcal{E}_r^{(l)}\right\}\right)\right) $$ 然后用当前不同relation下的概率$[p_1 ,p_2, p_3]$加权聚合节点$v$在3个relation下的邻居embedding,然后和节点$v$的self-feature聚合,得到每个节点$v$在当前epoch的输出embedding: $$ \mathbf{h}_v^{(l)}=\operatorname{ReLU}\left(\mathrm{AGG}_{a l l}^{(l)}\left(\left.\mathbf{h}_v^{(l-1)} \oplus\left\{p_r^{(l)} \cdot \mathbf{h}_{v, r}^{(l)}\right\}\right|_{r=1} ^R\right)\right) $$ 因为只有一层,所以$\mathbf{h}_v^{(l)} = z_v$。基于$z_v$构造cross-entropy loss来预测node label,其中$z_v$过MLP+softmax: $$ \mathcal{L}_{\mathrm{GNN}}=\sum_{v \in \mathcal{V}}-\log \left(y_v \cdot \sigma\left(M L P\left(\mathbf{z}_v\right)\right)\right) . $$ now current epoch end,当前epoch中,training fraud node 和采样出的邻居平均相似度为: $$ G\left(\mathcal{D}_r^{(l)}\right)^{(e)}=\frac{\sum_{v \in \mathcal{V}_{\text {train }}} \mathcal{D}_r^{(l)}\left(v, v^{\prime}\right)^{(e)}}{\left|\mathcal{V}_{\text {train }}\right|} $$ 第一个epoch后 reward 变为$[1,1,1]$,因为当前的$p_i$使得fraud node采样出了更相似的邻居,那么下一个epoch中就要扩大$p_i$来探索更多相似的邻居,如果下一个epoch在扩大$p_i$后采样到的邻居与中心节点的平均相似度降低,那么reward为-1,下一个epoch要用小一些的$p_i$。通过这种方式,基于每个epoch中中心节点和邻居的相似度,来优化采样概率$p_i$。这个过程和GNN的训练以及Label-aware Similarity Measure的参数训练同时进行,最终的loss func为: $$ \mathcal{L}_{\mathrm{CARE}}=\mathcal{L}_{\mathrm{GNN}}+\lambda_1 \mathcal{L}_{\mathrm{Simi}}^{(1)}+\lambda_2||\Theta||_2 $$
5. Rethinking Graph Neural Networks for Anomaly Detection (ICML ‘22)
由于GNN的neighborhood aggregation机制,位于benign nodes中的anomalies会变得难以区分。现有面向Anomaly Detection的GNN分发可以大概分为3类 (1)采用Attention机制从多个视图聚合不同的邻居;(2)对节点邻居重新采样;(3)设置额外的辅助loss来增强GNN在Fraud graph上的训练能力。但这些方法都是spatial methods,很少从spectral的角度设计模型。然而,选择定制的频谱滤波器是GNN设计的关键组成部分,因为频谱滤波器决定了GNN的表达能力。
因此本文研究如何为图上的异常检测任务设计谱图滤波器。本文首先分析了lens of the graph spectrum (图信号经过图傅里叶变换后的谱域表示),即图信号在每个频率(特征值)上的响应强度。
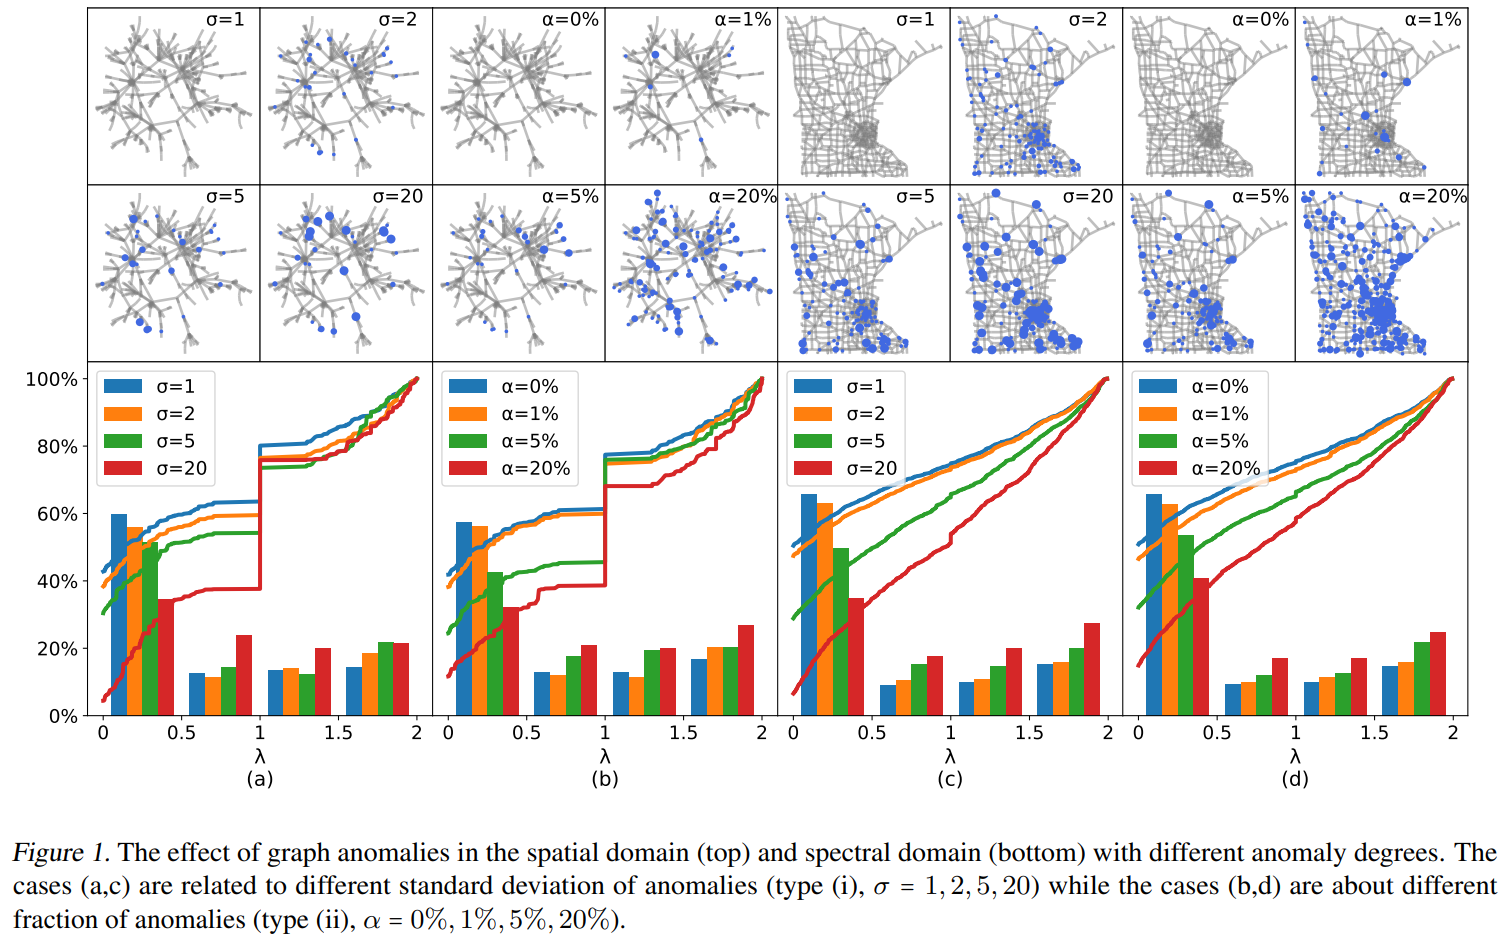
图1中(a)(c):异常节点数量不变,异常节点和正常节点的差别增加,导致图的异常程度增加。(b)(d):异常节点和正常节点的差别增加,异常节点的数量不变,导致图的异常程度增加。仅关注蓝色柱,表示图的异常程度很低,可以看出图信号在低频部分的energy高,而在高频部分的energy较低,即图信号在低频上的响应更多,在高频上的响应更少。随着异常程度的增加,关注红色柱,可以看出图上信号在低频上的响应降低,高频部分响应增加。可以看出异常数据会导致频谱能量的 “右移”。
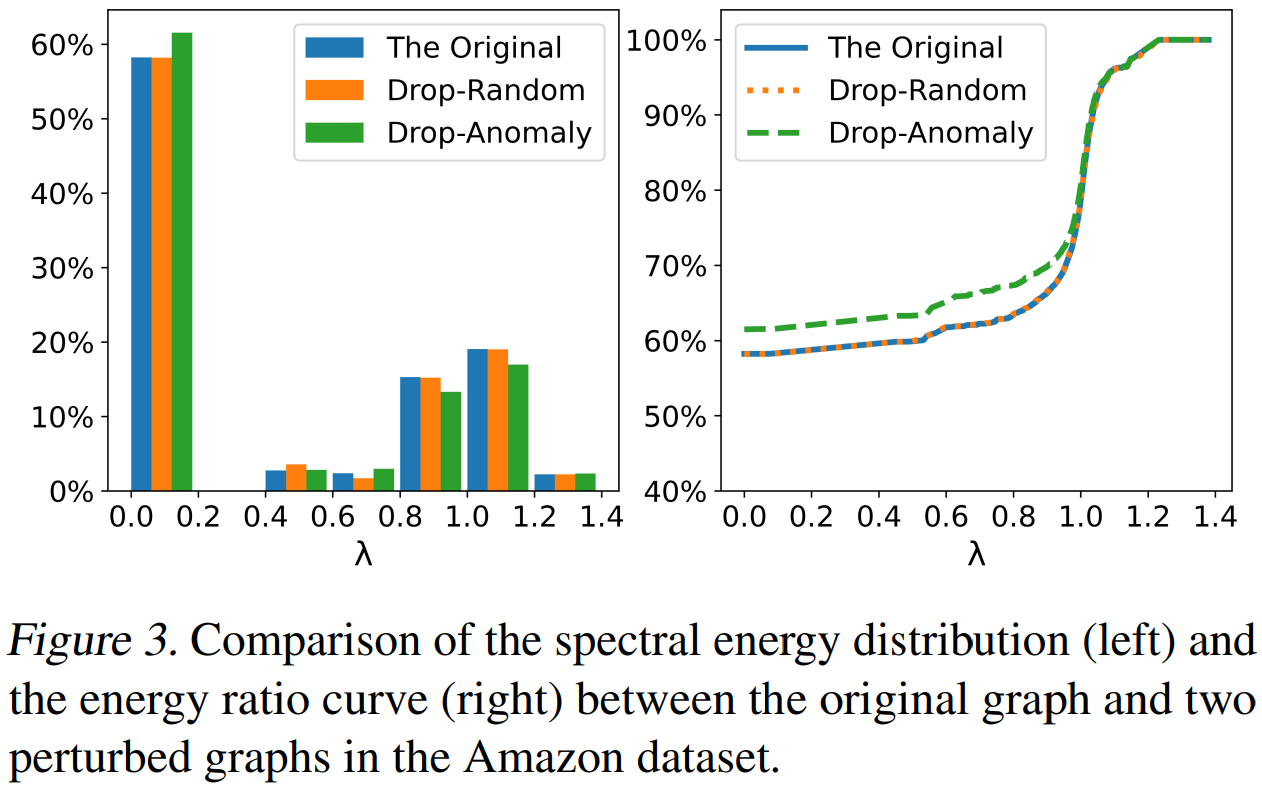
上图在一个fraud graph amazon上,对比原图,随机删除节点,删除异常节点 三种情况下在普通频率上的能量,可以看出,删除异常节点后低频能量上升,而高频能量($\lambda = 1.0\sim1.2$)下降。所以信号的高频部分可能carry异常节点的性质,考虑高频部分可以帮助模型区分出异常节点。而保留信号的低频部分可以使得正常节点间平滑。因此设计图上的band-pass filter对于fraud graph很重要。现有的图神经网络大多属于低通滤波器或者自适应滤波器,它们无法保证带通性质。其中自适应滤波器虽然具有拟合任意函数的能力,但在异常检测中同样可能退化为低通滤波器。这是因为在整个数据集中,异常数据对应的高频信息占比较小(类不平衡),而大部分频谱能量仍然集中在低频。
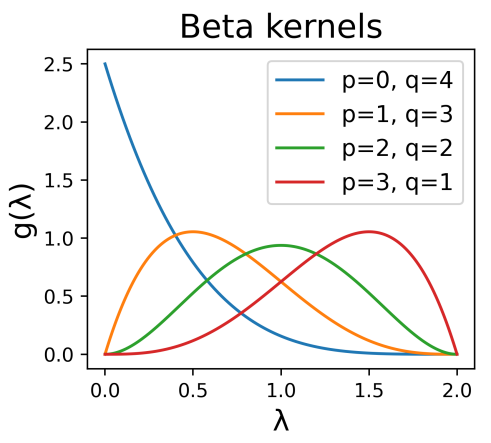
为了保留图上信号的从低频到高频的部分,本文选择使用Beta distribution作为graph kernel function $g(\Lambda)$。Beta distribution的概率密度函数为: $$ \beta_{p, q}(w)= \begin{cases}\frac{1}{B(p+1, q+1)} w^p(1-w)^q & \text { if } w \in[0,1] \\ 0 & \text { otherwise }\end{cases} $$ 其中$p, q \in \mathbb{R}^{+}$,$B(p+1, q+1)=p ! q ! /(p+q+1) !$是一个常数。由于normalized graph Laplacian $L$ 的特征值$\lambda \in[0,2]$,所以convolution kernel function(用来给不同频率basis加权的函数)定义为$\beta_{p, q}^*(w)=\frac{1}{2} \beta_{p, q}\left(\frac{w}{2}\right)$使得$\beta_{p, q}^*(\lambda)$可解。将$\beta_{p, q}^*(\Lambda)$ 其中$\Lambda$是$L$的特征值对角阵作为convolution kernel function: $$ \mathcal{W}_{p, q}=\boldsymbol{U} \beta_{p, q}^*(\boldsymbol{\Lambda}) \boldsymbol{U}^T=\beta_{p, q}^*(\boldsymbol{L})=\frac{\left(\frac{L}{2}\right)^p\left(I-\frac{L}{2}\right)^q}{2 B(p+1, q+1)} $$ 在不同的$p,q$设置下,$\mathcal{W}_{p, q}$可以倾向于不同的频率, 如下图所示,在$p=0,q=4$时,$\boldsymbol{U} \beta_{0, 4}^*(\boldsymbol{\Lambda}) \boldsymbol{U}^T$是一个low-pass filter,graph convolution kernel function $\beta_{p, q}^*(\boldsymbol{\Lambda})$为低频部分赋予更高权重。当$p=1, q=3$,以及$p=2, q=2$时,中频部分被赋予更高的权重,当$p=3,q=1$时,高频部分被赋予更高的权重。
将不同$p,q$取值的graph filter结合起来可以得到一个band pass graph filter,然后将不同filter下提取的信号分量做拼接: $$ \begin{aligned} \boldsymbol{Z}_i & =\mathcal{W}_{i, C-i}(\operatorname{MLP}(\boldsymbol{X})) \\ \boldsymbol{H} & =\operatorname{AGG}\left(\left[\boldsymbol{Z}_0, \boldsymbol{Z}_1, \cdots, \boldsymbol{Z}_C\right]\right) \end{aligned} $$
6. Pick and Choose: A GNN-based imbalanced learning approach for fraud detection (WWW ‘21)
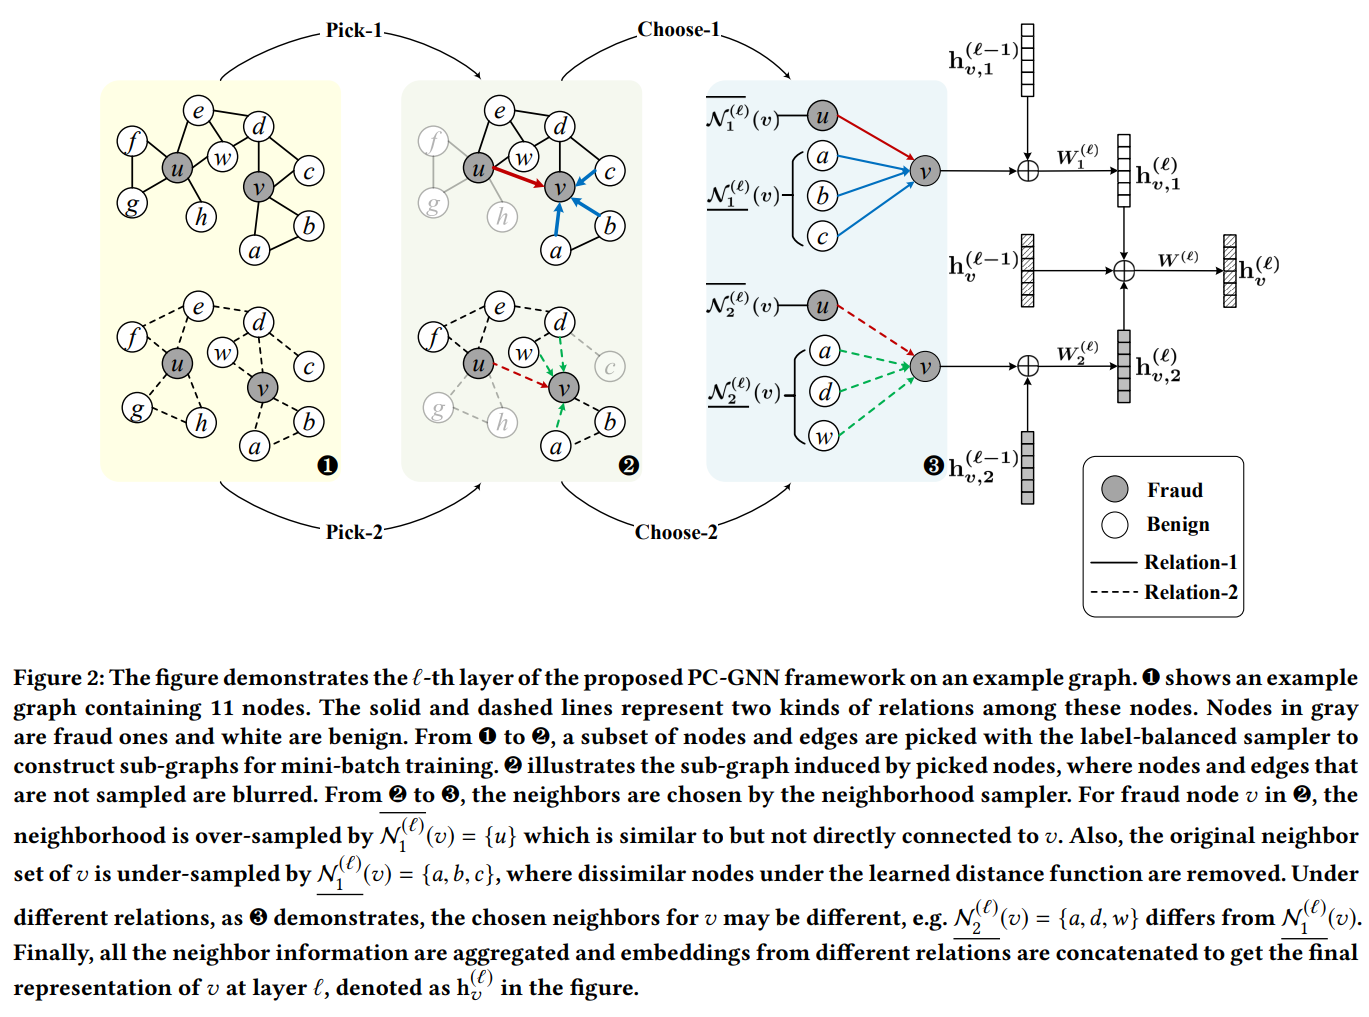
Pick: Label-balanced Sampler
该方法类似于CAER-GNN。CAER-GNN中每个batch抽取的节点为所有fraud training nodes和一半的benign training nodes,然后每个batch node聚合他们相似度高的一阶邻居。和CARE-GNN固定一个batch中不同类节点数量不同的是,PC-GNN为每个training node 设置采样概率,小类(fraud node)更容易被采样到,大类节点被采样的概率较小,每个训练集节点$v$被采样的概率为: $$ P(v) \propto \frac{||\hat{A}(:, v)||^2}{\operatorname{LF}(C(v))} $$ 其中$\operatorname{LF}(C(v))$为节点$v$所在类的训练节点数,小类的训练节点更容易被采样。分母为节点的度,表示越重要的节点越容易被采样到,这样一个batch中的训练节点可以避免原图中的类不平衡。
Choose: Neighborhood Sampler
第二步为图中的choose过程,为每个节点采样要聚合的邻居。对于每个batch node $v$,它的predicted label probabiity embedding 为 $\mathrm{D}_r^{(\ell)}\left(\mathbf{h}_{v, r}^{(\ell)}\right)=\sigma\left(\mathbf{U}_r^{(\ell)} \mathbf{h}_{v, r}^{(\ell)}\right)$,$v$和它的邻居$u$相似度定义为他们之间的embedding的$\ell_1$距离: $$ \mathcal{D}_r^{(\ell)}(v, u)=||\mathrm{D}_r^{(\ell)}\left(\mathbf{h}_{v, r}^{(\ell)}\right)-\mathrm{D}_r^{(\ell)}\left(\mathbf{h}_{u, r}^{(\ell)}\right)||_1 $$ 对于batch node中的benign node,采样与其label probability embedding相似度最相似的一定数量的邻居来聚合,benign node $v$的采样聚合邻居为: $$ \underline{\mathcal{N}_r^{(\ell)}}(v)=\{u \in \mathcal{V} \mid A_r(v, u)>0 \text { and } \mathcal{D}_r^{(\ell)}(v, u)<\rho_{-}\} $$ 对于batch中的fraud node,除了聚合上述一阶邻居外,还要将batch中其他和它相似度较高的fraud nodes加入它的邻居集合中: $$ \overline{\mathcal{N}_r^{(\ell)}}(v)=\{u \in \mathcal{V} \mid C(u)=C(v) \text { and } \mathcal{D}_r^{(\ell)}(v, u)<\rho_{+}\} $$ 所以对于fraud node $v$,他的聚合邻居集合为:$\mathcal{N}_r^{(\ell)}(v)=\underline{\mathcal{N}_r^{(\ell)}}(v) \cup \overline{\mathcal{N}_r^{(\ell)}}(v)$。计算节点何其邻居的距离是基于节点的label probability embeddings,基于cross-entropy loss来优化: $$ \begin{gathered} \mathcal{L}_{\text {dist }}=-\sum_{\ell=1}^L \sum_{r=1}^R \sum_{v \in \mathcal{V}}\left[y_v \log p_{v, r}^{(\ell)}+\left(1-y_v\right) \log \left(1-p_{v, r}^{(\ell)}\right)\right] \\ p_{v, r}^{(\ell)}=\mathrm{D}_r^{(\ell)}\left(\mathbf{h}_{v, r}^{(\ell)}\right) \end{gathered} $$
Aggregate: Message Passing Architecture
每个节点$v$ concat采样出的邻居: $$ \mathbf{h}_{v, r}^{(\ell)}=\operatorname{ReLU}\left(W_r^{(\ell)}\left(\mathbf{h}_{v, r}^{(\ell-1)} \oplus \mathrm{AGG}_r^{(\ell)}\left\{\mathbf{h}_{u, r}^{(\ell-1)}, u \in \mathcal{N}_r^{(\ell)}(v)\right\}\right)\right) $$ 每个relation各自计算node embedding,然后拼接MLP后得到节点的embedding: $$ \mathbf{h}_v^{(\ell)}=\operatorname{ReLU}\left(W^{(\ell)}\left(\mathbf{h}_v^{(\ell-1)} \oplus \mathbf{h}_{v, 1}^{(\ell)} \oplus \cdots \oplus \mathbf{h}_{v, R}^{(\ell)}\right)\right) $$ GNN的loss为最后一层的输出变换为logits,然后计算cross-entropy: $$ \begin{gathered} \mathcal{L}_{\mathrm{gnn}}=-\sum_{v \in \mathcal{V}}\left[y_v \log p_v+\left(1-y_v\right) \log \left(1-p_v\right)\right] \\ p_v=\operatorname{MLP}\left(\mathbf{h}_v^{(L)}\right) \end{gathered} $$ 模型的loss为: $$ \mathcal{L}=\mathcal{L}_{\mathrm{gnn}}+\alpha \mathcal{L}_{\mathrm{dist}} $$