Introduction
Subgraph Federated Learning旨在多个分布式的子图上训练一个图模型,并且子图之间没有数据共享。面临2个挑战:
Q1: 如何将各个子图上的模型融合成一个全局可用的模型,使其可以处理来自全局图的任何请求?
A1: 针对该挑战,本文提出FedSage将GraphSage和FedAvg结合。
Q2: 如何处理local subgraph之间缺失的边?
A2: 在FedSage的基础上添加一个邻居生成器。具体来说,为了得到missing neighbor generator,每个client首先通过随机移除一些节点和他们的边来损坏subgraph,然后基于损坏的图来和移除的节点来训练邻居生成器。邻居生成器不仅为子图中的每个节点生成missing neighbor number,也为每个节点生产missing neighbor features。然后用生成的节点邻居去修补subgraph,所谓模拟的跨子图交互。最后在修补好的子图上使用FedSage。
Collaborative Learning on Isolated Subgraphs:FedSage
对于一个被查询节点 $v\in V$,一个全局 $K$层GraphSage分类器 $F$通过融合 $v$和它的 $K$跳邻居来得到节点的预测值,其中每层的可学习参数为 $\phi = \{\phi^k\}^K_{k = 1}$,其中 $\phi^k$表示第 $k$层的权重矩阵。考虑一个子图 $G_i = \{V_i, E_i, X_i\}$, GraphSage通过一下式子计算节点 $v \in V_i$的第 $k \in [K]$层表示:
$$ h_v^k=\sigma\left(\phi^k \cdot\left(h_v^{k-1} || \operatorname{Agg}\left(\left\{h_u^{k-1}, \forall u \in \mathcal{N}_{G_i}(v)\right\}\right)\right)\right) $$
其中 $\mathcal{N}_{G_i}(v)$表示节点 $v$在子图 $G_i$中的邻居,上式表示邻居节点聚合后和中心节点拼接,然后再用参数 $\phi^k$做变换后得到中心节点的表示。
在FedSage中,全局模型 $F$的参数 $\phi$通过 $e_c$次训练迭代得到。在每次训练迭代 $t$中,每个client $D_i$首先拷贝全局参数 $\phi$到本地,作为本地模型的初始参数,再基于自身的数据更新参数 $\phi_i$:
$$ \phi_i \leftarrow\phi-\eta \nabla \ell\left(\phi \mid\left\{\left(G_i(v), y_v\right) \mid v \in V_i^t\right\}\right) $$
其中 $\eta$是学习率。然后中心服务器 $S$将所有 $M$个客户端上的最新参数 $\{\phi_i | i \in [M]\}$聚合并做平均,作为中心服务器上的模型参数。再下一次迭代时,将新的参数广播到所有客户端上进行新一轮的优化。
FedSage+
Missing Neighbor Generator (NeighGen)
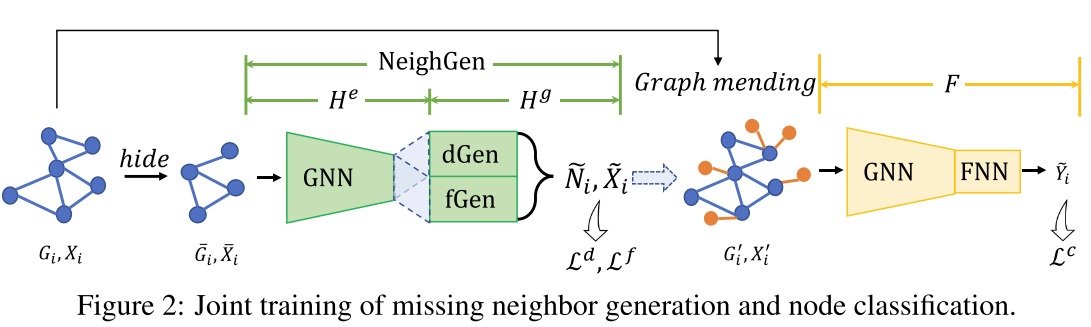
邻居生成器NeighGen由编码器 $H^e$和生成器 $H^g$组成:
编码器 $H^e$: 对于一个输入subgraph $G_i = (V_i, E_i, X_i)$,一个由 $\theta^e$参数化的GNN模型为子图中的每个节点学习embeddings $Z_i = \{z_v | v \in V_i\}$ 。
生成器 $H^g$: 基于node embedding生成它的missing neighbors。如图2所示, $H^g$包含两个模块dGen和fGen。其中dGen是一个由 $\theta^d$参数化的线性回归模型,用来预测给定节点的missing neighbors数量: $$ \tilde{n}_v=\sigma\left(MLP_{\theta^d} ( z_v)\right) \in \mathbb{R} $$
基于子图中的节点 $v$的embedding $z_v$生成它的预测missing neighbors数量 $\tilde{n}_v$。
fGen是一个由 $\theta^f$参数化的MLP用来基于节点 $v$的embedding $z_v$生成它的missing neighbor features。由于fGen为节点 $v$生成missing neighbor特征的个数取决于 $v$由多少个predicted missing neighbors,因此这里用变分的方式来基于 $z_v$生成它的missing neighbor features。具体来说,fGen有一个Gaussian noise生成器 $\mathbf{N}(0,1)$来生成随机噪声,以及一个随机采样器 $R$来从生成的邻居中采样 $\tilde{n}_v$个邻居特征:
$$ \widetilde{x}_v=R\left(\sigma\left(MLP_{\theta^f}\left(z_v+\mathbf{N}(0,1)\right)\right), \widetilde{n}_v\right) $$
通过这种方式,可以基于 $z_v$定义一个随机邻居生成器。
图修补仿真:假设一个client中只有一个特定集合的节点具有跨subgraph missing neighbors,因此可以通过图损坏(impairing)和修复(mending)过程来模拟missing neighbor的情况。具体来说,为了训练NeighGen,对于每个subgraph $G_i$,随机取出 $h%$的节点和与这些节点相关联的边作为simulated missing neighbors of $G_i$,由此可以得到一个损坏后的图 $\bar{G}_i=\left\{\bar{V}_i, \bar{E}_i, \bar{X}_i\right\}$。对于 $\bar{G}_i$中的每个节点 $v$,它的真实被移除的邻居数量为 $n_v$, 使用NeighGen预测它的missing neighbor数量表示为 $\tilde{n}_v$,NeighGen的优化目标是使得预测的missing neighbors数量和被移除的neighbors数量相似:
$$ \mathcal{L}^d = \frac{1}{|\bar{V}_i|} \sum_{v \in \bar{V}_i} L_1^S(\tilde{n}_v - n_v) $$
其中 $L_1^S (\cdot, \cdot)$是 L1 distance。对于特征,要求对于每个节点 $v \in \bar{V}_i$,它在 $G_i$中被移除的邻居表示为 $\mathcal{N}_{G_i}(v) \cap V_i^h$,其中 $\mathcal{N}_{G_i}(v)$表示 $v$在 $G_i$中的真实邻居集合, $V_i^h$表示impair后的邻居集合,因此 $\mathcal{N}_{G_i}(v) \cap V_i^h$共有 $n_v$个被移除邻居,对于节点 $v$的所有被移除邻居 $u \in \mathcal{N}_{G_i}(v) \cap V_i^h$, 要求真实被移除的邻居特征 $x_u$与为 $v$生成的邻居 $\widetilde{x}_v$之间的距离应该最小:
$$ \mathcal{L}^f = \frac{1}{\left|\bar{V}_i\right|} \sum_{v \in \bar{V}_i} \sum_{p \in\left[\widetilde{n}_v\right]} \min _{u \in \mathcal{N}_{G_i}(v) \cap V_i^h}\left(\left|\left|\widetilde{x}_v^p-x_u\right|\right|_2^2\right) $$
其中 $\widetilde{x}_v^p$表示NeighGen为节点 $v$生成的第 $p$个missing neighbor。
为了使模型生成的邻居特征可以模拟跨subgraph的特性,因此将特征loss $\mathcal{L}^f$改写为如下形式:
$$ \mathcal{L}_i^f=\frac{1}{\left|\bar{V}_i\right|} \sum_{v \in \bar{V}_i} \sum_{p \in\left[\tilde{n}_v\right]}\left(\min_{u \in \mathcal{N}_{G_i}(v) \cap V_i^h}\left(\left|\left|\widetilde{x}_v^p-x_u\right|\right|_2^2\right)+\alpha \sum_{j \in[M] / i} \min_{u \in V_j}\left(\left|\left|H_i^g\left(z_v\right)^p-x_u\right|\right|_2^2\right)\right) $$
其中后面一项 $\min _{u \in V_j}\left(\left|\left|H_i^g\left(z_v\right)^p-x_u\right|\right|_2^2\right)$中的 $x_u$表示另一个子图 $G_j$中的节点特征 $H_i^g\left(z_v\right)^p$表示NeighGen为 $G_i$中的节点 $v$生成的missing neighbor feature。因此这一项表示生成的新邻居要和其他子图中与它最相似的邻居尽可能一致,也就是生成的邻居要尽可能接近其他子图中的节点特征。
但是这存在另一个问题, $x_u$在 $G_j$中,不符合FL的设定。为了解决该问题,这里将 $z_v$ send到client $D_j$中来计算 $\min _{u \in V_j}\left(\left|\left|H_i^g\left(z_v\right)^p-x_u\right|\right|_2^2\right)$,并计算生成器的梯度,然后将梯度send back到 $D_i$。因为编码器 $H_i^e$在 $D_i$上是local的,所以 $D_j$无法通过 $z_v$恢复出 $v$的原始特征。
注意:从上面的 $\mathcal{L}^f$的式子第二项可以看出,由 $z_v$生成的邻居embedding $H_i^g\left(z_v\right)$要和所有其他子图中的所有节点的相似度尽可能高。也就是认为 $v$的missing neighbors需要来自于其他所有subgraphs。