论文地址:GAT
Introduction
本文介绍了一种新型的神经网络架构用来处理图结构。即__Graph Attention Networks__(GATs)。该方法利用masked self-attentional layer,即通过网络层的堆叠,可以获取网络中每个节点的领域特征,同时为领域中的不同节点指定不同的权重。这样做的好处是可以不需要各种高成本的矩阵运算也不依赖于的图结构信息。通过这种方式,GAT可以解决基于谱的图神经网络存在的问题,同时,GAT可以使用用归纳(inductive)和直推(transductive)问题。
归纳学习:先从训练样本中学习到一定的模式,然后利用其对测试样本进行预测(即首先从特殊到一般,然后再从一般到特殊),这类模型如常见的贝叶斯模型。
直推学习:先观察特定的训练样本,然后对特定的测试样本做出预测(从特殊到特殊),这类模型如k近邻、SVM等。
Architecture
图$G$中有$N$个节点,他们的特征向量为:$\textbf{h}={\vec{h_1},\vec{h_2},…,\vec{h_N}}$,其中,$\vec{h_i} \in \mathbb{R}^F$,$F$是每个节点特征数。我们的目的是输出一个新的节点特征向量集$\textbf{h’}={\vec{h_1’},\vec{h_2’},…,\vec{h_N’}}$,其中$\vec{h_i’} \in \mathbb{R}^{F’}$。 本质就是修改特征向量的维度(Network embedding)
为了获得足够的表达能力以将输入特征变换为更高级别的特征,需要至少一个可学习的线性变换。因此,以任意节点$i$和$j$为例,分别对节点$i$和节点$j$的特征向量做线性变换$W \in \mathbb{R}^{F \times F’}$,这样 就将$\vec{h_i}$和$\vec{h_j}$从$F$维的向量转化为$F’$维的向量: $$ e_{ij} = a(W\vec{h_i},W\vec{h_j}) $$ 上式中,分别对$\vec{h_i}$和$\vec{h_j}$做线性变换,然后使用self-attention为图中的每一个节点分配注意力(权重)。上式中,注意力机制$a$是一个$\mathbb{R}^{F’} \times \mathbb{R}^{F’} \to \mathbb{R}$的映射。最终得到的$e_{ij}$是节点$j$对节点$i$的影响力系数(一个实数)。
但是,上面的方法考虑其他节点对$i$的影响时,将图中的所有节点都纳入了考虑范围,这样就丢失了图的结构信息。因此,本文引入masked attention机制,即计算影响力系数$e_{ij}$时, 仅考虑节点$i$的一部分邻居节点 $j \in \mathcal{N}_i$($i$也属于$\mathcal{N}_i$)。使用softmax将节点$i$部分邻居的注意力系数分配到(0,1)上: $$ \alpha_{ij} = \mathrm{softmax}_j(e_{ij}) = \frac{\exp(e_{ij})}{\sum_{k \in \mathcal{N}_i}\exp(e_{ik})} $$ 在本文中,$a$是一个单层前馈神经网络,参数是一个权重向量$\vec{\text{a}} \in \mathbb{R}^{2F’}$,然后使用负半轴斜率为0.2的LeakyReLU作为非线性激活函数: $$ \alpha_{ij} = \frac{\exp(\mathrm{LeakyReLU}(\vec{\text{a}}^T[W\vec{h_i}||W\vec{h_j}]))}{\sum_{k\in \mathcal{N}_i} \exp(\mathrm{LeakyReLU}(\vec{\text{a}}^T[W\vec{h_i}||W\vec{h_k}]))} $$ 其中$||$表示向量的连接操作。上述过程可以用下图表示:
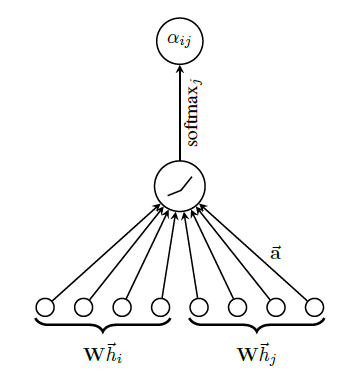
这样,我们就可以获得节点$j$对节点$i$的注意力系数$\alpha_{ij}$,那么,节点$i$最终的输出特征$\vec{h_i’}$就是对$\mathcal{N}_i$中所有节点的加权(加注意力)求和: $$ \vec{h_i’} = \sigma (\sum_{j \in \mathcal{N}_i}\alpha_{ij} W\vec{h_j}) $$
另外,本文使用multi-head attention来稳定self-attention的学习过程,如下图所示:
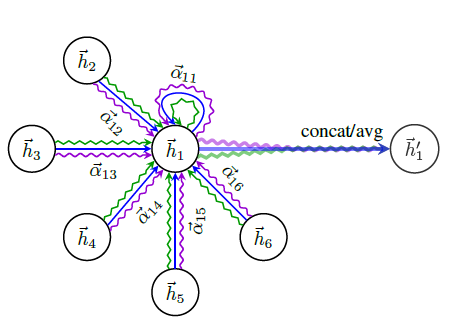
图中是$K=3$ heads的multi-head attention,不同颜色的箭头表示一个独立的attention计算,每个邻居节点做三次attention计算。每次attention计算就是一个普通的self-attention,输出的结果是一个$\vec{h_i’}$。multi-head attention为每个节点$i$输出3个不同的$\vec{h_i’}$,,然后将这三个向量做连接或者取平均,得到最终的$\vec{h_i’}$: $$ \vec{h_i’} = ||^K_{k=1} \sigma\left(\sum_{j \in \mathcal{N}_{i}} \alpha_{i j}^{k} \mathbf{W}^{k} \vec{h}_{j}\right) $$ 上式为把不同$k$的向量做连接操作,其中$\alpha_{ij}^k$和$\mathbf{W}^{k}$表示第$k$个head的结果,我们可以注意到,最终输出的结果是$KF’$维的。除了concat之外,我们还可以通过求平均的方式来获得$\vec{h_i’}$: $$ \vec{h^\prime_i}=\sigma\left(\frac{1}{K} \sum_{k=1}^{K} \sum_{j \in \mathcal{N}_{i}} \alpha_{i j}^{k} \mathbf{W}^{k} \vec{h}_{j}\right) $$
Comparisions
GAT是计算高效的。self-attention是在所有边上并行计算,并且输出的特征在所有边上并行计算,从而不需要昂贵的矩阵计算和特征分解。单个head的GAT的时间复杂度为$O\left(|V| F F^{\prime}+|E| F^{\prime}\right)$,其中$F$是输入的特征数,$|V|$和$|E|$分别是节点数和边数。复杂度与GCN相同。
与GCN不同的是,GAT为同一邻域中的节点分配不同的重要性(different importance),提升了模型容量。
注意机制以共享的方式应用于图中的所有边(共享$\mathbf{W}$),因此它不依赖于对全局图结构的预先访问或其所有节点的(特征)。这样有以下提升:
- 不必是无向图。如果$i \to j$不存在,可以直接不用计算$\alpha_{ij}$。
- 可直接应用于归纳学习。
GAT可以被描述为一种特殊的MoNet(Geometric deep learning on graphs and manifolds using mixture model cnns)。
Reference
参考:
GCN:https://arxiv.org/abs/1609.02907
https://zhuanlan.zhihu.com/p/34232818