本文的目的是在预训练图上训练一组通用的图词汇表(vocabulary)作为图上可迁移的通用pattern,这些词汇表可应用于跨领域的多任务中。
GNN的可迁移性
可迁移性指的是模型从source task中提取模式,这些模式的知识可以增强对目标任务的预测。近期的工作通过识别与各种任务相关的关键子结构,来研究图上可迁移的词汇表。例如,三元闭包(triadic closure),同质性,异质性对于节点分类至关重要;一些motif,比如三角形,k-cliques,和star,是图分类的基本组成成分,这些子结构可以作为通用可迁移的pattern,基于这些子结构在不同图中的形式,或者研究图具有怎样的子结构组成,可以推断图在各种任务上的表现。
拿自然语言来类比,positive sub-vocabulary 可以是 [happy, nice, great, … ];negative sub-vocabulary 可以是[upset, bad, worse, … ],对于一个句子,只需要用它来检索这个词汇表,就可以对这个句子是积极或者消极做出分类。
对于Graph也是一样,构建一些通用的子结构,下游graph去检索这些子结构,基于子结构的性质来对图的性质做出推理。
计算树(computation tree)作为可迁移的graph pattern
Computation Tree:对于一个图 $\mathcal{G}(\mathcal{V}, \mathcal{E})$,关于节点 $v$,它的 $L$ 层计算树为 $\mathcal{T}_v^L$,且 $\mathcal{T}_v^1 = v$。这个tree通过递归融合邻居的子树得到。对于图 $\mathcal{G}$,它的 $L$层子树的集合可以表示为一个multiset: $\mathcal{T}_{\mathcal{G}}^L:=\left\{\mathcal{T}_v^L\right\}_{v \in \mathcal{V}}$ 。
为什么计算树比其他子结构(如motif)更适合做通用的vocabulary?
首先,节点级、边级、图级任务都可以表示为计算树的分类任务。如下图所示:
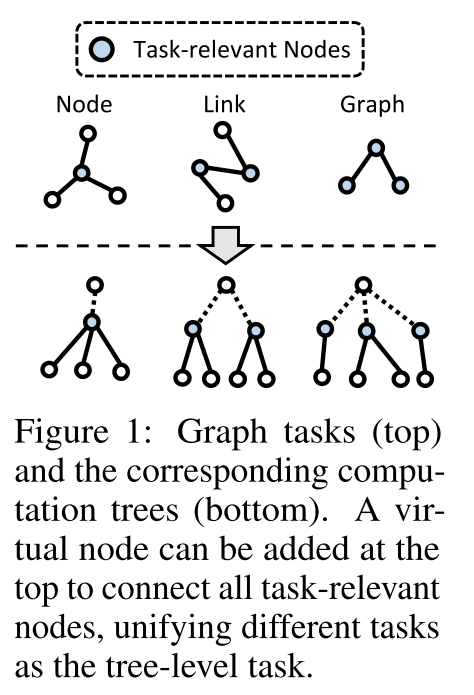
计算树可以捕获图中重要的局部子树模式。如果两个节点的 $L$层计算树相似(同时考虑节点和特征),那么表明这两个节点共享相似的邻域信息,则这两个节点具有类似现象(analogous phenomena)。
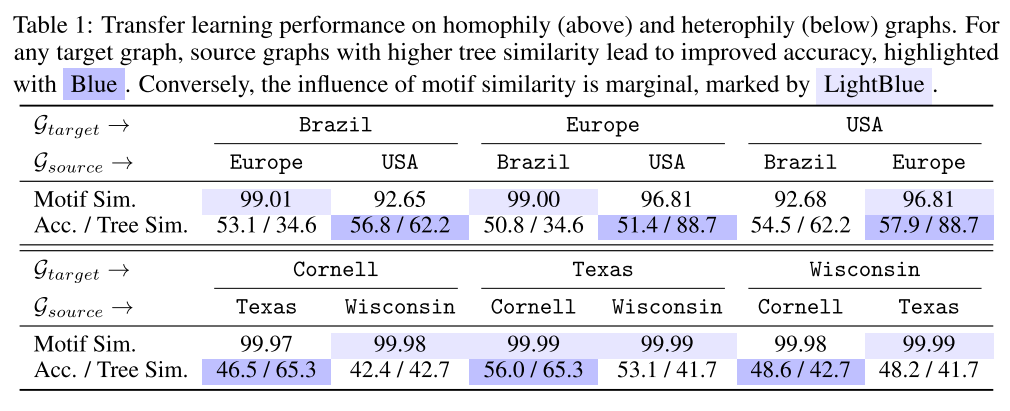
两个具有相似计算树的图,是否以为这模型在这两个图上的迁移性更好?(Yes)
两个图具有相似的其他子结构(如motif),并不一定意味着两个图之间模型的迁移性更好
Theorem 2.2:
$$ \Delta \triangleq\left|\left|\phi\left(\mathcal{T}_{v_1}\right)-\phi\left(\mathcal{T}_{v_2}\right)\right|\right|_2 \leq \mathcal{C}_1 \left| \left| \mathbf{x}_{v_1}-\mathbf{x}_{v_2}\right|\right|_2+\mathcal{C}_2 \sum_{j \in \mathcal{N}(v)} \Delta_{v_1, v_2, j}^{L-1} \leq 2 \mathcal{B}_{\mathbf{x}}\left(\mathcal{C}_1+\sum_{l=1}^L \mathcal{C}_2^l D_l\right) $$
上面定理表示,一个GNN模型 $\phi$对两个计算树计算embedding的相似度,一定会被两个计算树的子树相似度bound,也就是说,如果两个计算树相似,那么GNN一定可以为他们计算相似的embedding,从而做出相似度预测,所以GNN在这两个子树上具有较好的可迁移性。如下图所示,motif的相似度并不意味着更高的准确率,99.01的motif相似度,实际上的准确率很低,但计算树的相似度可以反映相似度,所以可以作为图上可迁移的vocabulary,下游图可以检索vocabulary计算树来推测性质。
Pre-training with Computation Tree Reconstruction
GFT采用Vector Quantization (VQ, 参考VQ-VAE)来开发计算树词汇表。对于一个图数据库 $\mathcal{D} = \{\mathcal{G}_i\}^n_{i = 1}$,从中提取一个集合的计算树 $\mathcal{T}=\left\{\mathcal{T}_i\right\}_{i=1}^m$。通过GNN $\phi$可以得到 $m$个computation tree的embedding: $\mathcal{Z}=\left\{\mathbf{z}_i\right\}_{i=1}^m$。然后定义一组codebooks为可学习的tokens $\mathbf{C}=\left\{\mathbf{c}_1, \ldots, \mathbf{c}_K\right\}$,那么tree embedding space被量化为将每个tree embedding分配给最近的codebook token(类似于k-means,但没有明确的k)。那么对于tree embedding $\mathbf{z}_i$,它所属的codebook token 为 $\mathbf{q}_i=\mathbf{c}_j$,其中 $j=\arg \min _j\left|\left|\mathbf{z}_i-\mathbf{c}_j\right|\right|_2 .$ 那么对于 $m$个数,可以将他们分配給 $K$个codebook tokens 作为长度为 $K$的词汇表。通过vocabulary loss和commitment loss来优化tree embedding和codebook tokens,可以得到预训练目标函数:
$$ \mathcal{L}_{\text {pretrain }}=\mathcal{L}_{\text {tree }}+\underbrace{\frac{1}{m} \sum_{i=1}^m\left|\left|\operatorname{sg}\left[\mathbf{z}_i\right]-\mathbf{c}_i\right|\right|_2^2}_{\text {vocabulary loss }}+\beta_1 \cdot \underbrace{\frac{1}{m} \sum_{i=1}^m\left|\left|\mathbf{z}_i-\operatorname{sg}\left[\mathbf{c}_i\right]\right|\right|_2^2}_{\text {commitment loss }} $$
先看后面两项,目的是可微地将 $m$个tree embedding压缩为 $K$个向量, $\mathrm{sg}[\mathbf{z}_i]$是stop-gradient的意思,即前向传播得到 $\mathbf{z}_i$后,block $\mathbf{z}_i$回传的梯度,也就是把 $\mathrm{sg}[\mathbf{z}_i]$视为constant来优化 $\mathbf{c}_j$。commitment loss同理。
Computation Tree Reconstruction. 除了vocabulary loss和commitment loss联合训练codebooks和tree embedding外,本文还引入了一个树重建任务使得学习到的词汇表可以深入理解计算树的结构和语义属性。
- 对于每个计算树 $\mathcal{T}_i$所属的token $\mathbf{q}_i \in \mathbf{C}$,它应当具备重构计算树root node 特征 $\mathbf{x}_i$的能力(codebook token要充分学习它包含的计算树的结构和属性信息):
$$ \mathcal{L}_{\text {feat }}=\frac{1}{m} \sum_{i=1}^m\left|\left|\hat{\mathbf{q}_i^2}-\mathbf{x}_i\right|\right|_2^2 $$
- 计算树token $\mathbf{q}_i$ 要能够重构树 $\mathcal{T}_i$的总体语义信息 $\mathbf{z}_i$:
$$ \mathcal{L}_{s e m}=\frac{1}{m} \sum_{i=1}^m\left(1-\frac{\hat{\mathbf{q}}_i^{1^T} \hat{\mathbf{z}_i}}{\left|\left|\hat{\mathbf{q}_i^1}\right|\right|\left|\left|\hat{\mathbf{z}}_i\right|\right|}\right)^\gamma $$
- 对于有边连接的节点,他们的两个计算树 $\mathcal{T}_i$ 和 $\mathcal{T}_j$所属的codebook token $\mathbf{q}_i$和 $\mathbf{q}_j$要相似:
$$ \mathcal{L}_{\text {topo }}=\sum_{(i, j) \in \mathcal{E},\left(i, j^{\prime}\right) \in \hat{\mathcal{E}}}-\frac{1}{|\mathcal{E}|} \log \left(\sigma\left(\hat{\mathbf{q}}_i^{\mathbf{3}^T} \hat{\mathbf{q}}_j^3\right)\right)-\frac{1}{|\hat{\mathcal{E}}|} \log \left(1-\sigma\left(\hat{\mathbf{q}}_i^{\mathbf{3}^T} \hat{\mathbf{q}}_{j^{\prime}}^3\right)\right)+\frac{1}{|\mathcal{E}|}\left|\left|\left[\mathbf{q}_i^4 || \mathbf{q}_j^4\right]-\mathbf{e}_{i j}\right|\right|_2^2 $$
所以预训练loss $\mathcal{L}_{\text {pretrain }}$中的 $\mathcal{L}_{\text {tree }}$定义为如下形式:
$$ \mathcal{L}_{\text {tree }}=\beta_2 \cdot \mathcal{L}_{\text {feat }}+\beta_3 \cdot \mathcal{L}_{\text {sem }}+\beta_4 \cdot \mathcal{L}_{\text {topo }} $$
为了增强tree vocabulary的质量,不同的词汇应具备一定的区分性,所以regularize the tree vocabulary space by intentionally increasing the distance between distinct tokens:
$$ \mathcal{L}_{\text {ortho }}=\lambda \frac{1}{K^2}\left|\left|\mathbf{C C}^T-\mathbf{I}_K\right|\right|_F^2, \quad \mathbf{C}=\left[\mathbf{c}_1, \ldots, \mathbf{c}_K\right]^T \in \mathbb{R}^{K \times d^{\prime}} $$
Fine-tuning with Computation Tree Classification
预训练阶段将通用知识编码到Tree vocabulary中,Fine-tuning阶段将这些知识应用于特定的预测任务。首先将节点级、边级、图级任务全部统一成tree-level task。
- 节点分类:任务特定的树表示为 $\mathcal{T}_{node} =\mathcal{T}_i$,embedding为 $\mathbf{z}=\phi\left(\mathcal{T}_i\right)$。
- 链接预测:任务特定的树表示为 $\mathcal{T}_{\text {link }}=\operatorname{Combine}\left(\mathcal{T}_s, \mathcal{T}_t\right)$, embedding为 $\mathbf{z}=\operatorname{mean}\left(\phi\left(\mathcal{T}_s\right), \phi\left(\mathcal{T}_t\right)\right)$。
- 图级分类:任务特定的树表示为 $\mathbf{z}=\operatorname{mean}\left(\phi\left(\mathcal{T}_s\right), \phi\left(\mathcal{T}_t\right)\right)$。
然后,任务特定的计算树通过查询tree vocabulary来做出预测,从而将词汇表中的通用知识用于各种任务和领域。
Prototype Classifier. 给定一组任务特定的计算树 $\left\{\left(\mathcal{T}_i, y_i\right)\right\}_{i=1}^n$包含 $|C|$个类别,需要预测这个计算树的类别。对于一个预训练好的GNN $\phi$,可以为这些计算树生成embeddings $\mathcal{Z}=\left\{\mathbf{z}_i\right\}_{i=1}^n$。这些embedding用于查询tree vocabulary 然后可以得到每个计算树所属的codebook token $\mathcal{Q}=\left\{\mathbf{q}_i\right\}_{i=1}^n$。然后,对于每个类别有一定数量的计算树用于训练,对于训练计算树,构造一个memory bank $\mathbb{S}=\left\{\mathbb{S}^1, \ldots, \mathbb{S}^{|C|}\right\}$用来保存构构成每个类别的codebook token,其中 $\mathbb{S}^k = \{\mathbf{q}_i \in \mathcal{Q} | y_i = k\}$,表示那些用于构成类别 $k$的codebook tokens。那么,class prototype就是用于表示这些类的tokens的结合: $$ \mathbf{p}_k=\frac{1}{ \left|\mathbb{S}^k\right|} \sum_{\mathbf{q}_i \in \mathbb{S}^k} \mathbf{q}_i $$
这些类prototype可以用于对测试计算树的预测。若测试计算树的GNN embedding为 $\mathbf{z}$,那么它的第 $k$个类别的预测结果如下:
$$ p(y=k \mid \mathbf{z})=\frac{\exp \left(-\operatorname{sim}\left(\mathbf{z}, \mathbf{p}_k\right) / \tau\right)}{\sum_c \exp \left(-\operatorname{sim}\left(\mathbf{z}, \mathbf{p}_c\right) / \tau\right)} $$
通过上面的概率在下游图的训练集上fine-tuning模型。为什么要fine tuning,因为对于不同的图,同一个计算树可能的作用也是不一样的,所以要通过这种方式来让计算树的embedding变得task specific,使得每个类别有最适合它的计算树。