目的:在一个图上训练好的GNN,在未知的testing graph上的结果由于training和test数据分布的不同,可能存在很大的不确定性。通常来说,in-service的GNN在已知graph with labels的图上训练好后,需要部署在label未知的testing graph上,但是由于label未知,无法估计GNN在testing graph上的效果。
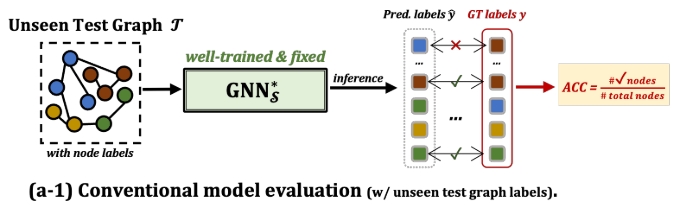
如上图所示,对于一个已经在训练图 $\mathcal{S}=(\mathbf{X}, \mathbf{A}, \mathbf{Y})$上well-trained & fixed GNN model $\mathrm{GNN}_{\mathcal{S}}^\star$,并且将它deploy in service。对于一个不知道label的测试图 $\mathcal{T}$,由于不知道label,如何评估GNN在该测试图上的性能是一个挑战。由于可见的训练graph和不可见的test graph的分布差异可能很大,因此GNN评估器GNNEvaluator需要充分学习多样化的图结构with diverse node context and graph structure distributions,从而可以评估不同数据分布的测试图潜在的效果。
假设:Covariate shift between the training graph $\mathcal{S}$ and the label-unlabeled graph $\mathcal{T}$ with respect to the label space。 即无论输入图是什么样的,输出的label space相同。
如何生成数量足够的graph set来训练GNNEvaluator $f_\theta$?
Solution:采样一个seed subgraph $\mathcal{S}_{seed}$ from the observed training graph $\mathcal{S}$。采样原则是seed graph 要和 training graph之间满足相同的label space,所以原图中采样可以使采样图$\mathcal{S}_{seed}$的分布尽可能少的偏离原图,从而满足Covariate shift。如下图左边所示。
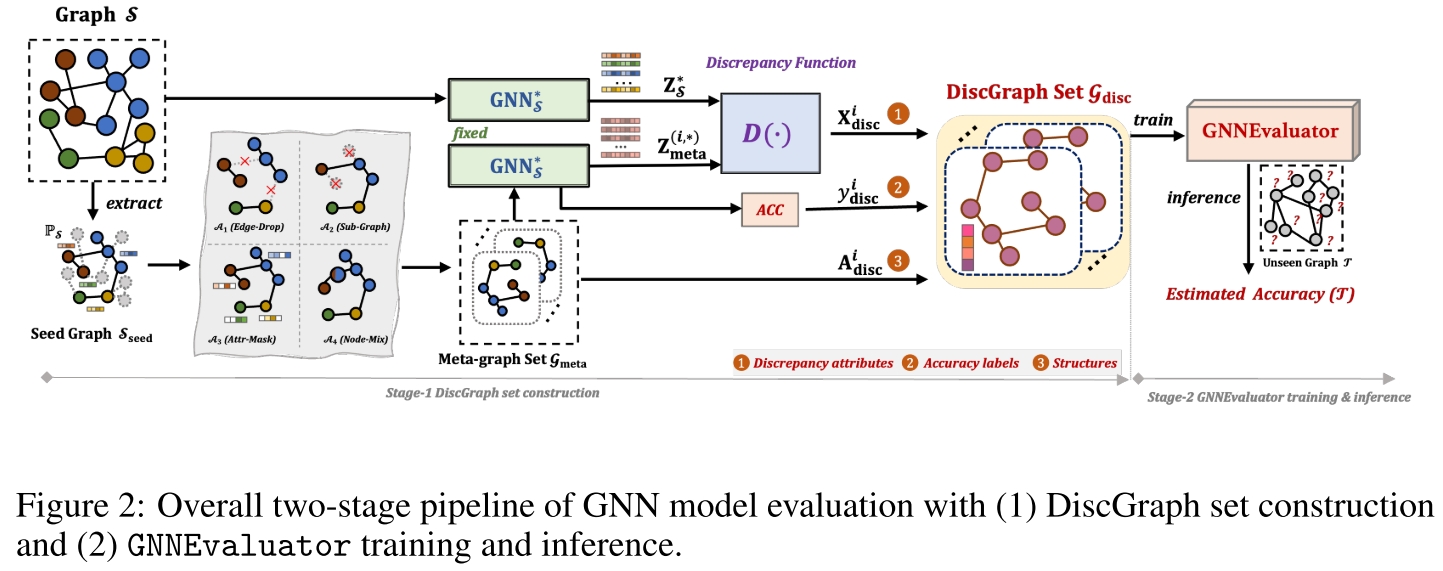
在得到采样seed graph $\mathcal{S}_{seed}$后,对 $\mathcal{S}_{seed}$做 $K$次增强,其中涉及的增强包括 $\texttt{EdgeDrop}$, $\texttt{NodeDrop(Subgraph)}$, $\texttt{AttrMask}$和 $\texttt{NodeMix}$。选择哪种增强有特定的概率 $\epsilon$。基于seed graph $\mathcal{S}_{seed}$,可以得到一个 meta-graph集合 $\mathcal{G}_{\text{meta}}=\left\{g_{\text {meta }}^i\right\}_{i=1}^K$,其中的每个meta-graph都是由seed graph 扰动而来,和原图具有相同的label space。每个meta-graph $g_{\text {meta }}^i=\left\{\mathbf{X}_{\text {meta }}^i, \mathbf{A}_{\text {meta }}^i, \mathbf{Y}_{\text {meta }}^i\right\}$,分别表示meta-graph的节点特征,结构和标签。通过这种方式可以为原图生成label space相同,但结构/特征都不相同图,拓展了差异性,基于这些图学习到的GNNEvaluator可以评估不同分布图的效果。
如何学习well-trained GNN在不同分布图上的差异?
给定一个在 training graph $\mathcal{S}$上 well-trained的GNN模型 $\mathbf{Z}_{\mathcal{S}}^\star=\operatorname{GNN}_{\mathcal{S}}^\star(\mathbf{X}, \mathbf{A})$, $\mathbf{Z}_{\mathcal{S}}^\star$是学习到的原图embeddings。将这个well-trained GNN $\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$直接应用在每个meta graph $g_{\text {meta }}^i$上:
$$ \mathbf{Z}_{\text {meta }}^{(i, \star)}, \hat{\mathbf{Y}}_{\text {meta }}^{(i, \star)}=\operatorname{GNN}_{\mathcal{S}}^\star\left(\mathbf{X}_{\text {meta }}^i, \mathbf{A}_{\text {meta }}^i\right)$$
可以得到$\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$为meta graph $g_{\text{meta}}^i$学习到的节点embedding和预测值,可以用来评估在$\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$该分布的图上的效果。若 $g_{\text {meta }}^i$中有 $M_i$个节点,那么 $\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$对该图的准确率为: $$ y_{\mathrm{disc}}^i=\operatorname{Acc}\left(g_{\text {meta }}^i\right)=\frac{\sum_{j=1}^{M_i}\left(\hat{y}_{\operatorname{meta}(i, *)}^j==y_{\operatorname{meta}(i)}^j\right)}{M_i}, $$ 表示 $\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$为该图中节点预测的平均准确率。
那么对于meta graph集合 $\mathcal{G}_{\text {meta }}=\left\{g_{\text {meta }}^i\right\}_{i=1}^K$中的所有图,由于这些图来组training graph,有明确的节点标签信息,因此$\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$可以计算在每个meta graph上的准确率。由于不同的meta graph的数据分布不同,所以我们可以得到 $\operatorname{GNN}_{\mathcal{S}}^*(\cdot, \cdot)$对不同数据分布图的适用性。
此外,在well-trained模型下,meta graph $g_{meta}^i$的表示 $\mathbf{Z}_{\text {meta }}^{(i, \star)}$和训练图表示 $\mathbf{Z}_{\mathcal{S}}^\star$之间差异用下式衡量: $$ \mathbf{X}_{\mathrm{disc}}^i=D\left(\mathbf{Z}_{\text {meta }}^{(i, \star)}, \mathbf{Z}_{\mathcal{S}}^\star\right)=\frac{\mathbf{Z}_{\text {meta }}^{(i, \star)} \mathbf{Z}_{\mathcal{S}}^{\star \mathrm{~T}}}{\left|\left|\mathbf{Z}_{\text {meta }}^{(i, \star)}\right|\right|_2 \cdot\left|\left|\mathbf{Z}_{\mathcal{S}}^\star\right|\right|_2} $$
GNNEvaluator如何估计无标签图的准确率?
训练GNNEvaluator: $$ \min_\phi \sum_{i=1}^K \mathcal{L}_{\mathrm{reg}}\left(f_{\boldsymbol{\phi}}\left(\mathbf{X}_{\mathrm{disc}}^i, \mathbf{A}_{\mathrm{disc}}^i\right), y_{\mathrm{disc}}^i\right) $$ 对于每个meta graph $g_{\text {meta }}^i=\left\{\mathbf{X}_{\text {meta }}^i, \mathbf{A}_{\text {meta }}^i, \mathbf{Y}_{\text {meta }}^i\right\}$,基于结构 $\mathbf{A}_{\text {meta }}^i$和差异属性 $\mathbf{X}_{\text {meta }}^i$使用逻辑回归来预测准确率 $y_{\mathrm{disc}}^i$。损失函数采用MSE回归损失。
测试阶段,对于一个label不可见的预测图 $\mathcal{T} = (\mathbf{X}^\prime, \mathbf{A}^\prime)$,将其带入 $\operatorname{GNN}_{\mathcal{S}}^\star(\cdot, \cdot)$得到它的表示 $\mathbf{Z}_{\mathcal{T}}^\star$,并与 $\mathbf{Z}_{\mathcal{S}}^\star$一同计算得到差异节点特征$\mathbf{X}_{\text {disc }}^{\mathcal{T}}$。再将$\mathbf{X}_{\text {disc }}^{\mathcal{T}}$和 $\mathbf{A}^\prime$带入 $f_\phi (\cdot,\cdot)$中,得到估计准确率 $\operatorname{Acc}(\mathcal{T})=\hat{y}_{\text {dist }}^{\mathcal{T}}$。该过程无需任何测试集标签参与评估。
图的差异与图的准确率匹配,所以可以用图差异来衡量与真实准确率的差异。