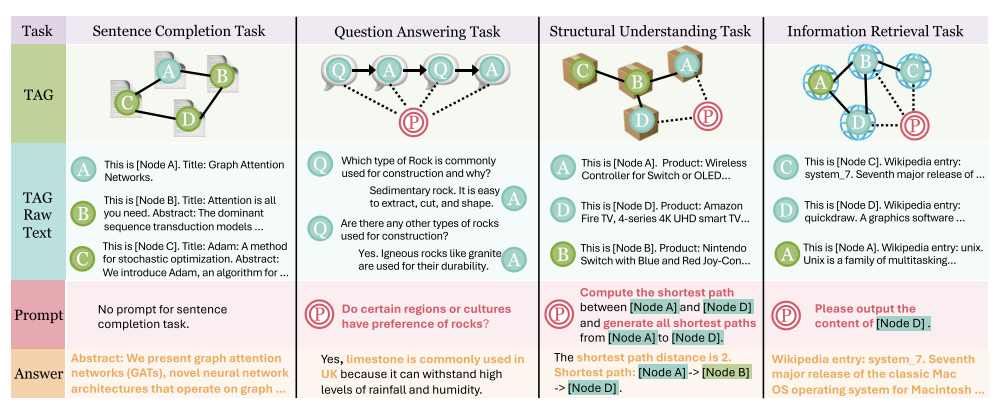
GOFA是OFA(ICLR 2024)的后续工作,用来解决OFA中存在的一些问题。
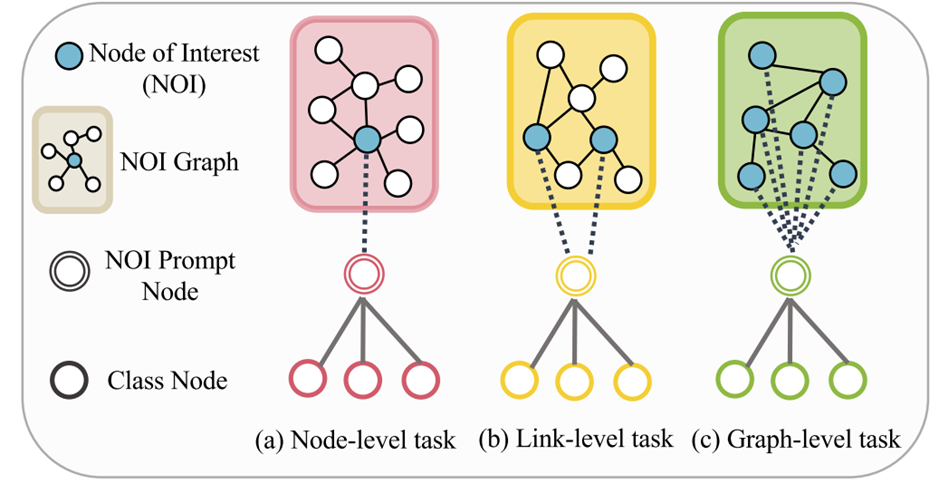
OFA用NOI Prompt Node来统一不同的分类任务,也就是用不同的NOI Prompt Node来表示不同的分类任务,然后用任务的文本描述作为这些表示任务的节点的文本特征,LLM 编码来数值化这个节点的初始特征,任务对应的label也用节点(Class Node)来表示,然后用每个class的文本描述作为这个Class Node的特征。GNN的训练目标就是训练NOI Prompt node的embedding 和class node的embedding,对于某个节点,如果我们要预测它关于某个任务的标签,只需要把它和这个任务对应的NOI Prompt Node连接起来,根据输出就可以知道这个节点在该任务下的标签。
但是,OFA存在以下问题:必须是已知任务,无法泛化到新的任务,因为新的任务NOI Prompt Node 未知,也不知道新任务的Class Node是什么, 因此下游任务必须得是预训练阶段见过的任务,不能是一个全新的任务。此外,可以看出由于OFA是一个supervised foundation model,所以他和参与训练的任务标签是强相关的,很难泛化到训练阶段没有见过的任务,GOFA就是用来解决OFA存在的问题,GOFA认为foundation model的训练过程应该不能有标签信息加入的,也就是需要是自监督的。
Unified Task Formats
模型的输入必须要统一,所以和过去的很多方法一样,GOFA用TAG来统一所有graph:
$$ G=\left\{V, E, X_V, X_E\right\} $$
自监督语言模型里面,模型训练的目标叫next-token prediction 通常是补全句子,比如给定一个句子,自监督语言模型的训练目标是基于这个句子来预测生下来的tokens,假设剩下来的token是apple,参数优化的目标就是使生成apple的likelihood要最大, 如下图所示:
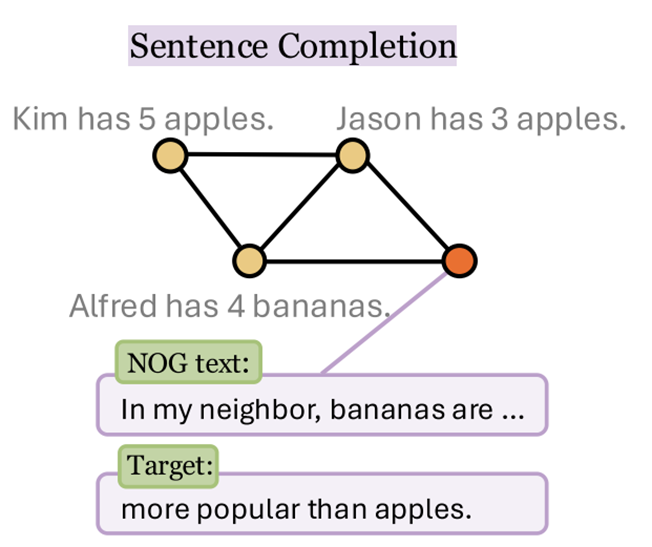
GOFA提出的自监督图模型,也继承这种做法,模型学习的目标是补全TAG图,有个目标节点,叫node of generation,也就是自监督学习要补全的节点,把它的文本属性截断,然后自监督学习的目标就是要生成这个NOG node 的剩下内容。但是,如果要生成这个节点剩下的内容的话,不能无视这种图中的边信息,因为图的结构可以帮助这个自监督任务生成正确的信息,所以自监督图模型需要充分理解图结构。比如上图中的Target就需要在理解边关系的情况下补全句子,因此,模型需要充分学习图结构。
GOFA: Generative One-For-All Model
怎么才能在充分学习图结构的情况下,补全目标节点的text,是GOFA的主要目标。
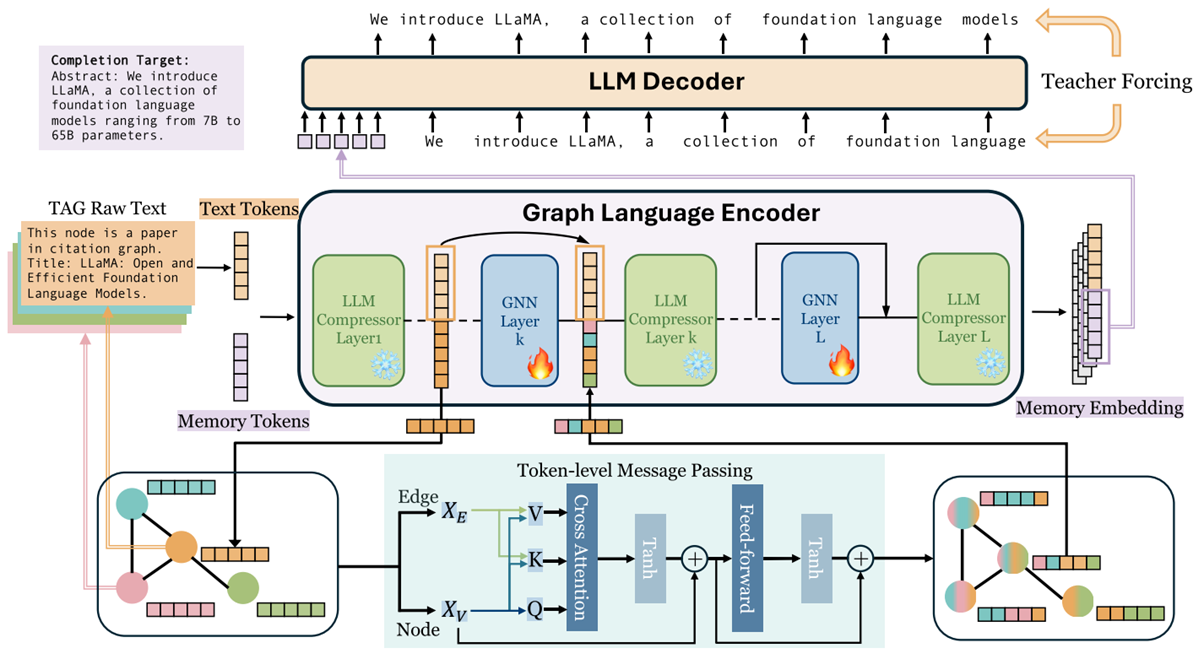
GOFA主要由2个模块组成,一个是Graph Language Encoder,还有一个是LLM Decoder。其中Graph Language Encoder的目的是用来学习节点的表示向量, 其中交替训练了LLM compressor和GNNlayer,LLM compressor用来学习TAG graph中的语义信息,GNN用来学习结构关系信息(也就是NOG Node和其他节点的交互)。因为GNN已经可以学到图的结构信息了,LLM compressor的作用就是把文本信息压缩到GNN学习的节点表示中。 第二个模块是一个LLM decoder,它的训练目标是,基于节点的向量表示,预测下一个token。
Graph Language Encoder
Graph Language Encoder 包含LLM compressors和GNN Layers。对于一个NOG Node的text attribute,若它由 $l$个tokens组成 $\{x_i\}_{i = 1}^l$,通过一个pretrained LLM 比如Mistral-7B,可以将每个token映射为一个token embedding $q(x_i)$。那么将NOG Node的所有token $\left\{q\left(x_i\right)\right\}_{i=1}^l$ pooling成一个向量可以作为NOG Node的node feature vector。但是这种做法丢失太多semantic information。
Solution: 将NOG Node的text attribute压缩为 $K$个向量,且 $K «l$。具体来说,首先定义 $K$个memory tokens $\{m_1, \cdots. m_K \}$ with their lookup initial embeddings $\left\{q\left(m_j\right)\right\}_{j=1}^K$用于接收压缩后的text tokens。
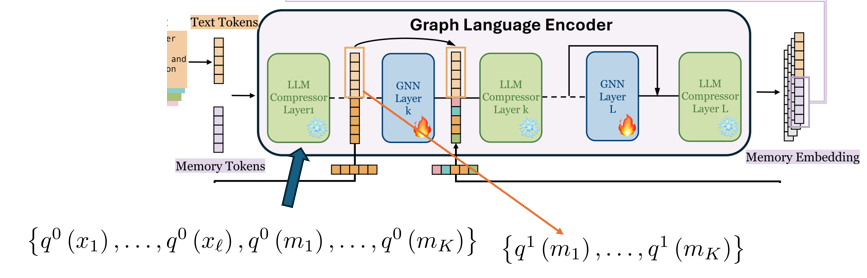
然后把 $l$个text tokens和 $K$个memory tokens 拼起来输入到LLM Compressor Layer1,由于LLM的是multiple transformer layers (self-attention mechanisms),因此可以捕获memory tokens和text tokens之间的dependencies。所以通过这种方式,text tokens的信息可以被压缩到memory tokens中。
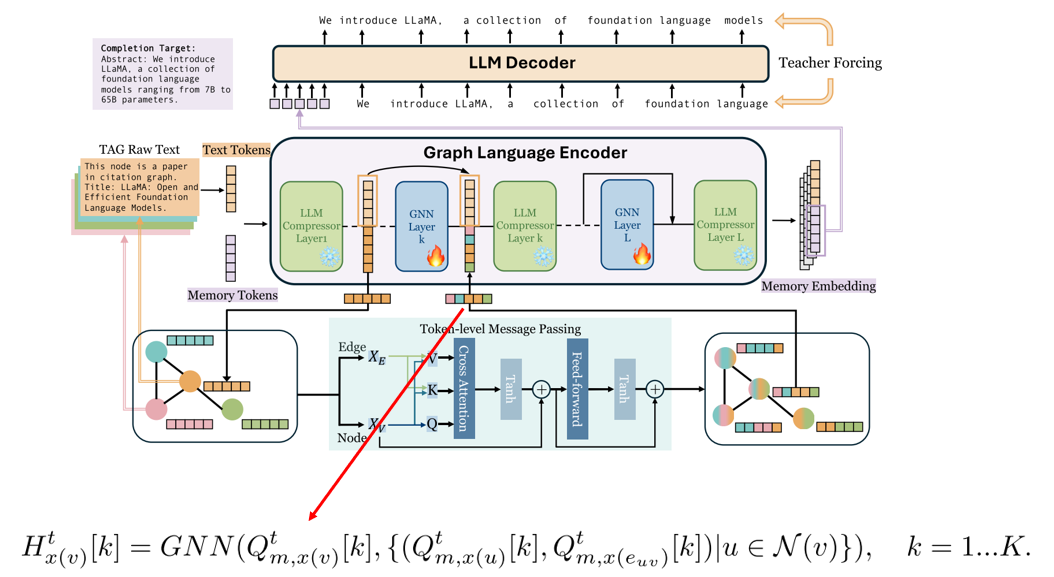
此时,这个目标节点(NOG Node)的特征向量就被压缩到 $K$个token embeddings,但是这个时候 $K$个memory tokens并没有学到图的结构信息。为了编码图的结构信息,将这 $K$个memory token embeddings作为node features输入GNN中,做一个 $K$通道的聚合GNN。通过上图中的Token-level Message Passing,可以将图的结构信息编码到 NOG Node的 $K$个memory tokens中,然后将GNN处理过的memory token embeddings再和text token embeddings拼起来,用LLM compressors将文本信息压缩到 memory token embeddings中。经过 $L$次的交替LLM压缩和训练GNN后,这里得到的 $K$个memory token可以认为是充分节点的text 信息和图的结构信息。
LLM Decoder
The memory tokens $Q_{m,x}$ ( $m$:memory; $x$: 节点 $x$) of every node contain information about the text on the node, the surrounding node text, and the graph structure due to the message-passing process in the GNN layers. 然后,对于NOG节点 $v$,它的completion target 是 $y$,GOFA将NOG Node的memory tokens $Q_{m,x}$插入到target text tokens的前面,然后输入LLM Decoder中来生成下一个token。优化目标是最大化completion target 的log likelihood,也就是生成正确tokens的概率。
$$ \operatorname{CrossEntropy}\left(\left\{l\left(m_K\right), l\left(x_1\right), \ldots, l\left(x_{l-1}\right)\right\},\left\{x_1, \ldots, x_l\right\}\right) . $$
在GOFA的influence阶段,输入一个新图和每个节点的text attribute,并且给出目标节点NOG Node,就可以补全该NOG Node。