论文地址:GraphGAN
Introduction
GAN是CV上非常火的方法,作者将其引入Network Embedding领域。为了达到这个目的,首先,作者将当前的NE model分成了两类,分别是生成模型(generative model)和判别模型(discriminative model)。简单来说,生成模型。
所谓生成模型,就是对于每个节点$v_c$,都存在一个潜在的真实连接分布$p_{true}(v|v_c)$, 这个分布反映了由条件生成样本的概率,因此,生成式模型的目的就是求网络中边的极大似然。比较经典的方法有DeepWalk,是通过随机游走来获得center node的上下文,然后最大化上下文节点的似然。Node2vec拓展了DeepWalk,提出了biased随机游走,使得模型在为给定节点生成上下文节点时具有更多的灵活性。
所谓判别模型,目的是学习一个分类器来直接预测边是否存在。将两个节点视为输入特征,然后输出预测的两个节点之间有边的概率,即$p(edge|(v_i,v_j))$,常见的方法有SDNE,PPNE。
于是,本文结合生成对抗网络(GAN),提出了GraphGAN来同一生成和判别器。其中生成器$G(v|v_c)$试图拟合真实的连接概率分布$p_{true}(v|v_c)$,生成最可能和$v_c$有链接的点。判别器$D(v,v_c)$尝试区分强连接节点对和若连接节点对,然后计算$v$和$v_c$存在边的可能性。简单来说,就是把生成器生成的可能与$v_c$有边的节点放入判别器计算两者有边的概率。
除此之外GAN框架下,然而生成器的连接分布是通过softmax实现的,但是传统的softmax无法适配生成器,原因如下:
(1).传统的softmax对网络中的所有节点一视同仁,缺乏对网络结构相似度信息的考虑。
(2).计算成本太高。
因此,论文中提出了新的生成器实现方法 Graph Softmax。并且证明GS具有归一化(normalization)、网络结构感知(graph structure awareness)和高计算效率(computational efficiency)的性质。相应的,文中也提出了基于随机游走(random walk)的生成器策略。
Model
这里挑特别的来说。$\mathcal{N}(v_c)$表示和$v_c$直接相连的节点集。我们把给定节点$v_c$与任意节点$v \in \mathcal{V}$的真实连接分布表示为$p_{true}(v|v_c)$。这么看$\mathcal{N}(v_c)$可以看做从$p_{true}(v|v_c)$中采样的集合。文章的目的是学习两个模型:
Generator $G(v|v_c;\theta_G)$ 生成器,尝试拟合真实连接分布$p_{true}(v|v_c)$,并且从节点集$\mathcal{V}$中生成最有可能和$v_c$相连的节点。
Discriminator $D(v,v_c;\theta_G)$ 判别器,目的是判断已对接点$(v,v_c)$的连接性。$D(v,v_c;\theta_G)$输出$v$和$v_c$有边的概率。
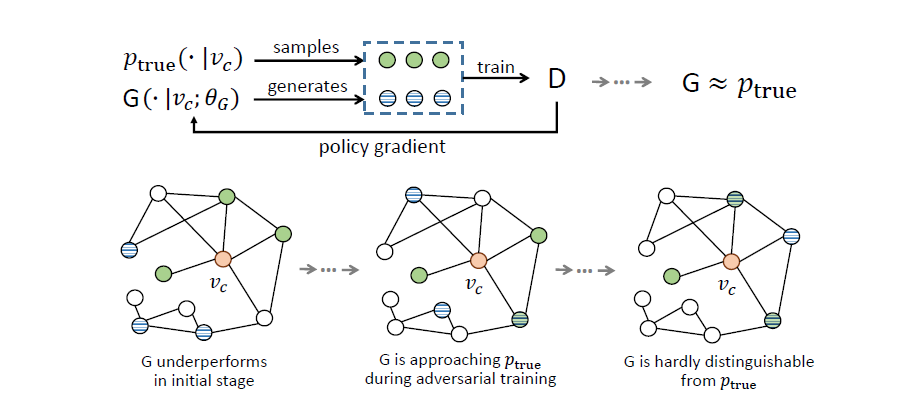
生成器$G$尝试完美拟合$p_{true}(v|v_c)$,并且生成和$v_c$真实邻居高度相似的节点来欺骗判别器。相反,判别器尝试发现输入的顶点是真实的节点对或者有生成器生成出的样本。这是一个极大极小游戏,目标函数$V(G,D)$:
$$\min_{\theta_G} \max_{\theta_D} V(G,D)=\sum_{c=1}^V (\mathbb{E}_{v \sim p_{true}(\cdot|v_c)}[\log D(v,v_c;\theta_D)]+\mathbb{E}_{v \sim G(\cdot|v_c;\theta_G)}[\log(1-D(v,v_c;\theta_D))])$$
上面这个公式是本文最关键的公式,以我的分析就是:在给定$\theta_D$的情况下,对其最小化。先来分析$\max_{\theta_D}V(G,D)$,即给定$\theta_G$,使原式最大。当给定$\theta_G$时,通过改变$\theta_D$,使$\mathbb{E}_{v \sim p_{true}(\cdot|v_c)}[\log D(v,v_c;\theta_D)]$达到最大(是判别器D拟合真实分布),同时使$\mathbb{E}_{v \sim G(\cdot|v_c;\theta_G)}[\log(1-D(v,v_c;\theta_D))]$最大,即尽可能减小选定节点$v_c$与判别器中生成的$v_c$邻居节点与$v_c$连接的可能性。然后在给定$\theta_D$的情况下,通过改变生成器$\theta_G$继续生成节点,使得$\mathbb{E}_{v \sim G(\cdot|v_c;\theta_G)}[\log(1-D(v,v_c;\theta_D))]$尽可能小,即上一步的判别器尽可能把当前生成器生成的节点认为是邻居。 之后再更新判别器,以此类推。这样$G$和$D$各自提高性能,最终$G$生成的分布和真实连接分布无法区分,这样达到最好的效果。整体过程如下图所示:
Discriminator Optimization
对于判别器来说是个简单的sigmoid函数,来计算两个输入节点的表示向量:
$$D(v,v_c;\theta_D)=\frac{1}{1+\exp(-d^\top_v d_{v_c})}$$
其中,$d_v$,$d_{v_c}$是两个输入节点关于判别器$D$的表示向量,$\theta_D$是所有节点表示向量的结合。注意到上面的公式只涉及$v$和$v_c$, 我们只需要更新$d_v$,$d_{v_c}$,通过梯度下降的方法可以实现:
Generator Optimization
对于生成器来说,目标是最小化判别器将生成的样本判断为负样本的对数似然(概率)。换句话说,生成器会调整自己的连接分布(通过调整生成的所有节点的向量表示$\theta_G$)来提升对生成样本的判别分数。由于$v$的采样时离散的,所以使用policy gradient来计算$V(G,D)$关于$\theta_G$的梯度:
为了理解上述公式,注意到$\nabla_{\theta_G}V(G,D)$是一个由$\log(1-D(v,v_c;\theta_D))$加权的梯度$\nabla_{\theta_G}\log G(v|v_c;\theta_G)$的求和,直观上说,这意味着有高概率是负样本的节点会将生成器G“拉着”远离自己(因为我们在$\theta_G$上执行梯度下降)。
Graph Softmax
graph softmax的核心思想是定义一种新的计算连接性概率的方式,满足以下性质:
- 归一化:$\sum_{v \neq v_c;\theta_G}=1$。
- 图结构感知:生成器充分利用网络中的结构信息,来估计真实连接分布,如果两个节点在图上越远,那么他们间有边的概率越小。
- 高效的计算:和传统的softmax不同,$G(v|v_c;\theta_G)$的计算应只涉及图中的一小部分点。
因此,本文以图中节点$v_c$为例,以$v_c$为根构建一棵BFS树$T_c$。$\mathcal{N}_c(v)$为节点$v$在$T_c$上的邻居集合(包括他的父节点和所有子节点)。对于一个given vertex $v$和它的一个邻居$v_i \in \mathcal{N}_c(v)$,定义概率为:
$$p_c(v_i|v)=\frac{\exp (g_{v_i}^\top g_v)}{\sum_{v_i \in \mathcal{N}_c(v)} \exp(g_{v_j}^\top g_v)}$$
这是一个在$\mathcal{N}_c(v)$上的softmax函数。
为了计算$G(v|v_c;\theta_G)$,注意到在$T_c$上,根节点$v_c$到每个节点$v$都有一条唯一的路径, 把这条路径记为$P_{v_c \to v}=(v_{r_0},v_{r_1},…,v_{r_m})$,其中$v_{r_0}=v_c$, $v_{r_m}=v$,那么在graph softmax中,将$G(v|v_c;\theta_G)$定义为:
$$G(v|v_c;\theta_G)\triangleq (\prod^m_{j=1} p_c(v_{r_j}|v_{r_{j-1}})) \cdot p_c(v_{r_{m-1}}|v_{r_m})$$