Introduction
加深GNN层数来增加感受野会导致优化不稳定性,比如梯度消失和oversmoothing。 因此本文采用Transformer-based self-attention来学习成对节点间的长距离关系,并且提出一种新型的readout池化机制来学习global graph embedding。即在一个GNN模块后接一个置换不变(permutation-invariant)Transformer, GNN模块捕获local信息,Transformer捕获global信息。
GNN作为一种专门的架构医学系节点直接邻域结构的局部表示, 而Transformer作为全局推理模块以位置无关的方式计算所有成对节点的交互。作者认为,一个没有positional encoding的Transformer是置换不变的,因此很适合图。
Motivation
强关系Inductive bias(我的理解是Homophily假设) 鼓励学习局部短距离的关联性。 而对于长距离相关性,结构化较低的模块(不需要过于考虑图的结构信息)更受欢迎。
GraphTrans leaves learning long-range dependencies to Transformer, 通过Transformer来学习图中所有节点对的依赖关系而不是只关注局部邻居。
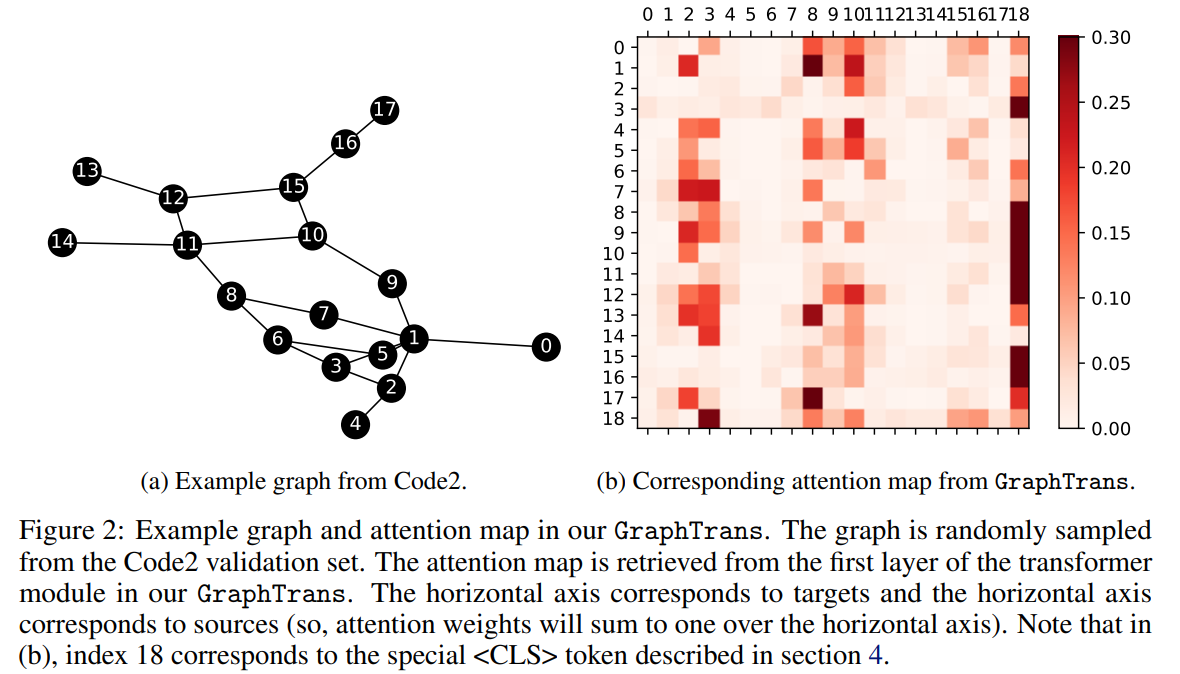
下图中展示了一个子图的attention map。一共有17个节点,横坐标表示目标节点,纵坐标表示源节点,第$i$行第$j$列表示节点$i$在Transformer中聚合$j$的attention权重。第18行为一个特殊的$<CLS>$token 作为图的readout embedding。结合本文的SOTA效果,表面在学习长距离依赖时不考虑图结构先验(spatial priors)对Graph summarization(graph-level representation)是有必要的
Model
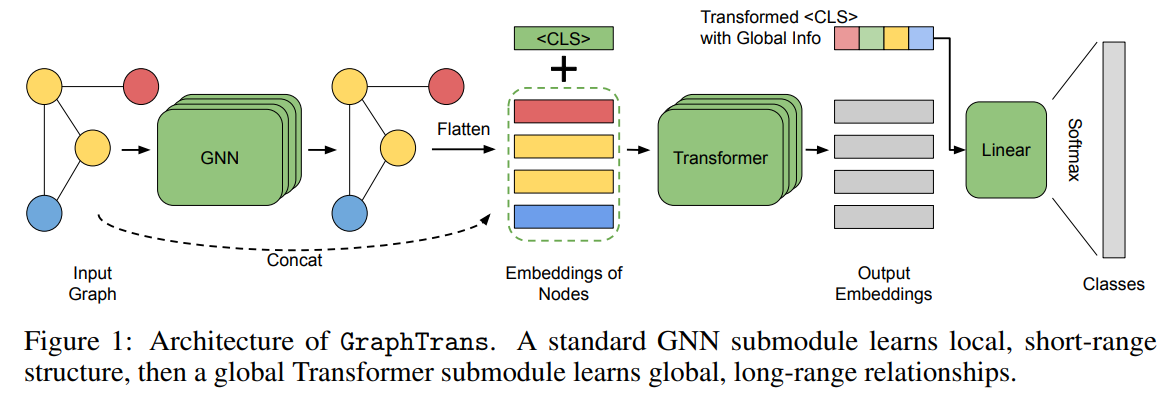
GNN Module
一个通用的GNN模块: $$ \boldsymbol{h}_{v}^{\ell}=f_{\ell}\left(\boldsymbol{h}_{v}^{\ell-1},\left\{\boldsymbol{h}_{u}^{\ell-1} \mid u \in \mathcal{N}(v)\right\}\right), \quad \ell=1, \ldots, L_{\mathrm{GNN}} $$
Transformer Module
通过上面的GNN模块,我们可以得到每个节点的embedding $h_{v}^{L_{\mathrm{GNN}}}$, 将所有节点作为Transformer的Input。传统Transformer中输入先计算Self-attention(当前输入的$Q$向量和所有节点的$K$向量做内积得到输入节点和其他节点的att值,再用这个att值来为当前输入节点加权聚合所有节点的$V$向量),聚合后再和自身相加做residual,然后在做Layer Norm, 即对节点$i$的表示做Layer Norm 为$x_i^\prime = \frac{x_i-m}{\sigma}$, 其中$m$为$x_i$的均值, $\sigma$为$x_i$的标准差。
这里的Transformer不同的是, 先对所有节点做一次MLP,然后直接计算Layer Norm: $$ \overline{\boldsymbol{h}}_{v}^{0}=\operatorname{LayerNorm}\left(\boldsymbol{W}^{\text {Proj }} \boldsymbol{h}_{v}^{L_{\mathrm{GNN}}}\right) $$ 其中$\boldsymbol{W}^{\text {Proj }} \in \mathbb{R}^{d_{\mathrm{TF}} \times d_{L_{\mathrm{GNN}}}}$, 把GNN的输出维度转为TF的输入维度$d_{\mathrm{TF}}$。将所有节点的GNN node embeddings作为Transformer的输入(无positional encoding)。 每个节点的$Q$, $K$和$V$向量分别用$\boldsymbol{W}_{\ell}^{Q}, \boldsymbol{W}_{\ell}^{K}, \boldsymbol{W}_{\ell}^{V} \in \mathbb{R}^{d_{\mathrm{TF}} / n_{\text {head }} \times d_{\mathrm{TF}} / n_{\text {head }}}$计算, 对于第$\ell$层 Transformer, 节点$v$ 的$Q$向量$Q_v = \boldsymbol{W}_{\ell}^{Q} \overline{\boldsymbol{h}}_{v}^{\ell-1}$和节点$u$的$K$向量$K_u = \boldsymbol{W}_{\ell}^{K} \overline{\boldsymbol{h}}_{u}^{\ell-1}$做内积,得到两个节点之间的attention。然后用$\alpha_{v, u}^{\ell}$来为节点$v$聚合其他所有节点的$V$向量$V_u = \boldsymbol{W}_{\ell}^{V} \overline{\boldsymbol{h}}_{u}^{\ell-1}$, 如下所示: $$ a_{v, u}^{\ell}=\left(\boldsymbol{W}_{\ell}^{Q} \overline{\boldsymbol{h}}_{v}^{\ell-1}\right)^{\top}\left(\boldsymbol{W}_{\ell}^{K} \overline{\boldsymbol{h}}_{u}^{\ell-1}\right) / \sqrt{d_{\mathrm{TF}}} \tag{1} $$
$$ \alpha_{v, u}^{\ell}=\operatorname{softmax}_{u \in \mathcal{V}}\left(a_{v, u}^{\ell}\right) \tag{2} $$
$$ \overline{\boldsymbol{h}}_{v}^{\prime \ell}=\sum_{w \in \mathcal{V}} \alpha_{v, u}^{\ell} \boldsymbol{W}_{\ell}^{V} \overline{\boldsymbol{h}}_{u}^{\ell-1} \tag{3} $$
<CLS> embedding as a GNN “readout” method
Graph Pooling 部分旨在基于node embedding,得到整个图的一个global embedding. 大多数pooling方法为简单的mean,sum, 或者构造一个virtual node连接到所有节点并参与训练,这个virtual node聚合所有节点的信息作为global embedding。
本文提出special-token readout module。具体来说,对Transformer的输入$[\overline{\boldsymbol{h}}_{v}^{0}]_{v\in V}$, where $\overline{\boldsymbol{h}}_{v}^{0} \in \mathcal{R}^{d_{TF}}$我们添加一个额外的可学习embedding (可以被认为是一个额外virtual node)$\bar{h}_{\langle\mathrm{CLS}\rangle} \in \mathbb{R}^{d_{\mathrm{TF}}}$, 这样 Transformer 的输入就变为$[\overline{\boldsymbol{h}}_{v}^{0}]_{v \in V} \cup \bar{h}_{\langle\mathrm{CLS}\rangle}$, 因为训练过程中$\overline{\boldsymbol{h}}_{v}^{0}$回聚合来自所有节点的信息,所以用它来作为readout embedding。 最终Transformer输出的token embedding $\overline{\boldsymbol{h}}_{<\mathrm{CLS}>}^{L_{\mathrm{TF}}}$ 再过一层MLP后用Softmax输出图的prediction: $$ y=\operatorname{softmax}\left(\boldsymbol{W}^{\mathrm{out}} \overline{\boldsymbol{h}}_{<\mathrm{CLS}>}^{L_{\mathrm{TF}}}\right) $$