Introduction
GNN的neighborhood aggregation中会引入邻域中任务无关的邻居,所以要移除图中有大量任务无关的边,顾本文提出NeuralSparse来解决该问题。
在构造数据集时,两个节点连接的动机可能与拿到这张图后要进行的下游任务无关,例如下游任务是节点分类,那么和这个任务相关的连接应是同类节点间产生边。但是构造图数据集是的两个节点连接的动机可能是特征相似的节点(不一定同类)。
下图给出一个例子,Blue 和 Red节点分别采样自两个独立的二维Gaussian distribution, 图1(a)显示两类节点的原始features有大量重合。对于每个节点,随机抽取10个其他节点作为他的邻居,这样生成的图(图1(b) )中的边和node label没有任何关系,即所有边都与节点分类任务无关。在这个图上做GCN得到(图1(b)下方)的node embedding,可以看到GCN学到的node embedding在任务无关的边上,无法区分两类节点。 图1(c)是DropEdge学到的node embedding,图1(d)为本文的NeuralSparse学到的node embedding。

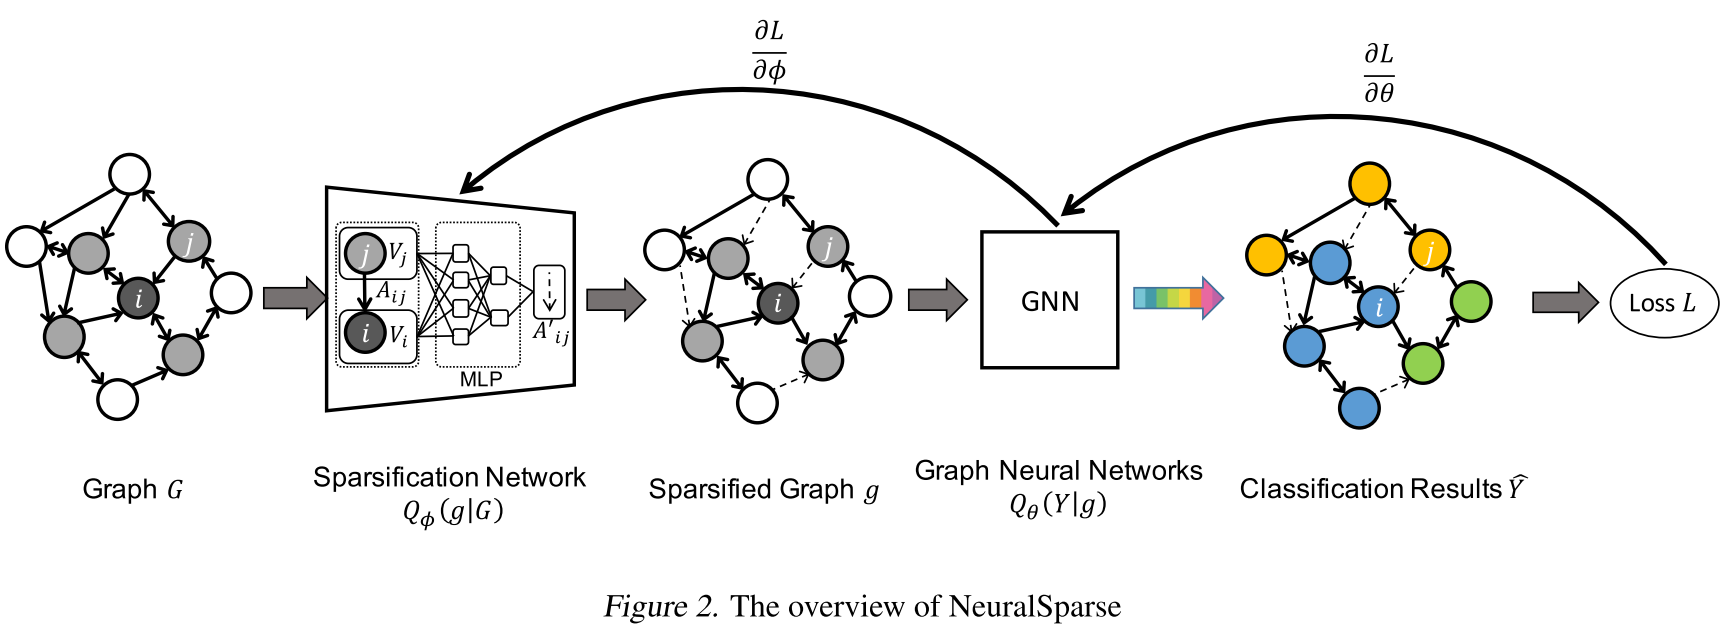
Present work:根据监督信号来选择任务相关的边。 由sparsification network 和GNN两个模块组成. sparsification network旨在参数化稀疏过程,即在给定预算下, 为每个节点选择任务相关的一节邻居。在训练阶段,优化稀疏策略,即训练一个可以将图稀疏化的网络。在测试阶段,将测试图输入网络,得到一个稀疏化的图。
NeuralSparse
Theoretical justification
首先从统计学习角度建模问题。将预测任务定义为$P(Y|G)$, 其中$Y$是预测目标,$G$是输入图。本文利用稀疏化子图来移除任务无关的边, 问题形式化为: $$ P(Y \mid G) \approx \sum_{g \in \mathbb{S}_{G}} P(Y \mid g) P(g \mid G) $$ $g$是一个稀疏化子图,$\mathbb{S}_{G}$为$G$的稀疏化子图集合。 $P(Y \mid g)$ 为给定一个稀疏化子图$g$,用$g$过GNN后预测为$Y$的概率。 $$ \sum_{g \in \mathbb{S}_{G}} P(Y \mid g) P(g \mid G) \approx \sum_{g \in \mathbb{S}_{G}} Q_{\theta}(Y \mid g) Q_{\phi}(g \mid G) $$ 用函数来近似(计算) 分布, 即给定$g$ 预测为$Y$的概率$ P(Y \mid g)$定义为一个参数为$\theta$的函数$Q_{\theta}(Y \mid g)$, 从$G$中获得子图$g$的概率$P(g \mid G)$定义为一个参数为$\phi$的函数$Q_{\phi}(g \mid G)$。
$Q_{\phi}(g \mid G)$表示输入$G$, 生成一个子图分布,从分布中采样得到子图$g$的概率, 为了使得分布中采样这个过程可微,本文采用reparameterization tricks,使得: $$ \sum_{g \in \mathbb{S}_{G}} Q_{\theta}(Y \mid g) Q_{\phi}(g \mid G) \propto \sum_{g^{\prime} \sim Q_{\phi}(g \mid G)} Q_{\theta}\left(Y \mid g^{\prime}\right) $$ $g^{\prime} \sim Q_{\phi}(g \mid G)$表示给定图$G$,生成一个子图分布(每种子图的采样概率)。$\sum_{g^{\prime} \sim Q_{\phi}(g \mid G)} Q_{\theta}\left(Y \mid g^{\prime}\right)$: 表示从子图分布中采样的子图来预测label $Y$的概率。
Goal: 1. 找到合适的$Q_{\phi}(g \mid G)$, 使得它生成的分布可以采样到最佳的稀疏化子图 , 即通过优化$\phi$使得$Q_{\phi}(g \mid G)$生成的子图分布中采样到最佳子图的概率是最大的。 2. 找到合适的$Q_{\theta}(Y \mid g)$表示优化GNN,使得采样出的$g$可以最好的预测label。
Architecture
包含两个模块: sparsification network 和GNNs.
Sparsification Network
目的为输入图生成稀疏化子图,即为每个节点的边生成一个分布,表示边被采样的概率,然后为节点采样边,从而实现采样的系数子图。首先定义所有候选子图。
k-neighbor subgraphs: 给定输入图$G$,一个$k$-neighbor subgraph和图$G$有相同的节点集,每个节点可以从他的邻居中选择不多于$k$条边。
理由: 超参数$k$可以用来调整任务相关的图数据量。如果$k$是低估的,那么GNN处理的任务相关数据不足,如果$k$被高估,那么下游GNN会拟合更多无关数据。
Sampling k-neighbor subgraphs:给定$k$和一个图$G=(V, E, \mathbf{A})$, 以节点$u$为例,令$\mathbb{N}_u$为$u$的一阶邻居。
- $v \sim f_{\phi}\left(V(u), V\left(\mathbb{N}_{u}\right), \mathbf{A}(u)\right)$, 其中,$f_{\phi}(\cdot)$是一个函数,输入为节点$u$的节点属性$V(u)$,节点$u$的邻居属性$V\left(\mathbb{N}_{u}\right)$, 和$u$的边属性$\mathbf{A}(u)$。输出为$u$的邻居分布,$v$从该邻居分布中采样。 比如当前$u$有3个节点,$f_\phi$生成这三个节点的采样分布[0.1, 0.3, 0.6], 那么从这个分布中随机采样一个节点$v$作为$u$的重构邻居。
- 采样出的节点$v$作为$u$的重构邻居,即$E(u,v)$作为边保留下来。
- 重复上述过程$k$次,得到$u$的$k$个重构邻居。
注意,上述采样过程为不放回过程(sampling without replacement),即邻居只能被选择一次, $f_{\phi}(\cdot)$对所有节点共享,即一个$f_{\phi}(\cdot)$,每个节点都输入它来获得邻居采样分布。
Making samples differentiable 为了使样本的采样过程可微,本文采用基于Gumbel-Softmax的NN来实现采样函数$f_{\phi}(\cdot)$。
Gumbel-Softmax [1,2] 是一种reparameterization trick,用于以可微的方式生成离散样本。参数$\tau$越小,生成的连续向量越sharp,越接近one-hot。
以节点$u$为例,$f_\phi(\cdot)$如下:
$\forall v \in \mathbb{N}_u$: $$ z_{u, v}=\operatorname{MLP}_{\phi}(V(u), V(v), \mathbf{A}(u, v)) $$
$\forall v \in \mathbb{N}_u$,使用softmax来计算边被采样的概率: $$ \pi_{u, v}=\frac{\exp \left(z_{u, v}\right)}{\sum_{w \in \mathbb{N}_{u}} \exp \left(z_{u, w}\right)} $$
使用Gumbel-Softmax来生成可微样本: $$ x_{u, v}=\frac{\exp \left(\left(\log \left(\pi_{u, v}\right)+\epsilon_{v}\right) / \tau\right)}{\sum_{w \in \mathbb{N}_{u}} \exp \left(\left(\log \left(\pi_{u, w}\right)+\epsilon_{w}\right) / \tau\right)} $$
其中, $x_{u, v}$是一个scalar,$\epsilon_{v}=-\log (-\log (s))$,$s$从$\mathrm{Uniform}(0,1)$中采样, $\tau$是一个temperature超参数,$\tau$越小,分布$x_u$越接近one-hot。
Algorithm
算法如下:
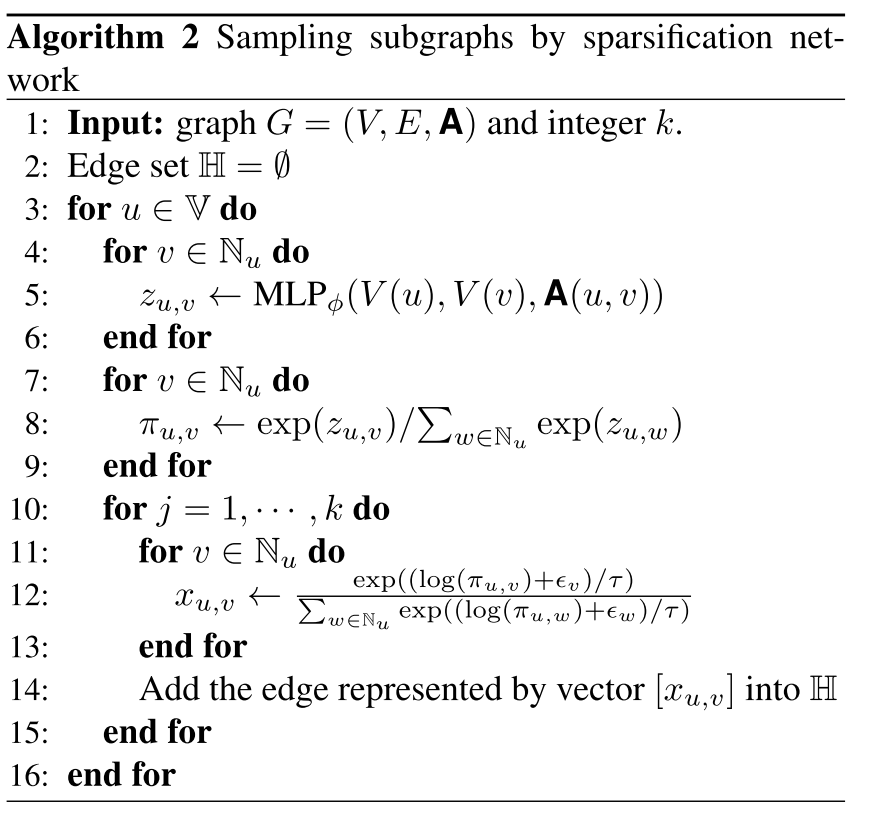
对所有节点$u \in \mathbb{V}$逐个稀疏化: 先遍历$u$的每个邻居$v$, 对于每个$v$ 通过公式$z_{u, v}=\operatorname{MLP}_{\phi}(V(u), V(v), \mathbf{A}(u, v))$ 计算它对于$u$的分数, 然后将$u$的所有邻居$v$的分数用softmax变成概率。
为$u$做$k$次采样, 每次采样过程如下: 每次采样遍历$u$的所有邻居$v$,根据$x_{u, v}=\frac{\exp \left(\left(\log \left(\pi_{u, v}\right)+\epsilon_{v}\right) / \tau\right)}{\sum_{w \in \mathbb{N}_{u}} \exp \left(\left(\log \left(\pi_{u, w}\right)+\epsilon_{w}\right) / \tau\right)}$计算$u$到每个邻居的$x_{u,v}$, 每次迭代产生一个向量$\left[x_{u, v}\right]$,用来表示采样出来的边,经过$k$次迭代,产生$k$个表示边的向量,$\tau$越小,每个向量越接近one-hot。 每个向量$\left[x_{u, v}\right]_{v \in \mathbb{N}_u}$表示$u$的一个采样邻居,每个$u$有$k$个这样的邻居表示向量,那么网络中的所有边$\mathbb{H}$就有$|\mathbb{V}|k$个这样的向量,每个向量表示要保留的一条边,得到稀疏化子图,反向传播时,先更新GNN参数,然后直接对$f_\phi$的参数求梯度, 如上图所示。
Reference
[1] Jang, E., Gu, S., and Poole, B. Categorical reparameteriza- tion with gumbel-softmax. In ICLR, 2017.
[2] Maddison, C. J., Mnih, A., and Teh, Y. W. The concrete distribution: A continuous relaxation of discrete random variables. In ICLR, 2017.