What is in-context learning?
“In-Context Learning is a way to use LLMs to learn tasks given only a few examples. During in-context learning, we give the LM a prompt that consists of a list of input-output pairs that demonstrate how to perform a task. At the end of the prompt, we append a test input and allow the LM to make a prediction just by conditioning on the prompt and predicting the next tokens. For example, to answer the two prompts below, the model needs to examine the training examples to figure out the input distribution (financial or general news), output distribution (Positive/Negative or topic), input-output mapping (sentiment or topic classification), and the formatting. “
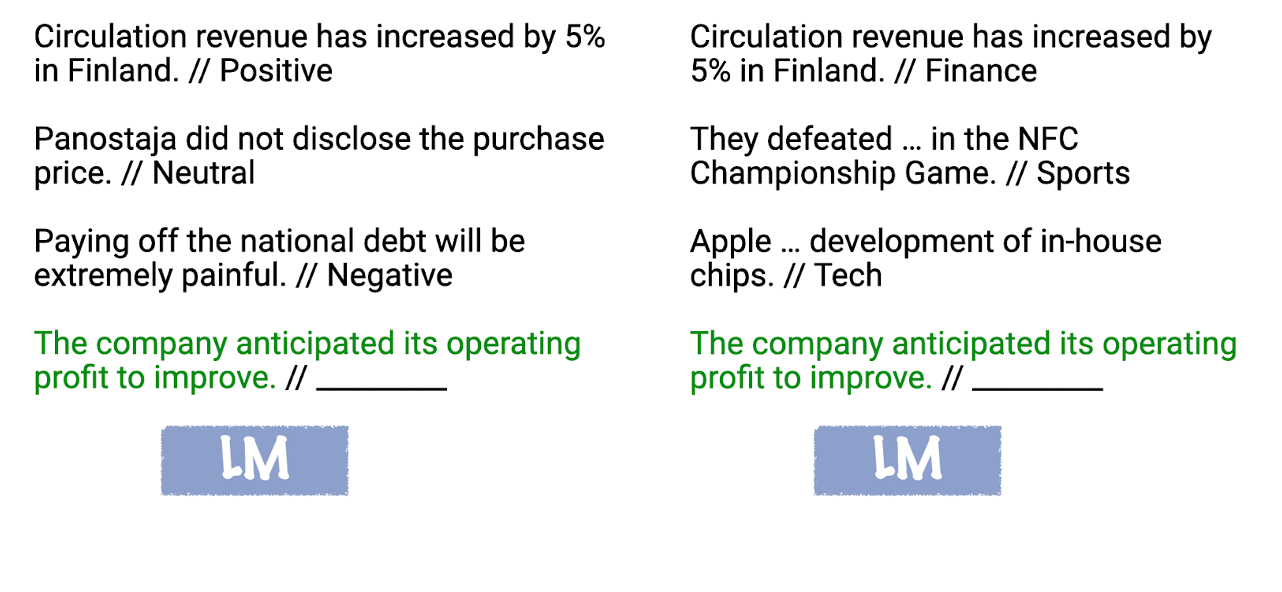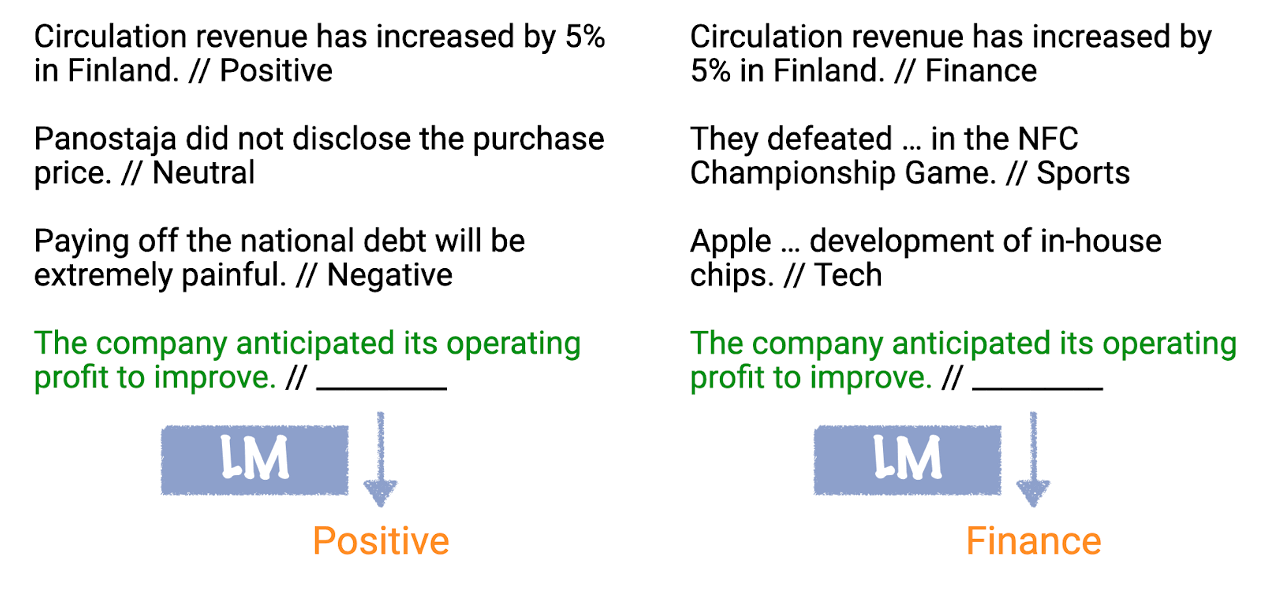
如上图所示,在prompt中包含一些上下文input-output pairs来演示(demonstrate)如何执行任务。在这些prompt的最后添加text input token来让LLM学习上下文中的演示来执行text input token的任务。
Challenge
Foundation Model指用单一模型来解决多个任务。但是Graph Foundation Model面临以下挑战:(1)不同来源的图数据在feature表征上通常完全不同。比如molecular graph中的节点特征是其中原子nominal feature的索引,e-commerce networks中的节点特征通常用Bag-of-Word来编码。这些不同来源的图数据特征维度、语义信息和尺度的差别都很大,几乎不可能用同一个模型来学习他们的表示。(2)不同的下游任务涉及图的不同部分(节点级、边级、图级)需要不同的策略和方法来学习表示。(3)如何设计统一的模型来实现跨领域和in-context learning是不确定的。
OFA
用TAG来统一不同领域的图(都转化为TAG形式)
将不同Domian的图转化为统一的TAG形式
用human-interpretable language来描述节点和边的属性,从而使LLM可以将这些text attribute编码到同一个空间。具体来说,通过以下方式来生成每个节点的text feature: 将不同domain的graph的节点属性用统一形式的文本来描述,如上图中,对于一个节点的特征,它的文本描述以Feature node开头,后面的每个
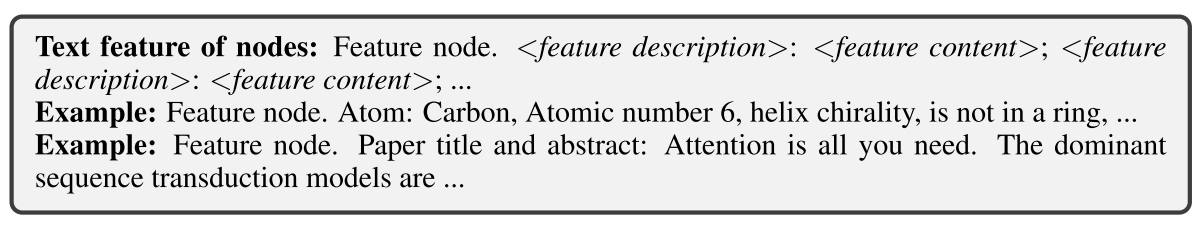
将不同domain的graph的节点属性用统一形式的文本来描述,如上图中,对于一个节点的特征,它的文本描述以Feature node开头,后面的每个 $<\text{feature describe}>:<\text{feature content}>$是该节点的一个type-content文本对。例如对于一个molecule graph,其中的一个节点是原子,那么它的type是Atom,它的content是该原子的属性文本描述Carbon, Atomic number 6, helix chirality。如果是Citation Network, type是“Paper title and abstract”,content是“Attention is all you need. balabala” (该文章具体的标题和摘要) 同理,边的text feature以Feature edge开头进行文本描述。
在用以上方式得到节点 $v_i$的text feature $s_{v_i}$和边 $e_{ij}$的text feature $s_{e_{ij}}$后,用LLM(sentence transformer, e5-large-v2, or Llama2)来将每个节点和边的text feature编码为vector embeddings:
$$ x_i = \operatorname{LLM}(s_{v_i}), \quad x_{ij} = \operatorname{LLM}(s_{e_{ij}}) $$
用Nodes-of-Interest (NOI)来统一不同的图任务
图上的任务主要分为3中:node-level tasks,link-level tasks和graph-level tasks。如果要用一个模型来处理这些任务的话,需要将这些任务统一为一个任务以便于在图数据上训练。
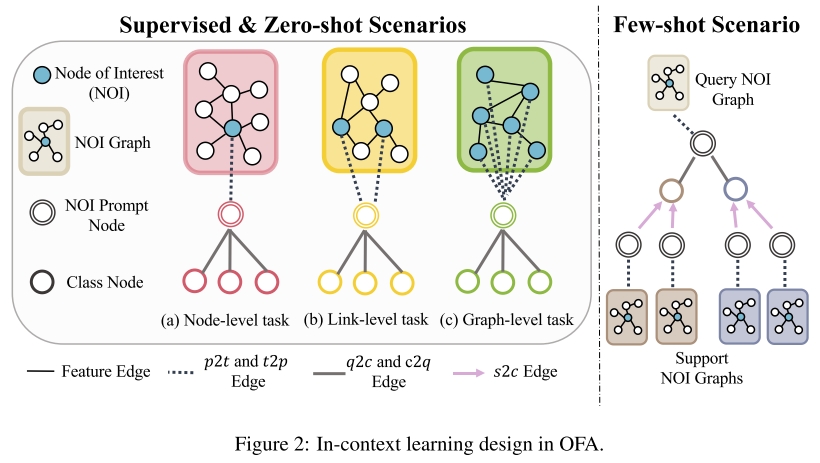
Nodes-of-Interest (NOI)指的是一个任务的目标节点(任务感兴趣的节点),如上图的蓝色节点所示,表示为 $\mathcal{T}$。
- 对于节点级任务,NOI是待预测节点集合。
- 边级任务NOI是待预测是否有边的节点对。
- 图级任务NOI是待预测图中的所有节点。
待训练的有很多图,有的图要做节点分类,有的图做链路预测,有的图做图分类,通过构造NOI subgraph的方式,无论是什么任务,都把每个图中所有的 与任务相关的节点 (nodes-of-interest)提取出来。
若一个NOI节点 $v$的 $h$-hop局部子图表示为 $\mathcal{S}_h(v)$,那么NOI中所有目标节点的局部子图共同构成了一个NOI subgraph,表示为 $\mathcal{G}_h (\mathcal{T})$:
$$ \mathcal{G}_h(\mathcal{T})=\bigcup_{v \in \mathcal{T}} \mathcal{S}_h(v)=\left\{\bigcup_{v \in \mathcal{T}} \mathcal{V}_v^h, \bigcup_{v \in \mathcal{T}} \mathcal{E}_v^h, \bigcup_{v \in \mathcal{T}} \mathcal{R}_v^h\right\} \quad \text{NOI中所有节点的局部子图共同构成} $$
NOI prompt node:定义NOI prompt node,该节点的文本信息用来描述任务,比如某个数据集上的节点分类、图分类等。NOI prompt node的节点text feature以如下形式构建:
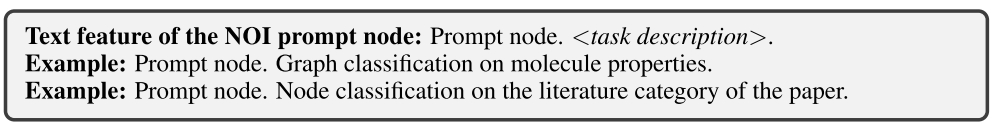
NOI prompt node的节点特征以 “Prompt node.” 开头,该节点的文本表述为需要在NOI上进行的task,如果需要对NOI做node classification,那么Prompt node的文本特征为:“Node classification on the literature category of the paper.”。通过这种方式,即使是图上任务有不同,只需要用不同的NOI prompt node就可以描述不同的任务。
Graph In-Context Learning的图提示范式(Graph Prompting Paradigm)
LLM的一大特性就是它可以通过prompt来实现in-context learning,使得模型可以在不用fine-tuning的情况下适应于不同的任务。比如在few-shot场景下,目标是基于一篇paper的摘要和内容预测它的类别,我们可以为LLM提供每个类别的 $k$篇papers作为context加入prompt中,来指导模型基于这些提供的context来生成目标摘要和内容的类别预测。(通过一些任务相关的其他信息来指导模型对目标样本的预测)
本文发现实现图上in-context learning的核心在于操作输入图使其和下游任务对齐。Graph Prompting Paradigm (GPP) 即图提示范式旨在操作输入图使其可以从输入数据本身获得任务相关的信息。如图2中的虚线所示,用来描述任务的NOI prompt node与所有NOI node建立连接(任务的目标节点),表示在这些NOI nodes上执行对应prompt的任务(如节点分类,链路预测,图分类等)。
Zero-shot Learning: 对于一个NOI $q$,若是节点分类任务 $q$是一个节点;若是边分类任务 $q$是一条边的两端节点;若是图分类任务, $q$是图中的所有节点,如Figure 2中的蓝色节点所示。 $q$中节点构成的局部子图,即NOI subgraph 表示为 $\mathcal{G}^q_h (\mathcal{T}^q) = (\mathcal{V}^h_q, \mathcal{E}^h_q, \mathcal{R}^h_q)$。
对于一个NOI subgraph $\mathcal{G}^q_h (\mathcal{T}^q)$, 该子图的NOI的任务可能是节点级任务也可能是边级或图级任务,根据该NOI subgraph的目标任务不同,将对应任务的NOI prompt node $p_q$与该NOI subgraph中的所有NOI节点 $q$相连。如Figure 2中的虚线所示,任务描述节点NOI prompt node与该任务的目标节点用虚线相连。
除此之外,定义class node与NOI prompt node相连,class node用于描述NOI prompt node的分类任务的类别信息,有多少个类别就有多少个class nodes。最终可以得到所有NOI的prompt graph,如Figure 2的左边框中3个prompt graph所示。用同一个GNN模型来训练不同分类任务的Prompt Graph (任务仅仅通过NOI prompt nodes 和class nodes来做区分)。在半监督训练完成后,我们可以得到一个GNN模型,3种任务的NOI prompt nodes的embedding,以及每种任务的class nodes的embedding,以及一个从embedding映射到label的MLP。对于一个新的节点/边,首先提取他的NOI subgraph,如Figure 2的彩色框中所示,然后将新的NOI nodes连接到NOI prompt nodes,再将NOI prompt nodes连接到任务的class nodes。先用训练好的GNN应用在这个新的prompt graph上,然后可以得到每个class node的embedding, 再用训练好的MLP将class node embeddings映射到label space,从而得到该NOI属于不同类别的概率。