在llm里面,In-Context Learning就是用一些新任务的问答例子来提示LLM,使得LLM不需要更新参数,也能基于这些例子来对新的任务生成输出。
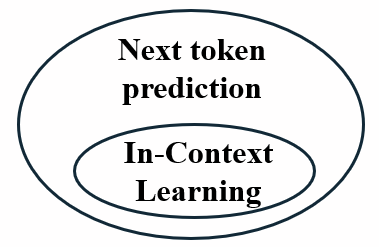
为LM的预训练任务实际上是next token prediction的任务,由于prompt和回答只是相邻的tokens,因此 Transformer 的自注意力可以计算要补全的句子和之前token之间的关系,从而让模型动态推断出新的决策规则。In-Context Learning实际上也是一种next token prediction的任务,所以In-Context Learning是和预训练任务相关的。
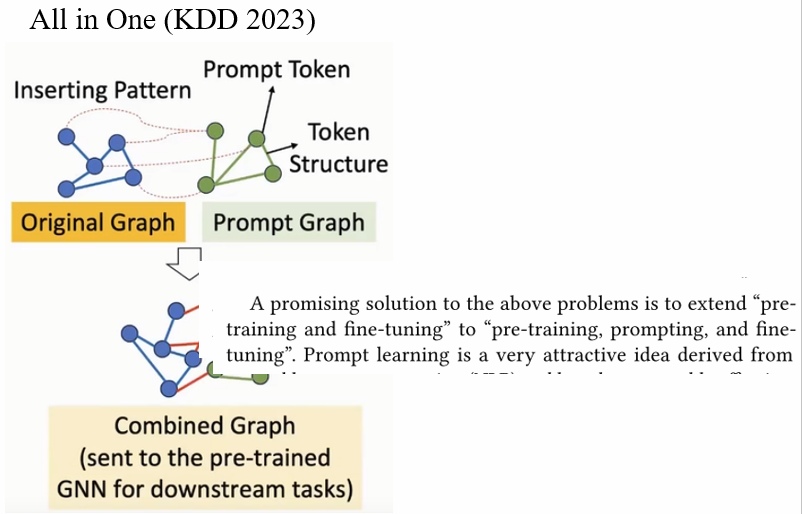
Prodigy和All in One (KDD 2023)是同期工作,目的都是为了去提示Pretrained graph model。 All in One 是已经有一个Pretrained graph model,然后用meta learning基于冻结的pretrained model,去学一个prompt graph,使得这个prompt graph和原图结合起来之后可以使预训练模型泛化到新的任务上。
All in One 存在的问题是,All in one要对测试图做finetune。但实际上我们知道foundation model是不需要fine tune的。遇到一个新任务,因为支持in-context learning,可以基于给出的prompt example 来对新任务直接做出预测。而Prodigy就是不需要fine tune的graph prompt方法,它是直接以in-context learning的方式来预训练模型。Prodigy在预训练图上构造一堆prompt example和queries,预训练的优化目标是使在给定prompt examples和query set的情况下,query set的预测损失最小,也就是说模型的参数由prompt examples来调整,优化目标是使得query set的损失最小。
Prompt Graph Representation
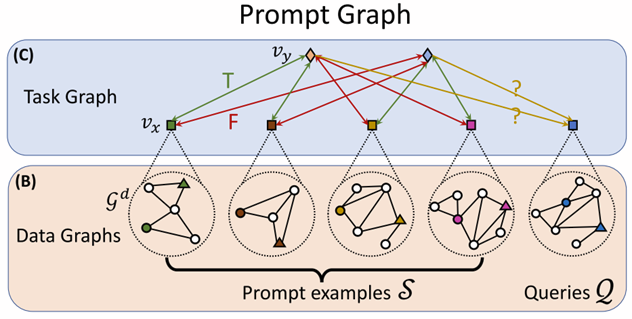
首先要基于预训练的图构造一个支持in-context learning的prompt graph。然后在这个prompt graph上以in-context learning的方式来预训练模型。具体来说,在预训练图上构造一个 $m$-way $k$-shot的分类任务。预训练图为MAG240M,该图中有122M个节点,1.3B条边,153个类。 在每次训练epoch中,采样 $m=30$个class,每个class选择 $k=3$个样本作为prompt examples $\mathcal{S}$,也就是每个epoch有90个prompt examples。每个类别取4个样本作为query set $\mathcal{Q}$。也就是 $\mathcal{S} = \{(x_i, y_i)\}^{mk}_{i = 1}$ 作为预训练阶段的support set。 $\mathcal{Q} = \{x_i\}^n_{i = 1}$作为预训练阶段的query set,也就是预训练阶段的优化目标是要在query set上的损失最小。
Data Graphs:若预训练任务是node-level的任务,那么每个数据点集 $\mathcal{V}_i$是一个目标节点,如果是edge level的任务,那么每个数据点集 $\mathcal{V}_i$是一对节点。然后,通过采样每个数据点集的 $k$跳局部子图来contextualize每个数据点集,从而为所有prompt examples和query set构造Data Graphs: $$ \mathcal{G}_i^{\mathrm{D}}=\left(\mathcal{V}_i^{\mathrm{D}}, \mathcal{E}_i^{\mathrm{D}}\right) \sim \bigoplus_{i=0}^k \operatorname{Neighbor}\left(\mathcal{V}_i, \mathcal{G}, i\right) $$
Message Passing on Data Graphs:然后每个Data Graph有一个Super Node $v_{x_i}$,来得到上下文化的目标节点表示。具体来说,在Data Graph上做message,然后把目标节点的embedding拿出来作为super node的node feature。
Task Graph:在每次预训练迭代中,有30个class参与预训练,那么就有30个label nodes $v_y$。然后将所有super nodes和label nodes 连接起来,用边来反映数据点和label之间的关系,具体来说,每条边的特征有2个binary value构成,如果目标数据点是来自prompt set的节点,那么第一个属性为 $0$,如果是来自query set的数据点,那么第一个属性为 $1$。在task graph中,每个超节点和所有label node连接,如果prompt example的超节点连接到正确的label node,那么第二个属性为 $1$,如果连到错误的label,那么边的第二个属性为 $-1$。
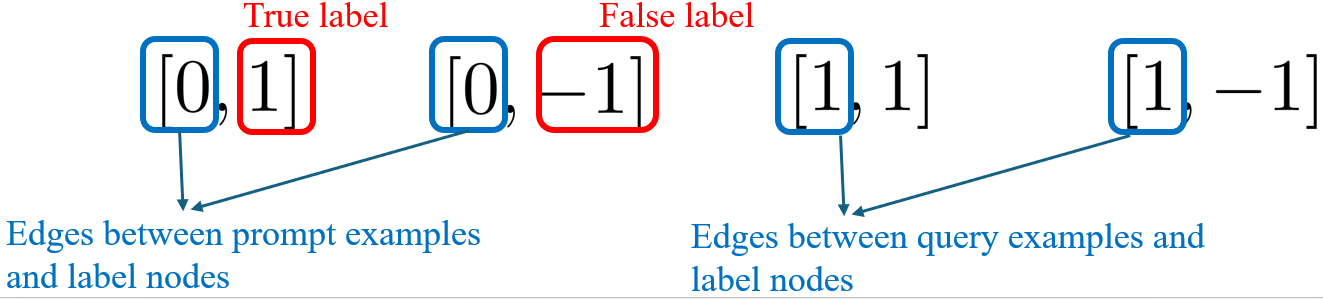
Message Passing on Task Graph:在得到每条边的feature $e_{ij}$后,在Task Graph上做attention-based message passing。也就是每个label node要聚合所有super nodes,每个super nodes也要聚合所有label nodes。 $$ \begin{aligned}\beta_{i j} & =M L P\left(W_q^T H_i^l\left|\left|W_k^T H_j^l\right|\right| e_{i j}\right) \\ \alpha_{i j} & =\frac{\exp \left(\beta_{i j}\right)}{\sum_{k \in \mathcal{N}(i) \cup{i}} \exp \left(\beta_{i k}\right)} \\ H_i^{l+1} & =\operatorname{ReLU}\left(B N\left(H_i^l+W_o^T \sum_{j \in \mathcal{N}(i) \cup{i}} \alpha_{i j} W_v^T H_j^l\right)\right)\end{aligned} $$
Pretraining Task Generation
2个预训练任务:Neighbor Matching和Multi-Class Classification。
Neighbor Matching:在每次training epoch,随机采样 $m=30$个节点作为 $30$个way,然后每个采样的节点选择 $k=3$个邻域内节点作为这个类的prompt examples。然后所有label nodes的特征从Uniform distribution上初始化:
$$ \begin{gathered}\mathcal{C}=\left\{c_i\right\}_{i=1}^m \quad c_i \sim \operatorname{Uniform}\left(\mathcal{V}_{\text {pretrain }}\right) \\ N_i=\text { Neighbor }\left(c_i, \mathcal{G}_{\text {pretrain }}, l\right) \\ \mathcal{S}_i=\left\{\left(x_j, y_j=c_i\right)\right\}_{j=1}^k \quad x_j \sim \operatorname{Uniform}\left(N_i\right) \\ \mathcal{Q}_i=\left\{\left(x_j, y_j=c_i\right)\right\}_{j=1}^{\left\lceil\frac{n}{m}\right\rceil} \quad x_j \sim \operatorname{Uniform}\left(N_i\right)\end{gathered} $$
Multi-Class Classification:用原始label来构造预训练任务,label node的feature依旧从uniform distribution中采样:
$$ \begin{gathered}\mathcal{C}=\left\{c_i\right\}_{i=1}^m \quad c_i \sim \operatorname{Uniform}(\mathcal{Y}) \\ \mathcal{S}_i=\left\{\left(x_j, y_j=c_i\right)\right\}_{j=1}^k \quad x_j \sim \operatorname{Uniform}\left(\left\{x_i \mid f\left(x_i\right)=c_i\right\}\right) \\ \mathcal{Q}_i=\left\{\left(x_j, y_j=c_i\right)\right\}_{j=1}^{\left\lceil\frac{n}{m}\right\rceil} \quad x_j \sim \operatorname{Uniform}\left(\left\{x_i \mid f\left(x_i\right)=c_i\right\}\right)\end{gathered} $$
通过计算每个super node和所有label node的cosine similarity 来得到预测的logits:
$$ O_i=\left[\operatorname{cosine} \_ \text {similarity }\left(H_{x_i}, H_y\right), \forall y \in \mathcal{Y}\right] $$
模型的优化目标是在NM和MT这两个预训练任务的query set上的损失最小:
$$ \mathcal{L}=\underset{x_i \in \mathcal{Q}_{\mathrm{NM}}}{\mathbb{E}} \operatorname{CE}\left(O_{\mathrm{NM}, i}, y_{\mathrm{NM}, i}\right)+\underset{x_i \in \mathcal{Q}_{\mathrm{MT}}}{\mathbb{E}} \operatorname{CE}\left(O_{\mathrm{MT}, i}, y_{\mathrm{MT}, i}\right) $$