论文地址:SDNE
Introduction
这是一篇比较早的Network Embedding论文, 较早将深度模型应用到NE任务。 首先,本文提出了当前网络表示学习中遇到的三个问题:
(1). 高度非线性
(2). 尽可能保持网络结构
(3). 现实网络的高度稀疏性
SDNE的主要目标就是保持网络结构的一阶相似性和二阶相似性。
一阶相似性就是网络中边相连的节点对之间具有的相似性。
二阶相似性就是在一个Graph中,拥有共同邻居但是不直接向相连的两个节点具有的相似性。
其中,一阶相似性主要反映了网络的局部特征。 二阶相似性反映了网络的全局特征。
Model
本文的模型主要如下图所示:
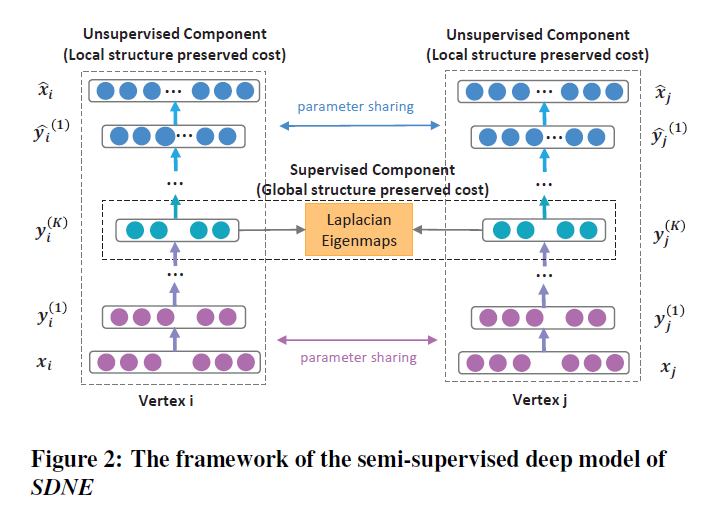
这张图看上去有点复杂,实则原理非常简单。
模型分为无监督部分和有监督部分,无监督部分是一个深度自编码器 用来捕获二阶相似度(保留全局结构),监督部分是一个拉普拉斯特征映射捕获一阶相似度(局部结构)。呃呃呃,Emmmmm ,不知道是我理解有问题还是其他原因,文章里说的和我理解的不太一样 /(ㄒoㄒ)/~~。 然后介绍一下具体的模型结构:
深度自编码器的编码部分:
$$y_i^{(k)}=\sigma{(W^{(k)}y_i^{(k-1)}+b^{(k)})}, k=2,…,K$$
假设第$k$层是 节点$v$的表示向量(仅考虑全局信息),那么从第$k$层开始解码,最终得到$\hat{x_i}$, 所以自编码器的误差就是输入节点$v$的邻接向量的重构误差。所以,二阶相似度损失函数定义为:
$$\mathcal{L}=\sum_{i=1}^n{||\hat{x_i}-x_i||^2_2}$$
值得注意的是,由于网络的稀疏性,邻接矩阵中的0元素远多于非0元素,使用邻接矩阵作为输入的话要处理很多0,这样就做了太多无用功了。为了解决这个问题,对损失函数做了改进如下:
$$\mathcal{L_{2nd}}=\sum_{i=1}^n||(\hat{x_i}-x_i)\odot{b_i}||^2_2=||\hat{X}-X\odot{B}||^2_F$$
其中$\odot$是哈马达乘积,表示对应元素相乘。$b_i={b_{i,j}}^n_{j=1}$, 邻接矩阵中的0对应$b=1$, 非0元素的$b>1$,这样的目的是对于有边连接的节点增加惩罚。可以理解为对有边连接的节点赋予更高权重。
以上我们获得了二阶相似度的损失函数。在介绍一阶相似度之前,我们先来看看拉普拉斯映射(Laplacian Eigenmap) 其实LE也是一种经典的NRL方法,主要目的也是降维。其目标函数如下所示:
$$\sum_{i,j} W_{ij}||y_i-y_j||^2$$
LE是通过构建相似关系图来重构局部特征结构,如果放在网络结构中来说,如果节点$v_i$和$v_j$很接近(有边),那么他们在embedding space中的距离也应该相应接近。$y_i$和$y_j$就表示他们在特征空间中的表示。因此,本文定义了保持一阶相似度的目标函数:
$$\mathcal{L_{1st}}=\sum_{i,j=1}^n{s_{i,j}||y_i^{(K)}-y_j^{(K)}||^2_2}=\sum_{i.j=1}^n{s_{i,j}||y_i-y_j||^2_2}$$
具体来说,$K$就是自编码器第$K$层的输出,即编码结果,需要保持一条边的两个节点在嵌入空间中的表示相对接近。
最终 结合一阶相似度和二阶相似度,本文给出了SDNE的目标函数:
$$\mathcal{L_{mix}}=\mathcal{L_{2nd}+\alpha{\mathcal{L_{1st}}}}+\nu{\mathcal{L_{reg}}}
=||(\hat{X}-X)\odot{B}||^2_F+\alpha{\sum_{i.j=1}^n{s_{i,j}||y_i-y_j||^2_2}}+\nu{\mathcal{L_{reg}}}$$
其中,为了防止过拟合,添加了$\mathcal L2$-norm单元$\mathcal{L_{reg}}$来防止过拟合:
$$\mathcal{L_{reg}}=\frac{1}{2}\sum_{k=1}^k({||W^{(k)}||^2_F+||\hat{W}^{k}||_F^2})$$
Optimization
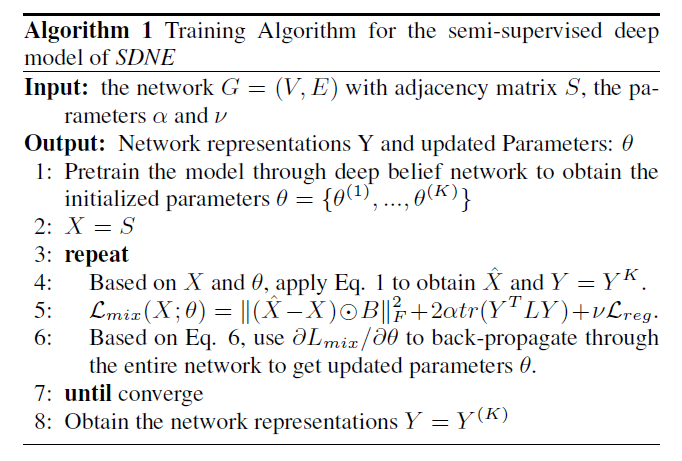
使用SGD来优化$\mathcal{L_{mix}}$。具体算法如下: