Introduction
无监督图学习算法基于重构损失,不可避免的需要图相似度计算(重构embedding和输入embedding的loss), 计算复杂度较高。本文提出一种通用的归纳式无监督图学习算法SEED(Sampling, Encoding, and Embedding Distributions)。通过计算采样子图的重构损失来代替整个图的重构损失。 即 先采样子图,在用GNN编码子图,最后计算子图分布的embedding来作为整个图的representation. 过程如下图所示:
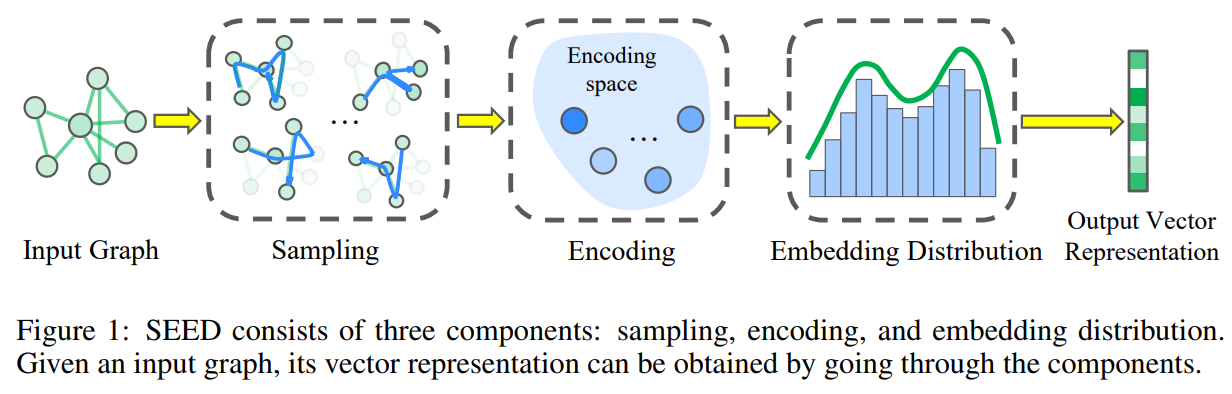
SEED: Sampling, Encoding, and Embedding Distributions
Anonymous Random Walk
Definition 1 (Random Anonymous Walks[1]): Given a random walk $\mathbf{w}=(w_1, \cdots, w_l)$ where $\langle w_i, w_{i+1} \rangle \in E$, the anonymous walk for $\mathbf{w}$ is defined as: $$ \mathrm{aw}(\mathbf{w}) = (\mathrm{DIS}(\mathbf{w}, w_1),\mathrm{DIS}(\mathbf{w}, w_2),\cdots, \mathrm{DIS}(\mathbf{w}, w_l) ) $$ where $\mathrm{DIS}(\mathbf{w}, w_i)$ denotes the number of distinct nodes in $\mathbf{w}$ when $w_i$ first appears in $\mathbf{w}$, i.e. $$ \mathrm{DIS}(\mathbf{w}, w_i) = |{w_1, \cdots w_p}|, \quad p = \min_j {w_j=w_i} $$ 匿名随机游走和随机游走的不同在于,匿名随机游走描述了随机游走的潜在“patterns”, 不管具体被访问的节点是什么。 距离来说,给定两条随机游走序列 $\mathbf{w_1}=(v_1, v_2, v_3, v_4, v_2)$ 和$w_2=(v_2, v_1, v_3, v_4, v_1)$, 这两个RW相关联的匿名随机游走是一样的,即$\mathrm{aw}(\mathbf{w_1}) = \mathrm{aw}(\mathbf{w_2}) = (1,2,3,4,2)$, 即使$\mathbf{w_1}$和$\mathbf{w_2}$访问不同的节点。即每个节点在RW中首次被访问时的位置就是这个点在ARW中的id,如在$\mathbf{w_2}$中,$v_1$首次访问是在第二个时刻,那么他的id就是2,在ARW中用2表示。
Sampling
本文提出WEAVE随机游走来表示子图
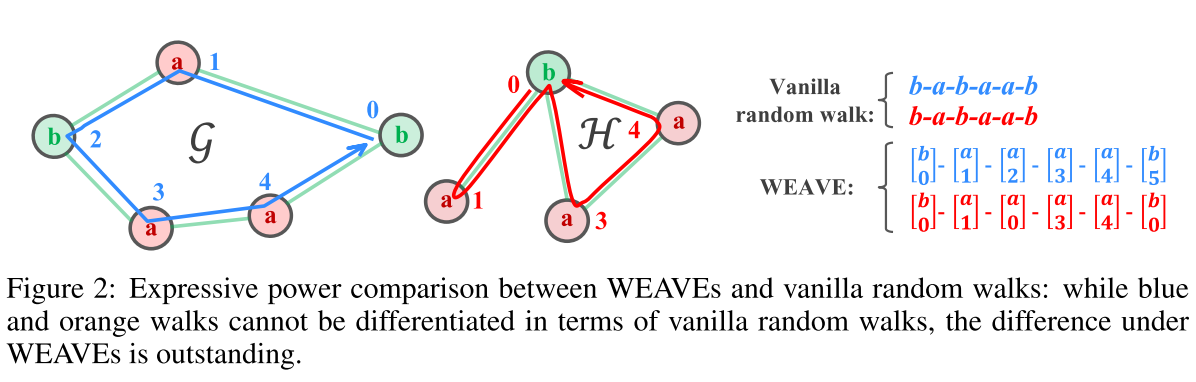
上图中所有的$a$代表属性一样的节点, 所有的$b$也代表属性一样的节点,那么构造如图中两条vanilla random walks将得到两条完全相同的随机游走序列,因为序列中的节点属性排列完全一样(这里不会去构造induced subgraph)。为了可以区分两个图,提出了WEAVE, i.e., random Walk with EArliest Visit timE。实际上就是为每个随机游走序列上的节点拼接他在匿名随机游走序列中的index。这样就可以区分两个属性完全一样的随机游走序列。
简单来说这种方法会记录节点首次被访问的时间,这个时间作为节点的index,从而随机游走序列可以反映子图结构。
一个长度为$k$的WEAVE序列可以表示为:$X=\left[\mathbf{x}^{(0)}, \mathbf{x}^{(1)}, \cdots, \mathbf{x}^{(k)}\right]$, 其中$\mathbf{x}^{(p)}$是序列上的第$p$个节点, $\mathbf{x}^{(p)}=\left[\mathbf{x}_{a}^{(p)}, \mathbf{x}_{t}^{(p)}\right]\in \mathbb{R}^{k \times (d+\ell)}$, 是两个向量的拼接,$\mathbf{x}_{a}^{(p)} \in \mathbb{R}^d$代表这个节点的node feature, $ \mathbf{x}_{t}^{(p)} \in \mathbb{R}^\ell$是是节点在匿名随机游走中的idx, 用onehot向量表示(即该节点首次被访问的时间)。
最终,如果要从输入图中sample $s$条随机游走路径,将会生成$s$个子图,用矩阵表示为$\left\{X_{1}, X_{2}, \ldots, X_{s}\right\}$。
Encoding
用$s$个随机游走序列表示$\mathcal{G}$的$s$个子图。对每个子图使用auto encoder 计算embedding: $$ \mathbf{z}=f\left(X ; \theta_{e}\right), \quad \hat{X}=g\left(\mathbf{z} ; \theta_{d}\right) $$ 其中$X$表示一个子图(WEAVE), 先用$f_{\theta_e}$得到这个子图的pooling embedding, 在用$g_{\theta_d}$将子图的embedding重构为矩阵$\hat{X}$。每个子图的重构损失为: $$ \mathcal{L}=||X-\hat{X}||_{2}^{2} $$ 通过对每个子图的$\mathcal{L}$做SGD来优化$\theta_e$和$\theta_d$来使得重构误差最小。 最终对于图$\mathcal{G}$我们可以得到它的$s$个子图表示:$\left\{\mathbf{z}_{1}, \mathbf{z}_{2}, \cdots, \mathbf{z}_{S}\right\}$.
Embedding Distribution
假设我们已经有了输入图$\mathcal{G}$的子图表示向量集$\left\{\mathbf{z}_{1}, \mathbf{z}_{2}, \cdots, \mathbf{z}_{S}\right\}$, 要将他们融合成一个embedding来表示整个图。可以把这个图的子图集合看做一个distribution,每个子图是这个distribution中的一个样本。 如果两个Graph的子图分布相似,那么这两个Graph的相似度应该更高。 所以目标就变为,给定两个图$\mathcal{G}$和$\mathcal{H}$, 他们的子图表示分别为$\left\{\mathbf{z}_{1}, \mathbf{z}_{2}, \cdots, \mathbf{z}_{s}\right\}$和$\left\{\mathbf{h}_{1}, \mathbf{h}_{2}, \cdots, \mathbf{h}_{s}\right\}$。这是两个分布的样本,我们要计算两个分布的距离,本文使用MMD, 目的是求两个分布的distribution embeddings, 然后求两个distribution embeddings间的距离。MMD可以参考这里。
用$P_{\mathcal{}G}$和$P_{\mathcal{H}}$分别表示这两个图的子图分布, 两个分布之间的MMD距离可以用下式计算得到。 $$ \begin{aligned} \widehat{MMD}\left(P_{\mathcal{G}}, P_{\mathcal{H}}\right)=& \frac{1}{s(s-1)} \sum_{i=1}^{s} \sum_{j \neq i}^{s} k\left(\mathbf{z}_{i}, \mathbf{z}_{j}\right)+\frac{1}{s(s-1)} \sum_{i=1}^{s} \sum_{j \neq i}^{s} k\left(\mathbf{h}_{i}, \mathbf{h}_{j}\right) \\ &-\frac{2}{s^{2}} \sum_{i=1}^{s} \sum_{j=1}^{s} k\left(\mathbf{z}_{i}, \mathbf{h}_{j}\right) \\ =&\left|\left|\hat{\mu}_{\mathcal{G}}-\hat{\mu}_{\mathcal{H}}\right|\right|_{2}^{2} . \end{aligned} $$ 该式表示的含义为,两个图中的样本$\left\{\mathbf{z}_{1}, \mathbf{z}_{2}, \cdots, \mathbf{z}_{S}\right\}$和$\left\{\mathbf{h}_{1}, \mathbf{h}_{2}, \cdots, \mathbf{h}_{s}\right\}$分别映射到一个RKHS空间中,两组样本在这个RKHS空间中的均值来表示这两个分布。即: $$ \hat{\mu}_{\mathcal{G}}=\frac{1}{s} \sum_{i=1}^{s} \phi\left(\mathbf{z}_{i}\right), \quad \hat{\mu}_{\mathcal{H}}=\frac{1}{s} \sum_{i=1}^{s} \phi\left(\mathbf{h}_{i}\right) $$ 其中$\phi(\mathbf{z}_{i})$,$\phi(\mathbf{h}_{i})$分别表示 将向量$\mathbf{z}_{i}$和$\mathbf{h}_{i}$ 映射到一个RKHS中,所以$\phi(\cdot)$是一个kernel $k(\cdot, \cdot)$的feature map函数, i.e., $k(u,v) = \langle \phi(u), \phi(v) \rangle$。$\phi(u) = k(\cdot, u)$是kernel $k$对应RKHS中的一个函数(向量)。 所以只要确定一个kernel $k(\cdot, \cdot)$,上面的$\widehat{MMD}(P_{\mathcal{G}}, P_{\mathcal{H}})$就可以求出确定值,表示两个distribution间的距离。 但是知道两个分布在RKHS中的距离还不够,需要知道这两个分布的在RKHS间的均值距离还不够, 我们需要知道这两个分布在RKHS中被映射成了什么向量,即我们要求$\phi(\cdot)$。
假设我们已经有了一个kernel, 这个kernel对应的映射函数是一个恒等映射,那么$\phi(u)=u$, 分布样本在RKHS中的表示就是他们本身,即 $\phi(\mathbf{z}_{i})=\mathbf{z}_{i}$, $\phi(\mathbf{h}_{i})=\mathbf{h}_{i}$。那么这分布的表示向量就是他们的样本在RKHS上的平均(均值平均误差): $$ \hat{\mu}_{\mathcal{G}}=\frac{1}{s} \sum_{i=1}^{s} \mathbf{z}_{i}, \quad \hat{\mu}_{\mathcal{H}}=\frac{1}{s} \sum_{i=1}^{s} \mathbf{h}_{i} $$ 如果$k$是一个其他通用kernel, 比如RBF kernel, 那么$k(u,v) = \langle \phi(u), \phi(v) \rangle$这里的$\phi(\cdot)$是不知道的,也就是仅能知道映射后的内积值,不能知道具体的映射是什么,为了求这个映射,本文用神经网络来近似这个映射。
具体来说,定义$\hat{\phi}\left(\cdot ; \theta_{m}\right)$是一个参数为$\theta_{m}$的MLP, 输入为分布的样本,那么用这个函数来对两个分布的样本$\{\mathbf{z_i}\}$和$\{\mathbf{h_i}\}$做映射, 然后用$\hat{\phi}\left(\cdot ; \theta_{m}\right)$来近似kernel真实的映射函数$\phi(\cdot)$。即: $$ \hat{\mu}_{\mathcal{G}}^{\prime}=\frac{1}{s} \sum_{i=1}^{s} \hat{\phi}\left(\mathbf{z}_{i} ; \theta_{m}\right), \quad \hat{\mu}_{\mathcal{H}}^{\prime}=\frac{1}{s} \sum_{i=1}^{s} \hat{\phi}\left(\mathbf{h}_{i} ; \theta_{m}\right), \quad D\left(P_{\mathcal{G}}, P_{\mathcal{H}}\right)=\left|\left|\hat{\mu}_{\mathcal{G}}^{\prime}-\hat{\mu}_{\mathcal{H}}^{\prime}\right|\right|_{2}^{2} $$ 上式中的$D\left(P_{\mathcal{G}}, P_{\mathcal{H}}\right)$表示两个分布中的样本在被$\hat{\phi}\left(\cdot; \theta_{m}\right)$映射后的均值误差。用这个均值误差来近似$\widehat{MMD}(P_{\mathcal{G}}, P_{\mathcal{H}})$中由kernel $k$的映射$\phi(\cdot)$算出的Ground truth均值误差:
$$J\left(\theta_{m}\right)=\left|\left|D\left(P_{\mathcal{G}}, P_{\mathcal{H}}\right)-\widehat{M M D}\left(P_{\mathcal{G}}, P_{\mathcal{H}}\right)\right|\right|_{2}^{2}$$
通过最小化$J\left(\theta_{m}\right)$,来优化$\hat{\phi}\left(\cdot; \theta_{m}\right)$,使其近似称为一个kernel的feature map函数, 即可以将样本映射到一个RKHS空间中的函数。
训练结束后,用$\hat{\mu}_{\mathcal{G}}^{\prime}$来表示输入图$\mathcal{G}$的最终embedding (子图分布embedding)。
Reference
[1] Micali, S., and Zhu, Z. A. 2016. Reconstructing markov processes from independent and anonymous experiments. Discrete Applied Mathematics 200:108–122.